本週 · 電子報 10 月 26 日
Epoch 拿真實工作考模型 領先者平均 65% 判失敗
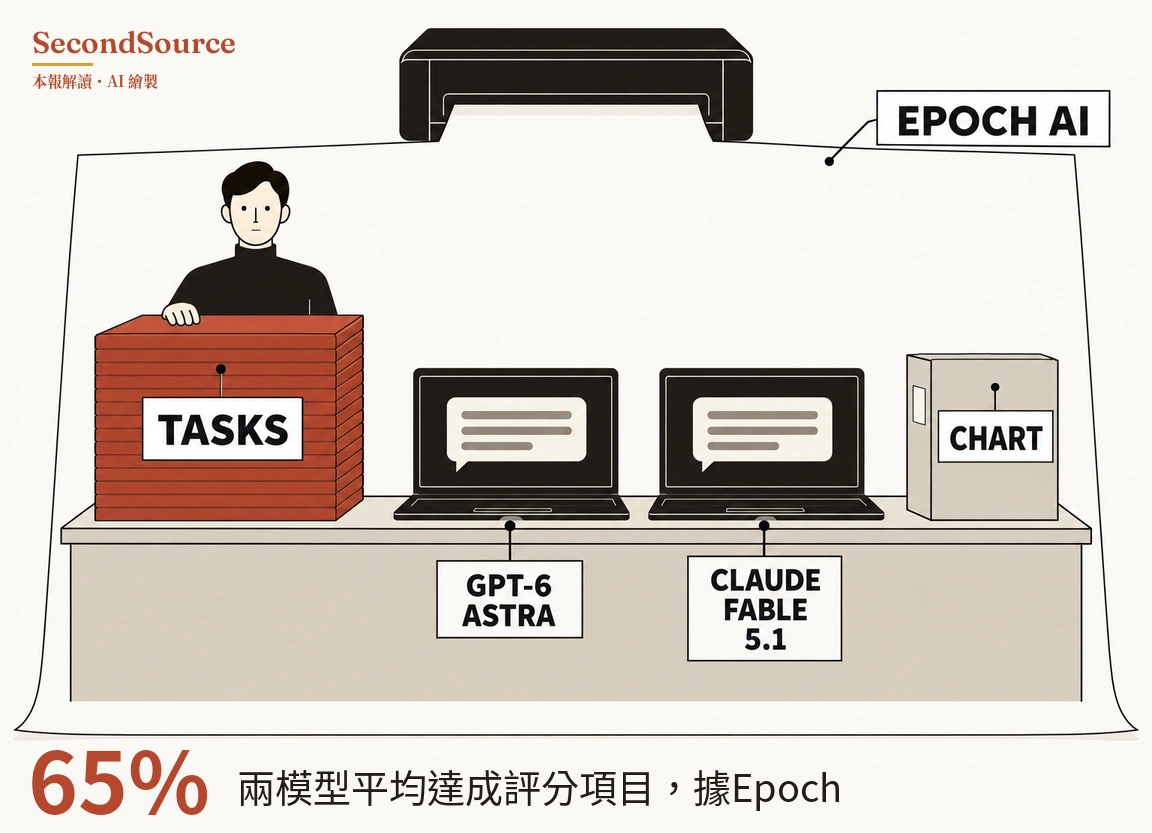
Epoch 用自家 11 項工作考六個 AI 模型,領先的兩個平均達到人類員工評分項目的 65%,Epoch 判 65% 仍是失敗
為什麼重要: 分數高不等於能交出去,先真正交給 AI 的是一次做對、對錯一看就知的圖表任務。
Epoch AI 10 月 26 日發布電子報〈我們試著自動化 Epoch〉。Epoch AI 是追蹤 AI 算力、能力與趨勢的獨立研究機構。這篇摘要 Epoch 自家的自動化報告:拿 Epoch 員工的 11 項真實工作當題目,讓六個領先模型各做一次、沒有人協助,再用對人類員工的同一套評分項目表逐項打分。電子報文字只點名兩個領先者 Claude Fable 5.1 與 GPT-6 Astra,兩者平均達到評分項目的 65%,電子報文字沒列其餘四個模型的名字與分數(Epoch AI,2026-10-26)。Epoch 的門檻是 100% 才算可以交給 AI,原文寫「A 65% score is still a failed task」,照這個門檻,同樣的成品若由人交出,也過不了關。模型在寫程式、資料分析這類明確任務做得好,在要從範例抓規律、要下判斷的開放式任務做得差:在一項要 AI 獨立設計並執行先導實驗的任務裡,GPT-6 Astra 替要評估的模型設了太低的 token 預算,22% 的執行回不了答案。GPT-6 Astra 接著把這些失敗當成模型能力的重要發現,沒看出是實驗設定本身錯了。另一端,一項基本圖表任務已從題目移除,因為 Fable 5.1 多數時候一次就能做出可接受的圖,Epoch 的日常工作已部分把這一步交給 AI。
還不能當真: 六個模型只點名兩個,65% 是那兩個的平均 怎麼查的 →
判斷更新: 這和本報「有標準答案、對錯一看就知的任務先被 AI 接管,開放式判斷留在人手上」的方向一致。AI 能不能接手某個職能,關鍵在人看一遍、改到可交的成本,是否低於由人從頭做。這是本報的判準,電子報沒有量這個成本。Epoch 的例子落在兩端:一項圖表任務因 Fable 5.1 多數時候一次做對而移出題目,GPT-6 Astra 則沒看出實驗設定本身錯了。下一個要看的是 Epoch 下一次更新有幾項任務達到 100%,電子報沒寫下次更新的時間。
對答案: 本報 10 月 22 日押:OpenAI 下一張前沿模型系統卡,仍只會說明模型照指令改寫推理草稿的能力怎麼變,不會解釋模型不寫草稿也能推理的能力為何大增。推理草稿是模型作答前寫出的中間推演。10 月 26 日的 GPT-6.1 Terra 系統卡兩件都沒說明原因,所以這個押注判不出對錯(GPT-6.1 Terra 系統卡,2026-10-26)。上一張系統卡寫過,改寫能力的變化不是架構改動造成的,這次那句也拿掉了。卡片 →
出處與查證
這則刊在2026年10月28日的晨報,同一期還有 15 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈Epoch 拿真實工作考模型 領先者平均 65% 判失敗〉,https://secondsource.io/news/2026-10-28-2/,取用日期取用。