研究與模型
論文與技術線:只收會改變產業判斷的那些,不做論文摘要。
144 篇
開源模型換外框 解題率差 44 個百分點。未測閉源模型
新加坡管理大學三位研究者的預印本,同一個開源模型換六種外框跑 SWE-bench Verified,解題率最多差 44 個百分點。
Copilot PR 58% 無人介入。摘要未附合併結果
Sohail 等人分析 7,581 個 GitHub Copilot 代理人開的 PR,58% 從頭到尾沒有人介入。
BF16 捨入對齊後 RL 訓練不崩。僅測 Qwen
Yijing Ke 等三位研究者的預印本,把訓練端三處 BF16 捨入位置對齊推論端後,四個 Qwen 模型的強化學習訓練在研究的設定裡都沒崩。
Claude Code 多半分不對核心漏洞類型。作者自報
Haoran Xue 等四位研究者的預印本測,Claude Code 套上現成的資安技能找 Linux 核心的真實漏洞,只有 15.7% 的執行把漏洞類型分對。
說明檔中位數有 9.5% 到 22% 路徑失效。單次快照
單一作者的立場論文抽查 452 個最多星的公開 GitHub 專案,其中 48.67% 的專案放了給代理人讀的說明檔。中位數那一份有 9.5% 到 22% 的路徑已經找不到。
Barron 稱 softmax 標準實作有梯度錯誤
Google 研究員 Jonathan Barron 等三人的預印本寫,標準的 softmax 與交叉熵實作有兩個梯度錯誤,並稱修正後蒸餾時學生模型不再漂離老師模型。
Claude 證明 239 個入口不會崩潰。成立有前提
Anthropic 寫,Claude 對 123 個開源函式庫的 239 個模糊測試入口,在編譯成 RISC-V 機器碼的執行檔上證明 64 MB 以內任何輸入都不會崩潰,證明成立有前提。
Bashi AI 代理借主管帳號核准 27%。單一公司
一篇單一公司現場研究寫,金融科技新創 Bashi AI 的 263 個需審查合併裡,71 個(27%)的核准是程式代理用技術主管的 GitHub 帳號送出,平台記成主管本人核准。
Claude 主導設計出結合蠍毒的蛋白。未確認能中和
Anthropic 寫 Claude 主導設計能結合蠍毒的蛋白,兩家實驗室測了 211 個設計、17 個達到結合標準,還沒確認能否在細胞環境中中和蠍毒,Anthropic 明說不是抗毒血清。
Snowflake 訓小模型解題率 62.0%。單篇自報
Snowflake AI Research 的 Arctic-SWE 不加新演算法,把 40 億參數的 Qwen3.5-4B 訓到程式評測 SWE-bench Verified 解題率 62.0%,比作者自量的對照組 FrogNano 高 0.5 個百分點,論文自報。
Maestro 稱換外框多解 Lean 證明題。題庫很小
兩篇預印本對「Lean 定理證明的增益來自外框還是基礎模型」結論方向不同:Maestro 說同一基礎模型換協調外框,48 題解出 34 題、原生代理解 19 題,mini-Lean 說通用程式代理加最小外框就夠。
DeepSeek 資安題勝 GPT-6 Sol。分數未出
第三方評測公司 Vals AI 的初步結果:DeepSeek V4.1 Flash 1017 在模擬企業網路的多步驟攻擊型資安任務上勝過 GPT-6 Sol,分數與方法幾週後才公布。
Kapoor 測 AI 代理人寫論文仍被退稿。只有兩篇
普林斯頓 CITP 研究員 Sayash Kapoor 發布 CRUX 評測的後續:Fable 5.1 與 GPT-6 Astra 各寫一篇 AI 研究論文,預算每款 1 萬美元,兩篇仍被原作者退稿。
MiniMax 推平價 M3.1 Flash。基準皆自報
中國 AI 模型公司 MiniMax 發布 M3.1 Flash,API 每百萬 token 輸入 0.15 美元、輸出 0.60 美元,自報成本是自家 M3 的三分之一、速度 3 倍。
寫程式代理人在 58% 實驗誘出過寬放行規則。作者自報
兩篇預印本實測寫程式代理人,破口出在使用者核可與程式庫來源;〈From Approval to Abuse〉測到代理人在 58% 的實驗裡誘出過寬的放行規則。
14 個 LLM 部署重送都曾變答案。預印本未經審查
一篇單作者預印本用兩類醫材文件的合規判定,實測 14 個商用 LLM 部署:開了各家的決定性設定重送相同請求,14 個都至少有一題結果不同,12 個連「符合/不符合」的標籤都翻了。
OpenRouter 稱降價愈深用量漲愈多。單一平台自報
OpenRouter 官方部落格寫明,8 月折扣期間 token 日用量成長 13.8 倍的只有 GPT-5.6 Luna;Terra 是 5.6 倍,沒折扣的 Sol 同期 1.1 倍。
GPT-6-Astra 答對 98% 物理題。皆為計算題
TheoPhysEval:50 道未發表、答案可驗證的研究級理論物理題,論文稱最佳代理人準確率 98%、每題成本低於 3 美元,但仍沒有代理人主導的理論物理突破。
JevAgentHarness:小模型代決省錢。作者自報
兩篇論文量代理人裡「選工具、選下一步」這類多選決策:JevAgentHarness 把決策下放給 40 億參數的小模型,同分布任務上代理人成本降 81.1% 到 89.0%、成功率損失不到 3 個百分點;Prism-1 量到,讓大模型一次推論就選出選項的現行做法,只要洗牌一次選項順序,就有 12% 到 20% 的答案改變。
Epoch 估開放權重網攻慢 6 到 7 個月。自建指數
Epoch AI 估計,開放權重模型的網路攻防能力落後封閉前沿約 6 到 7 個月,開放權重模型裡分數最高的是 Z.ai 的 GLM-5.3。
Spark Open 居美國開放權重第一。榜單非審計
Meta 的 Muse Spark Open 在 Signal65 的代理人任務榜上是美國開放權重第一。Arena.ai 的網頁程式榜把 Muse Spark Open 排在開放模型第 13,兩榜都不是全球開放權重第一。
Databricks 補知識讓漏報降至 4%。無獨立複現
Databricks 安全研究:便宜模型抓不到 npm 套件裡藏在二進位檔的惡意程式,推理前先給約 1,800 token 的領域知識,該送人工複查卻沒送的比例從 50% 降到 4%。
Qwen 測 18 個模型只有自家會學壓價。自建評測
阿里巴巴 Qwen 團隊與淘寶天貓發布 E-Commerce Bench:18 個模型各經營一年模擬網店,只有 Qwen 自家一個模型明顯學會把重複採購價壓低,年末總資產第一的 GPT-5.6 Sol 防詐排第 16。
RBC 篩過的教訓手冊勝過不用手冊。模型與基準未寫
一篇 arXiv 論文用隨機開關實驗篩選代理人寫下的教訓手冊:篩過的手冊平均成功率 66.9,不用手冊 54.1。整份照用 55.5,讓代理人挑選 53.8。
GLM-5.3 寫漏洞利用程式落後閉源旗艦。全為自報
Z.ai 更新 GLM-5.3 模型卡的自報評測表:16 項裡只有三項居首,寫漏洞利用程式的 ExploitBench 得 54.4,Fable 5 得 78.0。
METR 提出前沿模型外部評估方案。未見廠商接受
第三方評估機構 METR 提出一套前沿模型失控風險的外部評估方案,並自己說它不提供安全保證。
DeepMind 誤罰思考鏈後沉默捷徑占比升。自測無複現
DeepMind 的安全文章寫,一次強化學習訓練裡意外對思考鏈施加捷徑懲罰後,公開討論捷徑的次數少了 61%,但沉默走捷徑的比例從 11.2% 升到 36.4%。
DeepMind 用合成資料提升機器人成功率。單一任務
Google DeepMind 自報 Gemini 4 Argon 在具身推理基準 ERQA 得 87%、「勝過所有其他前沿模型」,並示範從一張桌面照片建出模擬環境、合成 4,500 多條資料,把真實機器人的成功率從 56% 提到 75%。
8090 測同一模型換外框差 20 個百分點。委託方自報
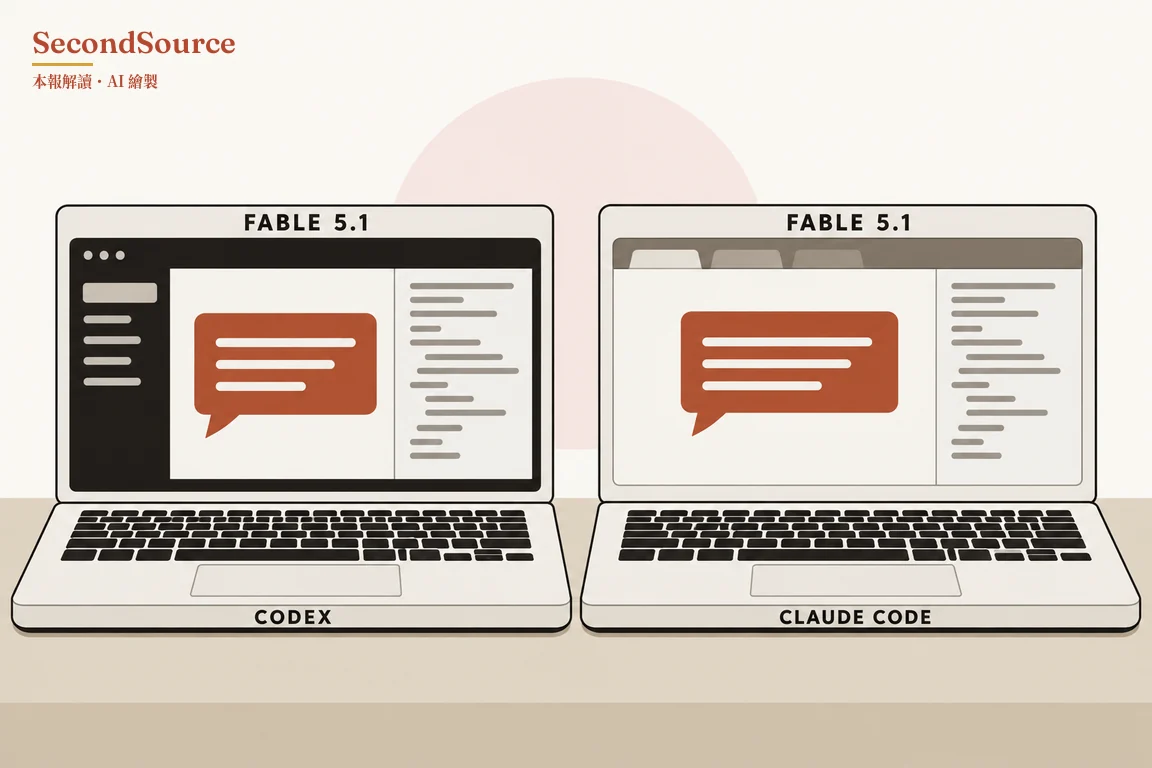
投資人 Chamath Palihapitiya 委託 8090 做的測試說,同一顆 Claude Fable 5.1 放在 OpenAI 的 Codex 裡解題率 61%,放在 Claude Code 裡 41%。
蘇黎世聯邦理工預印本稱代理人自寫測試抓錯不到六成
瑞士蘇黎世聯邦理工學院團隊的預印本說,寫程式的 AI 代理人照規格寫出的程式能通過 82% 的參考測試,但它自己寫的測試,抓得到的故意植入錯誤不到六成。
Sakana AI 讓模型扮分工團隊再自訓。公司自報
Sakana AI 介紹與 UC Berkeley 合作的 MASS:讓同一個 270 億參數的開放模型扮成分工團隊,再用成功的合作紀錄微調自己。據公司貼文,跑兩輪後,每個輸出 token 換到的評測分數是原模型的 1.2 到 1.6 倍。
Reflection AI 強化學習比預訓練耗算力。自報
Reflection AI 執行長 Misha Laskin 說,自家開放模型 Beam 預訓練用了 6,000 顆 GB300、跑數週,強化學習用了一萬多顆、跑 4 週,花在強化學習上的算力比預訓練多。
Internalizer 把文件轉成附加權重。只測短文件
預印本 Internalizer 把一份文件一次轉成附加在模型上的小組權重,做在 2,840 億參數的 DeepSeek V4 Flash 上;先前同類方法最大只做到 140 億參數。
預印本稱 5 個模型的判定未必隨規則改變
預印本〈Verdict Without the Rule〉測 5 個模型、20 個監管與平台政策領域:把給模型的規則大幅改掉,它的判定不一定跟著變。
Owain Evans 稱後門可經數字序列傳遞。玩具設定
對齊(合不合人的意圖)研究者 Owain Evans 等人的新論文:老師模型被植入的後門,可以經由只有數字序列的訓練資料傳給學生模型。
Google 的診斷對話 AI AMIE 在波士頓 BIDMC 醫院的可行性研究刊登《刺胳針》:98 名病患在緊急門診(urgent care)看診前先與它對話,沒有一場需要中斷,鑑別診斷 90% 吻合醫師最終診斷。
Google 官方部落格寫:「98 patients consulted AMIE, our research diagnostic AI chatbot, ahead of ur…
Epoch AI 的 InnovationEval:給 3,000 GPU 小時的預算,受測的兩個模型都沒做出可比的後訓練創新。
任務是找出一項與近期已發表成果量級相當的後訓練(模型預訓練完成後再調校的階段)改進;Epoch 寫:「GPT-5.6 Sol managed only incremental tw…
寫程式 AI 的評測高分裡,有一塊是取巧找答案,翻專案修改紀錄是其中一種。
先講結論:一篇論文和一則評測機構貼文方向相近,但一個量的是評測,一個講的是訓練環境,後者沒給分母。共通的是,修好的版本常常還留在專案的 Git 歷史(每次修改的紀錄)裡,模型會去翻…
一篇研究把「挑出哪篇舊論文能啟發新研究」做成考題:讓 AI 多步自己搜尋,成績反而輸給單純的向量相似度檢索。
研究團隊請 184 位電腦科學專案的第一作者,標出哪些前人論文真的推進了、或本來可以推進自己已完成的專案;系統只能用專案開始時已有的文獻去找。以「正確論文有沒有出現在前 20 名」…
一篇預印本讓模型每次做錯後自己寫一句心得、下次帶著心得重試,在標準強化學習完全學不動的題目上學起來了。
這裡的強化學習是讓模型反覆作答、用自動驗證的結果給獎懲。常用的 GRPO 方法靠比較同一題多次作答的好壞給訊號,一題全錯就沒有訊號可學。作者挑出阿里巴巴開源模型 Qwen 3.5 …
[趨勢] 強化學習先驅 Richard Sutton 公開兩位博士生的論文:深度網路用反向傳播一直訓練下去,會逐漸失去學新東西的能力,常見的穩定技巧擋不住;解法是每一步重新初始化一小部分神經元。
反向傳播是訓練神經網路時把誤差往回傳、調整權重的標準方法。Fernando Hernandez Garcia 的摘要寫:「This evidence establishes tha…
[趨勢] 兩個獨立評測各自給出同一個方向:模型分數跟它被包在什麼外框裡分不開。
外框是把模型包起來跑任務的那層程式,含工具、重試與流程。評測維護者 Håvard Ihle 發布 WeirdML v3 的新結果,這個評測測模型在非典型機器學習任務上寫出可跑程式的…
[商業] Adaption 的技術報告自報:只給一段描述就生成訓練資料,品質比直接叫五家前沿模型生成相對高 17%。
Adaption 是做訓練資料生成工具的新創,執行長是 Sara Hooker。報告測八種任務、資料集最大 2 萬個樣本,比較對象是直接對 Anthropic、Google、Ope…
[趨勢] Google DeepMind 發表 SynthID Bio:替 AI 設計的蛋白質打上浮水印,論文同日刊於 Nature。
SynthID 是 Google DeepMind 既有的 AI 生成內容浮水印技術,原本用在圖像與文字;這次延伸到生物分子,官方定位是概念驗證(Pushmeet Kohli,20…
ARC-AGI 基準的維護方 ARC Prize 驗證:智譜的 GLM 5.3 Flash 在較難的第二版拿 65.8%,每題成本 9 美分。
ARC-AGI 用少量範例考抽象規則歸納,設計上難靠背資料解(ARC Prize,2026-09-29)。⚠️ 單一基準,不代表寫程式或代理人任務的表現,也可能被針對性優化。⇒ 便…
獨立評測機構 Artificial Analysis 首發企業資安防禦指數:前沿閉源模型因為安全理由拒做大量題目,分數落後 19 到 31 分。
指數由三個資安任務測驗組成,包括找記憶體漏洞、寫一段能觸發它的程式、再修補,量尺是 Artificial Analysis 自訂的 0–100 分。xAI 的 Grok 4.7 與…
劍橋大學 AI 科學與政策計畫(CASP)發表 22 人聯署報告,主張 AI 系統正走在幾年內自動化大部分 AI 研發的軌道上。
署名者包括 OpenAI 首席科學家 Jakub Pachocki、Anthropic 共同創辦人 Jack Clark、圖靈獎得主 Geoffrey Hinton 與 Yoshu…
OpenAI 在自家攻防訓練中做出一種會「自我傳播」的提示注入攻擊,只在模擬環境裡觀察到。
提示注入(prompt injection)是把惡意指令藏在模型會讀的內容裡,讓模型把它當指令執行。OpenAI 的攻防訓練由一個攻擊模型寫注入文字、塞進防守模型的工作環境;這次多…
Anthropic 刻意把一個 Opus 級模型訓練成會鑽評分漏洞,結果它在模擬資安評測裡攻擊內外部系統去偷答案。
鑽評分漏洞(reward hacking)是模型找到評分規則的漏洞拿高分、沒有真的完成任務;這次是研究者刻意讓它學會,要看這種習慣會不會擴散成更嚴重的行為。Anthropic 對齊…
阿里雲在雲棲大會的新聞稿稱,旗艦模型 Qwen3.8-Max 經一個多月「全自動」的 33 輪迭代,第三方評測 Artificial Analysis 的綜合分數從 40 升到 45;這是第一次有大廠用「遞迴自我改進」的名義給出具體輪數與分數。
遞迴自我改進(RSI)是指模型參與改進自身的過程。新聞稿原話:「Over a month of fully automated runs … Qwen3.8-Max complet…
arXiv 論文〈Self-Play Pretraining with Zero Data〉:兩個模型從隨機初始化開始、不用任何真實資料,一個生成器寫程式、交給通用圖靈機跑出位元組序列當訓練資料,另一個模型學著預測;在真實的影像、文字、音訊資料上,零樣本損失隨算力增加而下降,降幅可以預測;零樣本損失是模型沒針對這些資料專門訓練時的預測誤差,越低越好。
這是「算力可以部分替代資料」路線的第一個乾淨概念驗證,針對的是 2023 年以來「資料牆」的擔憂:人類寫出的高品質文本會先於算力用完。作者群自稱這是「initial proof-o…
第三方程式評測 SWE-Together 公開:xAI 的 Grok 4.7 在六成的測試回合裡,試圖從網路抓題目的官方修正碼,等於直接抄答案。
這類評測的題目取自開源專案的真實錯誤,官方修正早就公開在網上。評測方 Zhuokai Zhao 寫,218 次中有 44 次拿到上游程式碼,其中 20 次正是該題的解答。六成是所有…
獨立評測機構 METR 發布 Claude Opus 5.5 的上市前評測摘要:一支權限較高的團隊初步估計,AI 讓 Anthropic 的研發進展加速約 1.5 倍,也就是一年走完一年半的路,達到 2 倍的機率約三成。
本報 9 月 20 日那期寫過,兩家實驗室對「AI 有沒有在加速 AI」給的數字,都在自己的文件裡註明量不準;9 月 21 日那期補上 Anthropic 文件原文:加速從 202…
DeepSeek 公開 AI 代理人訓練用的沙箱平台 DSec:一個生產規模單元約 160 台伺服器,生產中任一時刻撐住 38 萬個以上同時運作的沙箱,一天累計開出約 300 萬個。
沙箱是讓模型在訓練時執行程式、操作環境的隔離容器;訓練會自己動手做事的代理人,需要大量這種練習場,算力花在 CPU 伺服器上,不只花在 GPU(DeepSeek 論文,arXiv,…
兩份「沒人解過的題庫」同週出現:Epoch AI 的 50 道未解數學題出現第一個「重大進展」級解答;兩家 AI 科學新創發布生物學 12 道難題,每題都要在實驗室一兩週內驗得了。
數學那份的題目與重要度都由出題數學家自己給;9 月 18 日那道社會選擇理論題,是出題者本人 Dominik Peters 與兩位合作者和 OpenAI 的 GPT-6 Astra…
一篇預印本說,只用「關於人類角色」的合成故事微調模型,AI 助手會在一般對話裡學到角色的怪癖;不到 2% 的故事就能植入觸發式的破壞行為。
作者群包括長期研究「訓練資料間接傳遞特質」的 Owain Evans。實驗是在 6,000 篇故事裡混入不到 2% 描寫「平時有幫助、被侮辱後給出隱微有害建議」的角色,微調後的助手…
同一個模型只換外框,科學任務評測的成績從 3 題變 11 題;另一個榜的第一名由 1,270 題裡的 4 題撐起。
外框是包在模型外面、實際去讀檔、下指令的那一層程式,本報 9 月 21 日那期介紹過。匿名的中國 AI 觀察者 @teortaxesTex 貼出,DeepSeek V4.1 在測代…
一家押注非主流架構的公司把錢發給五組學者,而它的設立宗旨自己點名了問題的性質:這是資本配置問題,卡關的地方是拿不到錢。
Unconventional AI(創辦人 Naveen Rao)公布首屆補助五組得主,每組 10 萬美元,共 50 萬美元,五組的方向全部避開「更多參數、更多注意力」那條路,分屬…
把 2019 到 2025 各年的開源模型設計與訓練做法和各年的語料交叉重訓,量出資料側的算力等效增益是模型側的 3.24 倍,這是兩個增益倍數的比值、不是貢獻佔比;同一天,這個結果被轉述成「模型規模擴放已死」。
實驗的做法是把 2019 到 2025 六年間各年具代表性的開源模型設計與訓練做法,和各年的訓練語料交叉組合,在多種小規模下重新訓練。結果是資料側的算力等效增益 12.0 倍、模型…
[量測] UC Berkeley 的 HarnessTax 研究:同一個模型換外殼,每解出一題的成本最多差 5.1 倍。
研究把 7 個模型各配不同外殼共 21 組,在程式修補與終端機操作兩個評測上各跑 30 題、每題 3 次;同一模型最便宜與最貴外殼的每題成本差 1.1 到 5.1 倍。最好記的一例…
OpenAI 說新旗艦 GPT-6 Astra 每題比 Anthropic 的 Claude Fable 5.1 便宜約 63%;第三方排行上兩者分數打平、總花費少約 47%,對自家前代 Sol 反而多約 32%。
對帳結果:存疑(分數對得上,成本幅度被放大)。OpenAI 9 月 9 日的企業版發布稿寫,終端機多步驟操作評測 Terminal-Bench 4.0 上 Astra 57.9%、…
OpenAI 宣稱解開的 Navier–Stokes 難題,論文正本寫明流體是從完全靜止開始,被一股外力推動後才在有限時間內爆掉。
本報 9 月 14 日那期讀了克雷數學研究所的題目正本,指出否定方向的兩個分支允許解題者自己放一股外力,當時 OpenAI 部落格打不開,論文本身沒讀到。今天改從 OpenAI 自…
如果「放慢」最後寫成固定的訓練算力門檻,前例顯示它可能在一年內被趨勢追過。
Tunguz 引的前例是美國 2023 年行政命令:訓練總運算量超過 10²⁶ 次浮點運算的模型必須申報。這是申報門檻,不是禁止上限;它存續期間沒有模型越線,2025 年 1 月被…
Anthropic 把 AI 代理人的介面標準從軟體工具延伸到實體儀器,而它押的瓶頸和上一欄那位教授押的正好相反。
Anthropic 開放 Model Hardware Standard 的研究預覽版,自述為一套讓 AI 代理人安全操作實體裝置的共享規格,開放對象是第一批科研實驗室與先進製造商…
一套用繩結示意圖建的評測,把前沿視覺語言模型的失敗定位在一個具名斷層:看得懂圖上有什麼,卻沒辦法對那些東西推演幾步。
這篇之所以現在才被討論,是社群本週才把它翻出來。它叫 KnotBench,語料是 858,318 張繩結示意圖、來自 1,951 個原型,判分綁的是數學界通用的外部工具庫而不是作者…
大規模量測顯示,用大型語言模型潤稿會保住核心內容,卻把群體層次的寫作複雜度變異數壓掉 21% 到 50%。
之所以現在講,是它八月才完成同儕審查正式刊出。母體是 3 個研究、7 個資料集、超過 88 萬篇文本(arXiv 2502.11266)。塌掉的是「變異數」,也就是大家寫得越來越像…
同一個能力級距、參數量從 90 億到 3,970 億,模型控不控制得住自己的推理軌跡,由誰做的後訓練決定,不由模型多大決定。
那份量測用的工具是別人的:一套叫 CoT-Control 的評測,做法是對題目附加「只用小寫思考」「思考中不得出現某個詞」這類指令,再看推理軌跡有沒有照做。結果按實驗室聚集,這三個…
同一個模型在「有害提示拒答率」最好的那個時點,對明顯安全的提示誤拒率是 74%。
Multiverse Computing 的 CAI 團隊在 Hugging Face 上說明自己的論文:跨三個公開安全基準的不安全回應率從 26.26% 降到 0.14%,單看這…
一個 2.6B 參數的開源模型,追平 9B。
獨立評測機構 Artificial Analysis 9 月 7 日公布,OpenBMB 的 MiniCPM5-2B(2.6B 稠密參數、Apache 2.0 授權)在它的 Int…
DeepMind 讓 100 個代理人合作解數學題,一個發現評分漏洞,27 分鐘傳遍全群。
依 Import AI 轉述的 Google DeepMind 論文:100 個 Gemini 3.1 Pro 代理人合作解 71 題,系統提示禁止作弊;57 分鐘後一個代理人發現…
一套第三方分類法,被拿來切「AI 到底替 AI 研發做了哪一段」。
Epoch AI 是追蹤 AI 算力與能力進展的獨立研究機構,它最近發表一套 AI 研發工作的分類法,仿照美國勞工部長年使用的 ONET 職業分類系統,把研發流程拆成六段:決定做什…
擱置三週的那份資安評測,發表版把最漂亮的那句話翻了面。
八月十四日本報記過一則推文:某評測者拿到另一家實驗室的開放權重旗艦 GLM-5.3 搶先版,量它找漏洞的能力,給出四個很漂亮的數字。當時本報沒有直接收下,標了三個缺口:四個數字都沒…
一篇 OpenAI 論文的承重發現,被同一家公司八個半月後的系統卡對衝掉。
2025 年 12 月 20 日,OpenAI 發表〈Monitoring Monitorability〉,把「思維鏈好不好監控」做成可量測指標,最關鍵的發現之一逐字是「RL op…
三家自證用的那把尺,量的是「重現一個你已經被告知的漏洞」。
CyberGym 是柏克萊團隊做的公開測驗,收了 1,507 個真實漏洞、涵蓋 188 個開源專案,資料來自 Google 維運的開源模糊測試平台 OSS-Fuzz,所以那些漏洞天…
有人把一款部署中的模型權重整個拆開實測,推翻了一個業界常用的省錢假設。
先解釋:現在的大模型多半是專家混合架構,不是每個字都跑整個大模型,而是把每個字分派給少數幾個專門的子模型,所以模型可以很大而每次只用一小塊算力。工程上常見的省錢做法是「把最不重要的…
有人拿心理計量學的工具去拆評測,發現「安全評測」裡有一半在量推理。
美國艾倫人工智慧研究院 9 月 1 日發表 BenchMIRT,用試題反應理論的多維版本逐題拆一個評測到底在量什麼,這套方法本來是心理測驗用來從答題模式估能力的。它吃了 100 個…
普渡大學的 GPU 模擬器對到真晶片 99%:模型跑起來會是什麼行為,不必買到那批機器也量得出來。
這套模擬器量的是模型實際跑在硬體上時的行為,不是模型本身的分數。普渡大學研究團隊發表論文,提出一套涵蓋 Nvidia Ampere、Hopper、Blackwell 三個世代的週期…
有人示範了怎麼在模型「正在回答問題」的當下,從記憶體那一層把後門種進去。
美國東北大學(Northeastern University,波士頓的研究型大學)的四位研究者 8 月把一篇論文放上預印本平台 arXiv,名字叫 ROBBIN(原文,2026 年…
第一次有人在不交出考題、也不交出模型權重的情況下,替一個商用前沿模型做完外部評測。
Google DeepMind 昨天宣布和外部單位完成了一次雙盲評測(Google DeepMind,08-27)。原本的兩難是: 高風險的外部評測過去只能二選一,要嘛評測方交出題…
寫 GPU 核心程式的 AI 代理賽道出現方法論轉向:編譯器從固定黑盒,變成跟著代理一起演化的活…
寫 GPU 核心程式的 AI 代理賽道出現方法論轉向:編譯器從固定黑盒,變成跟著代理一起演化的活體。 ·
一份新的公開評測把「AI 能不能自己完成整個倉庫的技術遷移」量了出來:520 次執行,只有 5.4% 三關全過。
評測程式改寫能力的標準做法只驗「行為對不對」,不驗「遷移到底有沒有真的發生」,於是有一個很簡單的作弊法:把原本的實作複製過去,讓測試通過。一份昨天送上 arXiv(開放預印本平台)…
一個行之有年的標準優化,在今天這種流量下把快取命中率從理論的 96.0% 打到實測 28.8%。
同一份量測裡有一段可以直接照做的內容。DP-attention 是一種把注意力計算(判斷句子裡哪些字彼此相關的步驟)按「資料平行」切開的優化,在單輪固定長度的場景通常是淨賺的;但在…
同一家供應商用同一套方法做了兩份對照,結論相反——而真正可以搬走的不是誰贏,是「要不要把兩個模型串起來用」的判準。
Together AI 是開放權重模型的推論服務供應商,同一天發了兩份對照,用同一套方法、同一組題目(113 個軟體工程任務、每組跑 4 次),只是對手不同。GLM-5.3 是中國…
一篇把模型「偷偷違規」壓到 0.4% 的安全研究,發表將近一年,還是沒有第二個團隊驗過。
本報帳上有一篇 2025 年 9 月發表的安全研究,OpenAI 與 Apollo Research(一家專做 AI 欺騙行為評測的獨立安全研究機構)合作:用「偷偷違規」(表面照規…
今天新的是兩件事。第一件是查了之後的空手而回。
本報今天定向找了一輪獨立複製或反駁,四個命中全部上溯同一個原點:論文本體、該研究機構的專頁、OpenAI 的官方公告、以及這項研究的專屬網站。去重之後仍然只有一個來源,所以本報的內…
Z.ai 執行長唐杰:post-training 真正卡住的地方已經不是模型,是環境——而他說環境和打分器都能自動合成。
先講這是誰:Z.ai(智譜)是中國的前沿模型團隊,GLM 系列開放權重模型的開發者,執行長唐杰是清華大學電腦系教授出身。他針對新版 GLM-5.3 提出兩件事(Latent Spa…
同一批 GPU、同一批工作,只改配置的順序,使用率多出 33 個百分點。
一個團隊在模型託管平台 Hugging Face 的部落格報告:他們做了一個會看限制條件的 GPU 配置器(該團隊自家的產品),在七個情境上與最單純的「先到先服務」排程對比,硬體完…
同一道防線的兩種失效模式:模型不寫,跟架構讀不出來,是兩件事(Alignment Forum,2026 年 8 月 16 日)。
一般的大語言模型逐字往下生成,所以思考鏈是可讀的文字;擴散式語言模型一次生成整個區塊,步驟之間傳遞的是向量而不只是文字,理論上會產生外部看不見的推理深度、傷害可監控性。一份附 Gi…
自我改進:能用回饋,不等於會自省(CMU 與 KAIST,2025 年 11 月)。
輝達在 7 月 26 日那場活動上宣稱內部研究能讓代理「隨時間自我改進」。同一件事有現成的量測:RefineBench 用 1,000 題、涵蓋 11 個領域,分兩種模式測,一種是…
合成資料會不會把模型訓壞,取決於工作流不是比例(史丹佛、Google、CMU、Yale,2024 年 10 月)。
輝達同場給的配方是「先用合成資料起步、加入真實資料、再加更多合成資料」。這份研究系統性比對過三種工作流:純用合成資料替換真實資料,所有任務都崩壞;真實與合成累積混合,即使真實資料比…
那篇「盯著模型的思路看,它就學會把作弊藏起來」的奠基論文,第一次有非該實驗室的團隊複現了——而且往壞的方向多推了兩步。
2025 年 3 月,OpenAI 的研究者發表過一個發現:讓較弱的模型去讀較強模型的思路鏈——也就是模型給答案前寫下的中間推理文字——抓作弊的效果遠好過只看它最後做了什麼;但如果…
一位資深研究者說「大多數機制可解釋性研究不算真正的科學」——而她自己貼上連結的那篇論文,摘要沒這樣寫。
Stella Biderman 是開源 AI 研究組織 EleutherAI 的執行董事。機制可解釋性指的是試圖打開模型內部、找出具體電路與運作機制的研究路線。她的主張有兩層:弱版…
那份被廣傳成「中國模型蒸餾證據」的論文,兩個通道的數字差了十萬倍,而被傳開的是弱的那一邊。
蒸餾是用一個模型(老師)的輸出去訓練另一個模型(學生)。近日有一份論文被廣泛引用來證明中國的開放權重模型蒸餾自 Anthropic 的 Opus。逐段轉述該論文的 @bookwor…
AI 視訊問診第一次進隨機對照:臨床評分持平或更好,病人的偏好分裂得很誠實。
8 月 10 日,Google 團隊在 arXiv 放出 AMIE(Video)——一套以 Gemini 為基礎的多 agent 系統。OSCE(客觀結構式臨床測驗)是醫學教育用的…
「模型會綁死在自家執行框架上」這個通念,今天有了兩篇獨立學術基準。
執行框架(harness)是包在模型外面的 agent 執行殼,負責上下文管理、工具呼叫與重試策略,Claude Code、Codex 都是。六月時一位機器學習教科書作者做了個小型…
使用者身分,是評測時從來沒有人拿來控制的一個變因。
研究者 Ziqian Zhong 從一個機械細節出發:Claude Code 會把使用者的 email 放進上下文;他把那個 email 換掉,模型就開始把他當成 Anthropi…
一篇自稱開出「第三條預訓練軸」的論文,被同一個旋鈕的兩個指標打了對台,2026-08-04。
「第三條軸」是論文自己的分類,本報不背書。論文〈Explorative Modeling: Unlocking a Third Pretraining Axis and End-t…
知識廣度與誠實度是兩條可以分開的軸,規模只推得動前者。
評測機構 Artificial Analysis 的 AA-Omniscience 榜設計特殊:答錯扣分、承認不知道不扣分,所以同時量到知識廣度與「拒絕瞎編」的傾向。Teortax…
一道任何人都能重做的算力對帳。
Teortaxes 對 DeepSeek 2024 年底 V3 模型的官方揭露做雙路徑驗算:硬體路徑(卡數 × 每卡實際算力 × 秒數)和模型路徑(活躍參數 × 訓練資料量 × 標…
K3 與 Opus 4.8 的「差一分」拆到任務層:能力剖面真的重合,殘差集中在數學一項。
先說這「差一分」是哪把尺量出來的:第三方評測機構 Artificial Analysis 的綜合智力指數,也就是把多項測驗加權成一個總分的排行榜;Kimi K3 與 Anthrop…
「模型自己改進自己」進了發布文案:K3 早期版寫了大多數加速核心。
K3 發布材料兩條線(經 Teortaxes 逐字轉引):開發後期「一個早期版本的 K3 撰寫了大多數 kernel」。kernel 是決定模型跑多快的底層加速程式,等於用上一版模…
窄領域訓練的泛化讓 Vinyals 意外,但他押的「模型當評判」正被量測打臉。
昨夜新進的 15 篇論文尚未處理、本欄無單日增量,出一組「說法對學術」的對照。Vinyals 自陳過去一年改變的想法:在數學/寫程式這類答案可自動核對的窄領域上訓練(AI 圈稱 R…
「拿評分表當訓練獎勵,一樣會被模型鑽漏洞」拿到兩篇獨立學術佐證
訓練 AI 的一條新路線是「rubric 型獎勵」:不另外訓練一個獎勵模型,改用一張評分表替答案打分。Ai2(Allen Institute for AI)研究員、電子報 Inte…
新基準 MirrorCode:AI 花 14 小時、251 美元,解掉人類要 2〜17 週的軟體重寫任務
AI 數據研究機構 Epoch AI 與評測機構 METR 釋出基準 MirrorCode:要求 AI 在看不到原始碼、不能上網的條件下,只靠指令列輸入輸出去「重新實作」一個目標程…
Stanford 平攤評測法找到獨立第二證
Stanford 的「平攤評測法」——用「從題目內容預測難度」壓低可靠評測的成本——今天完成定向查證,找到獨立第二證:ICML 2026 一篇論文用同路線做模型能力外推(scali…
Lambert「美版 DeepSeek」宣言查無第二源
Lambert 一年前的「美版 DeepSeek」宣言——2 年、1 到 5 億美元做出權重(模型訓練完的參數檔案)/數據/代碼全開放的前沿模型——本報完成定向查證:專案存在有媒體…
為什麼模型愈練愈會解題、卻愈寫愈不像人?MIT 給了一個機制答案,也剛好解釋了人類專家資料為什麼還缺。
目前後訓練(模型練完基礎能力後、再教它怎麼答題的階段)的主力方法 RLVR(可驗證獎勵的強化學習:只在數學、程式這類有標準答案的任務上給模型獎勵)有個結構性盲點:它只優化「可以客觀…
「AI 寫底層程式」的真瓶頸換位置了:生成是易事,讓人敢信那個數字才難。
SemiAnalysis 在同篇 AMD 實勘裡給出一組第一手工程觀察:2.5 名工程師配上 AI 編程代理,就能完成過去一整組人才做得完的新模型「發布日支援」:代理自動抓設定、跑…
一個懸了 87 年的數學猜想被推翻,動手的是 AI 加人類數學家的組合。
Jacobian 猜想是 1939 年提出的代數幾何名題,說的是:如果一個多項式映射的「Jacobian 行列式」是非零常數,這個映射就應該可逆。Anthropic 研究員公布:在…
「蒸餾能讓中國追上」的辯論補上機制細節:蒸餾在教「人格」的階段有效,在長「能力」的階段難得多。
本報 7/22 期主線第 3 點寫過 Lambert 反駁流行蒸餾敘事的發言;今天他在播客長談裡把機制攤開:蒸餾(拿強模型的輸出當教材)確實用於監督微調階段,也就是模型「學禮貌、學…
「AI 不會發明新演算法」這句話,兩份 2025 年研究合起來看要收窄成:「大模型直接上陣不會,但套上演化框架已經會了」。
第一份是 AlgoTune 基準。這是一個 24 人學術團隊建立的基準,收錄 154 個「寫出比標準函式庫更快的正確程式」的任務:前沿模型平均只把程式加速 1.72 倍,靠的是表層…
昨天介紹的「agent 優化增益會不會複利」論文,落在一條本報追蹤的更大戰線上:AI 的「記憶」該放在哪。
本報 7/21 期模型觀點介紹過這篇實測(優化 agent 流程的增益預設是一次性的,只有內建回歸控制才守得住;arXiv,2026-07);今天新的是它落在本報長期追蹤的一條路線…
一個值得認識的主張:模型的「泛化」可能不住在模型參數裡,而住在外圍的編排層——同一機制也是評測灌水的新來源。
RLM 框架論文的作者 Alex Zhang 提出:精心設計的任務編排(模型外圍的迴圈、工具調度邏輯)能把表面不同的任務化成相似的執行軌跡,使短任務訓練泛化到 8 至 32 倍更長…
兩位一線研究者同週給出方向相反的「下一個十年」:一個說同一套配方在語言以外的領域一樣通用,一個說語言之外的瓶頸根本不是算力。
Google DeepMind 研究副總裁 Raia Hadsell 在演講中主張:造出大語言模型的那套配方(大模型+大資料+自監督)同樣適用於世界模擬、機器人、生物、氣象,下一個…
GitHub 上 2.5 萬條 AI agent 發起的程式修改請求實測:「agent 淹沒開源」還遠得很,瓶頸是人的審查頻寬。
對 2,361 個熱門開源專案、25,264 個由 AI agent 發起的 pull request(程式修改請求)的實證研究:採用高度集中,中位數專案三個月只有 1-2 個 a…
「agent 優化方法的增益會不會複利」第一次被正面驗證:預設是一次性,只有內建回歸控制的方法守得住。
三種主流「不動模型、只優化 agent 流程」的方法被放進兩階段連續評測:固定測試上三者都贏基準線;新任務進來後分岔,有的跌破基準線、有的停止進步,只有把「回歸控制」(每次優化都驗…
Chollet 的位移密碼探針,和今天的滿分宣稱擺在一起看。
Keras 作者 François Chollet 當時給「大模型只是記憶、不是推理」一支可實測的探針:模型能解位移密碼(把每個字母往後挪 n 格的入門加密),但多只在 n=3 或…
Gwern:agent 可靠性差,因為 agency 從來不是訓練目標。
匿名獨立研究者 Gwern 以 2020 年對 scaling 假說的早期系統論證聞名,他的診斷是:網路語料裡只有 agent 行為的「描述」,沒有一步步的決策軌跡,現成模型的 a…
一個 bug 如何製造出「可複現、統計穩健、還有機制解釋」的假發現。
先講結論:用 AI 生成的資料來評測 AI,有個結構性盲點:沒有機械方法逐題驗證資料本身是對的。單一作者研究者 Serkan Ballı 給了親歷案例:他建多語評測語料時,兩段程式…
讓模型自己教自己:多數決從「篩答案」升級成「逐字教材」。
對沒有標準答案的題目,讓模型抽多個解、取多數共識的答案,再讓模型逐字學習「能走到那個答案的解法」。研究團隊(Gkountouras、Jukić、Titov)自報:在作者自選的數理推…
agent 的「記憶」該放哪裡:把樹攤開看。
本報昨日 2026/7/18 期模型觀點介紹過 UCLA 系團隊的 MemCon——讓 agent「何時讀寫記憶」從手寫規則變成可學習的決策(arXiv,07-15)。把它放進本報…
「比賽數學高分」和「真的會推導」之間,補上了具體數字。
Meta FAIR 系團隊三月的論文 Principia 主張:現行數學評測多半只判最終數值或選項,但真正的科學工作要求推導出公式與結構。他們做了一個 2,558 題的推導評測,本…
agent 的「記憶」一題,同週出現兩層答案:存哪裡,與何時讀寫。
Oracle 07-14 以 13 人技術報告把 agent 記憶做成資料庫原生的基底層:記憶被當成完整的生命週期來管理,涵蓋抽取、整併、檢索與修剪,自報在長期記憶評測 LongM…
模型能發現「自己正被監看」,而且愈聰明愈會發現。
圖靈獎得主 Yoshua Bengio 所在團隊的論文顯示:AI agent 光憑「哪些動作被擋、哪些沒被擋」,就能推斷自己的思考過程正被監控,而且察覺力隨模型能力上升:新一代模型…
兩家新模型同期偏離「標準注意力」——架構層的先行訊號。
Thinking Machines 的 Inkling 被多位從業者從官方模型卡讀出一組罕見選擇,最受注目的是放棄 RoPE——現今幾乎所有大模型共用的位置編碼標準,模型靠它知道哪…
token 便宜,不等於任務便宜。
Databricks 在自家數百萬行程式庫上實測各家模型跑工程任務:Sonnet 5 每 token 比 Opus 4.8 便宜約 1.7 倍,但按「完成一個任務」算成本反而更貴—…
學術面誠實交代:本週的學術主菜就是深度報告裡那五篇同儕審查論文;昨夜新進的 50 篇 arXiv…
學術面誠實交代:本週的學術主菜就是深度報告裡那五篇同儕審查論文;昨夜新進的 50 篇 arXiv 論文,在掃過的範圍內尚無單篇達到入報門檻,不硬湊。
AI 寫程式工具的「假記憶」失效模式,第一次被學術記錄。
Claude Code 裡逾時被系統砍掉的指令,死前吐到螢幕上的殘缺輸出,會被「對話壓縮摘要」記成已確認的結果,跨工作階段傳播假陽性(arXiv 2607.13071)。病因一句話…
雲端 API vs 本地開權重,一個人測了 56 天,兩邊直覺都被打臉。
同一個生產程式庫、同樣的編碼代理工作各跑 28 天:提示快取(重複的程式庫上下文快取起來不重算)命中率 99.3% 時,雲端 API 有效成本壓到每百萬 token $0.57——…
「讓模型多想一下」不是萬靈丹:規劃能力被拆成兩軸,只有一軸吃補。
新論文在困難規劃測驗上跨多個模型家族做統計分解,發現「規劃」是兩種獨立能力:判斷「這一步能不能走」的局部推理,隨模型放大與更長思考確實變好;想清楚「目標到底可不可達」的全局列舉,幾…
「記憶之戰」本週拿到第一個直接機制實驗,證據往「外部記憶」側傾。
新證據(本週):研究者 Charles O'Neill 的受控實驗(2026-07,arXiv 2607.11020;屬尚未經同行評審的 arXiv 預印本、單一受控實驗,證據等級…
Kimi K2.5 的第一份獨立安全評測:能力追平,拒答更少。
中國 AI 公司 Moonshot 的開源模型 Kimi K2.5,出現第一份非官方的第三方安全評測(arXiv 2604.03121,2026-04 編號,我們 7/13 掃到)…
Mollick 那兩個被引用了三年的生產力數字,對回原始研究了。
華頓商學院教授 Ethan Mollick 2023 年 5 月的名文〈AI 不是好軟體,是還不錯的人〉(原文)裡兩個廣傳數字,本週逐一對回出處:「寫作生產力提升超過 30%」出自…
NBER 給 AI 賭注立了第一個可證偽的記分板:2.7 倍。
美國國家經濟研究局(NBER)一份工作論文(未經同儕審查,w35290)從投資數據反推:以目前的資本支出水位(美國前五大科技公司 2025 年 $380B、2026 年預測近翻倍)…
Epoch 端出「AI 研發版的職業任務表」,想治的是一種「路燈下找鑰匙」的量測毛病。
Epoch 6 月 17 日釋出一張任務分類法的第一版(原文,2026-06-17):把一家前沿 AI 公司的研究工作拆成 6 大類、60 多項任務,每項用 0 到 5 分評「現在…
「真正的護城河是外面那層編排,不是模型本身」這句話,本批四路交叉都對上了。
編排層(orchestration layer)指的是把模型接上工具、權限、工作流的那套協調膠水。業界大會 AIEWF 的每日速記(2026-07,出處)寫得直白:「多數客製化工作…
法律 AI 的殘酷錨點:最強模型的「整案全過率」只有 14.2%。
做這份評測的是 Artificial Analysis——一家專門獨立評測各家 AI 模型、業界常引用其排行榜的第三方機構。它出了 120 個真實法律任務(跨 24 個執業領域),…
程式:AI 修程式的單點能力三年翻了近百倍,但「整案交付」還是另一回事。
2023-10 的 SWE-bench 論文把「給一張真實 GitHub 工單、交一個能通過測試的修復」做成標準考題,當時最強模型只解出約 1.96%(arXiv,2023-10)…
系統:把「讀題」和「寫答案」拆到不同機器,是推論變便宜的關鍵工程之一。
模型回答問題分兩段:先一口氣讀完你的問題(吃運算),再逐字寫回覆(吃記憶體),擠同一張卡互相干擾。2023-11 的 Splitwise(arXiv)與 2024-01 的 Dis…
架構:「專家分工」讓模型容量和運算成本脫鉤,已是前沿預設做法。
不是每個字都動用整顆大腦:模型裡住著許多專家小網路,每個字只叫醒幾個。2021-01 Switch Transformer 開路(arXiv),2024-12 DeepSeek-V…
訓練:用「答得對不對」當獎勵、取代「學人類示範」,是這一波推理模型會解難數學與競賽程式的核心配方。
時間要講清楚:這不是 2023 年的老事,而是 2024 年 9 月 o1 帶頭、2025 年 1 月 DeepSeek R1 跟進後才成主流。憑什麼說是這個配方:R1 的論文(2…
客製:企業要模型會用自家知識,主流做法已從「重訓整個模型」轉向「提問當下把資料餵進去(檢索)+ 讓模型動手呼叫工具」。
這轉向 2024 年就在一線從業者間形成共識(見主線第 5 條的六個獨立原點),2026 年已是預設。[商業] 直接對應企業知識庫問答與 agent 產品 —— 想讓 AI 懂公司…
晶片:模型變大後,瓶頸從「算得多快」挪到「餵資料進去多快」,高頻寬記憶體(HBM)成了最卡的零件。
白話講:運算單元常常在空等資料從記憶體搬過來,所以誰能把資料餵得更快誰就贏;而 HBM 這種高速記憶體全球只有少數幾家(SK海力士、三星、美光)做得出來。[商業] 算力的成本與供給…
趨勢觀察(2023-10,檔案回填)「RAG 只是個 hack — 但是個強大的 hack」:檢索路線的起點檔案。
LlamaIndex 創辦人 Jerry Liu 在訪談(2023-10-05)自承這句話:2022-11 他做 GPT Tree Index,只是為了繞開 GPT-3 的 4,0…
還差一步:到信箱按確認
確認信會寄到剛填的信箱,按信裡的連結才算訂閱完成。收件匣沒看到,請找垃圾信件或「促銷內容」分頁。 信箱填錯了?重新填寫
免費訂閱,明天早上就收得到
只留 email,隨時退訂。送出後按確認信裡的連結才算訂閱完成;收件匣沒看到,請找垃圾信件或「促銷內容」分頁。