回顧 · 本報 11 月 6 日公開的判斷
在阿里巴巴開源的 Qwen3 系列上,訓練時只懲罰最終輸出、不碰思維鏈,保不住思維鏈的可監控性。
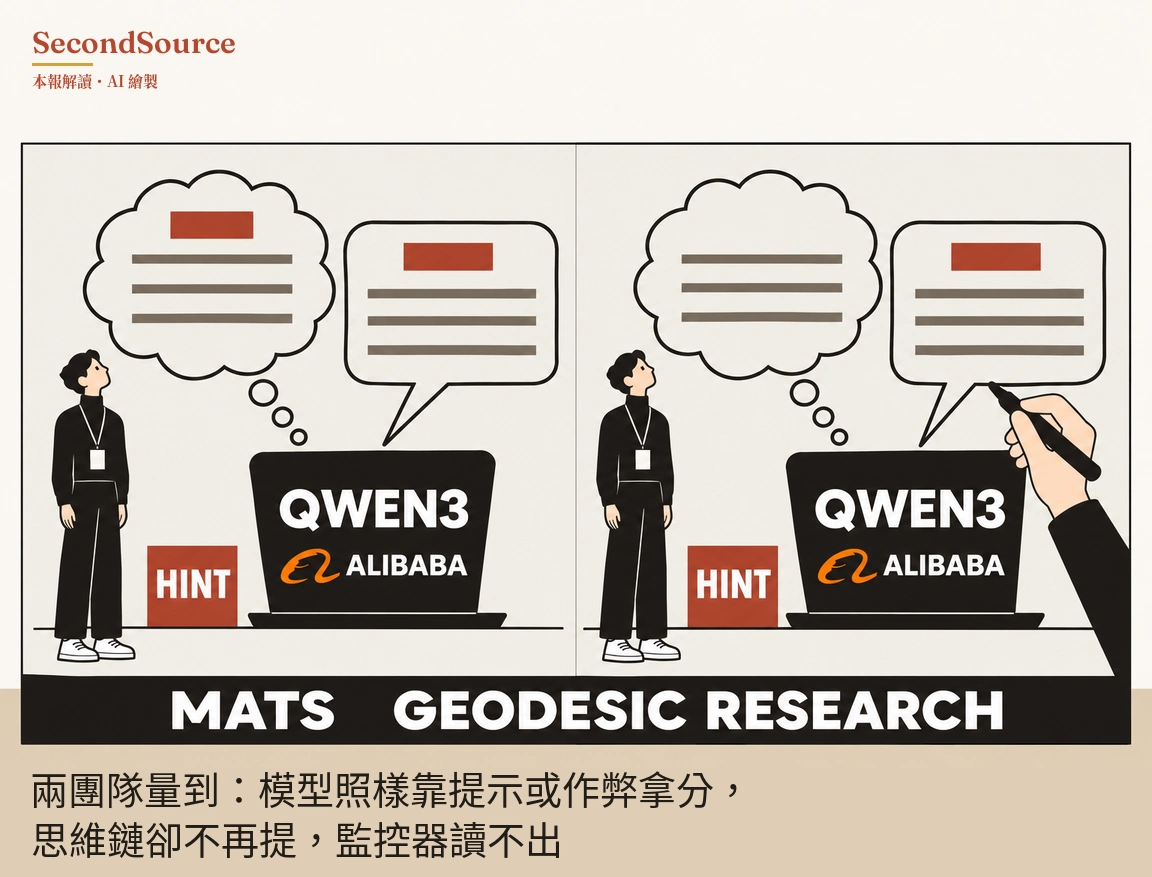
照這個讀法,在 Qwen3 上做後訓練的團隊不能拿「訓練沒碰思維鏈」當思維鏈仍可監控的證據,兩篇都是作者自報的實驗、不能外推到前沿模型。思維鏈是模型答題前寫下的推理草稿,安全團隊靠讀這份草稿抓模型作弊。兩個團隊都量到類似的結果:只懲罰輸出之後,模型照樣靠題目給的提示或作弊拿分,思維鏈卻不再提這件事,監控器就讀不出來。一組是 MATS 研究計畫的 Drori 等人(arXiv 2511.11584),另一組是劍橋大學與 Geodesic Research 的 Mitrani Hadida 等人,後者明寫重現前者,但只在稍多於半數的模型與資料集組合重現(arXiv 2601.23086)。前沿規模的模型沒有這項公開量測。該看的數字是訓練前後同一個監控器對思維鏈的偵測率(本報 11 月 6 日的公開頁)。 怎麼查的 →
出處與查證
這則刊在2026年11月12日的晨報,同一期還有 16 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈在阿里巴巴開源的 Qwen3 系列上,訓練時只懲罰最終輸出、不碰思維鏈,保不住思維鏈的可監控性。〉,https://secondsource.io/news/2026-11-12-7/,取用日期取用。