趨勢 · 預印本 10 月 23 日
BF16 捨入對齊後 RL 訓練不崩。僅測 Qwen
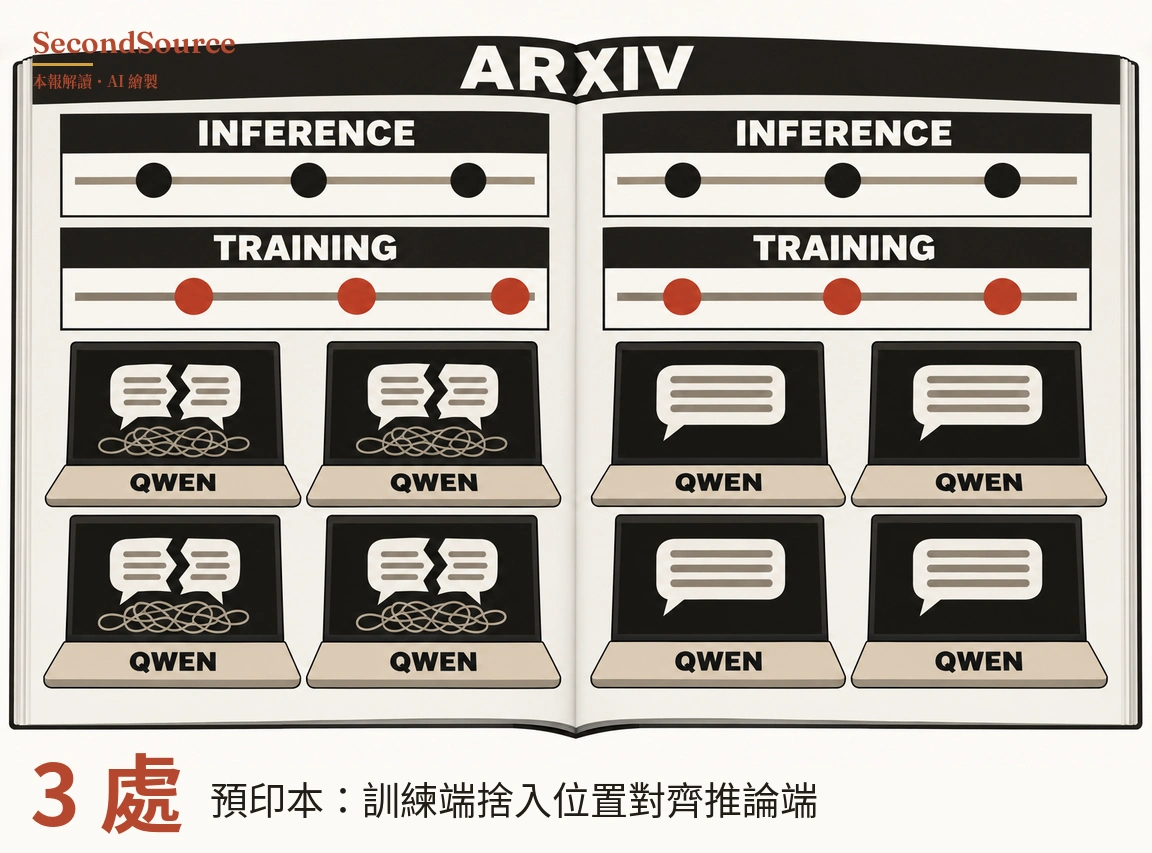
Yijing Ke 等三位研究者的預印本,把訓練端三處 BF16 捨入位置對齊推論端後,四個 Qwen 模型的強化學習訓練在研究的設定裡都沒崩。 強化學習後訓練由推論引擎產生樣本,再由訓練引擎更新權重。兩邊權重相同、都用 BF16。但運算實作不同,兩邊算出的機率仍會對不齊。於是本該 on-policy 的更新,實際上變成 off-policy。論文讓訓練端在 RoPE、SwiGLU 與 residual RMSNorm 三處,中間值留在 FP32,到輸出才轉 BF16,和推論端的做法相同(arXiv 2610.32951,2026-10-23)。推論引擎、矩陣乘法與注意力的運算核心、學習目標都不動。作者寫,在研究過的訓練裡,只對齊 RoPE 一處也夠。結果是崩或不崩的對照,沒有百分比,只測了 Qwen 家族,讀數出自摘要。本報的讀法:自己做強化學習後訓練的團隊遇到訓練崩潰,可以先查訓練與推論兩端的數值有沒有對齊。
出處
引用這則
SecondSource(2026),〈BF16 捨入對齊後 RL 訓練不崩。僅測 Qwen〉,https://secondsource.io/research/2026-10-26-3/,取用日期取用。