本週 · 預印本,arXiv 2610.37459
M4Bench:完整規格加 0.162 分,技能包近乎零
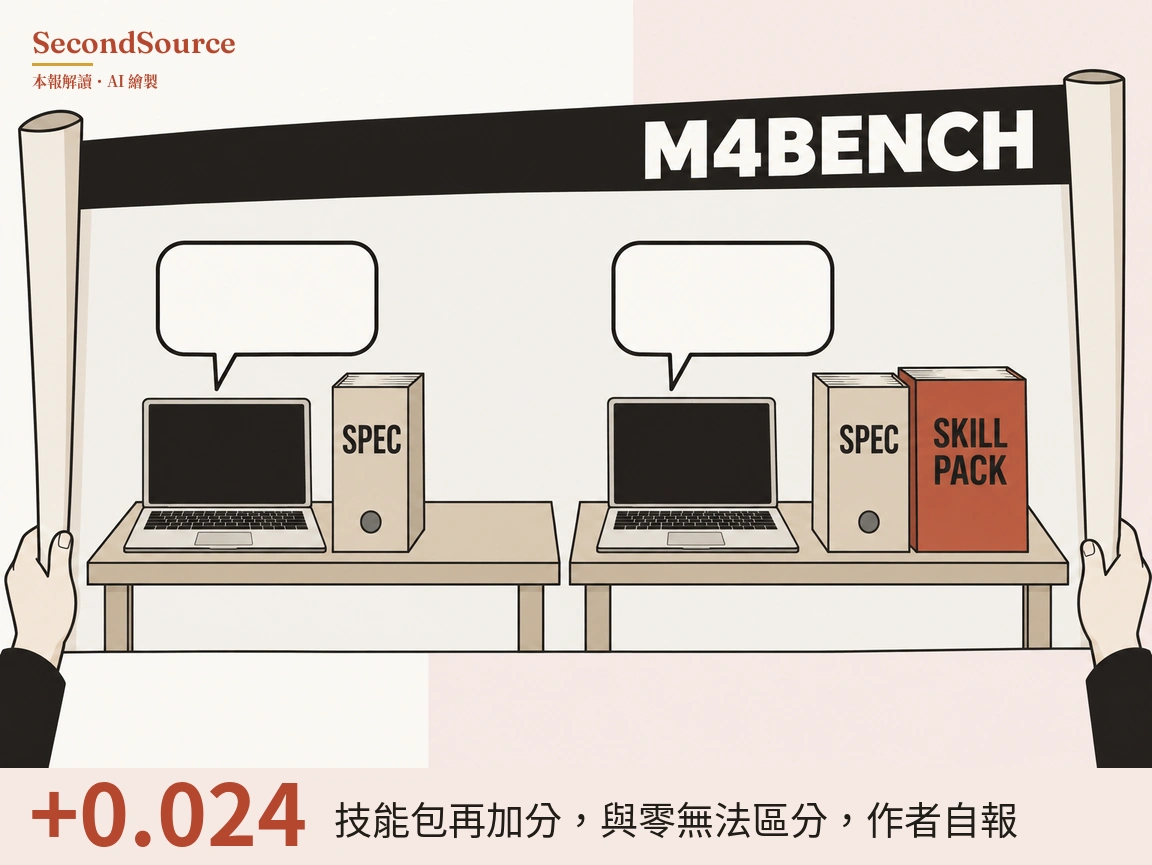
M4Bench 在八題對照子集上量到,代理得分的增益大多來自把規格寫完整:一份可操作的規格讓得分多 0.162,技能包只再多 0.024,這個增量在統計上與零無法區分。 據論文摘要,這是 NeurIPS 2026 資料集組收錄的工作,作者含 MIT 的 Leo Anthony Celi,任務取自臨床電子病歷的衍生題。在這組臨床資料任務上,代理多拿到的分數大多來自規格寫完整,技能包本身的貢獻小到量不出來。這裡的得分是代理答案與參考答案的部分吻合度。在八題對照子集上,規格本身讓代理得分多 0.162,疊上技能包只再多 0.024,統計上與零無法區分。子集只有八題,量不出差別不等於確定沒有差別。內容是假的技能包,得分與沒有技能包一樣。把原始的參考 SQL 直接當技能包給代理,得分幾乎和針對性寫的技能包一樣。另一個指標是通過全部嚴格檢查的次數:280 次有技能包的執行有 25 次通過,280 次沒有技能包的有 13 次。論文摘要沒交代用的是哪個模型,也沒說這個差距是否顯著(arXiv 2610.37459)。 怎麼查的 →
出處與查證
這則刊在2026年10月29日的晨報,同一期還有 16 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈M4Bench:完整規格加 0.162 分,技能包近乎零〉,https://secondsource.io/research/2026-10-29-2/,取用日期取用。