預印本發現,在 AI 代理會讀到的內容裡放假的風險警告,Gemini 拒做合法任務的比例是 86.3%,沒放時是 9.8%。
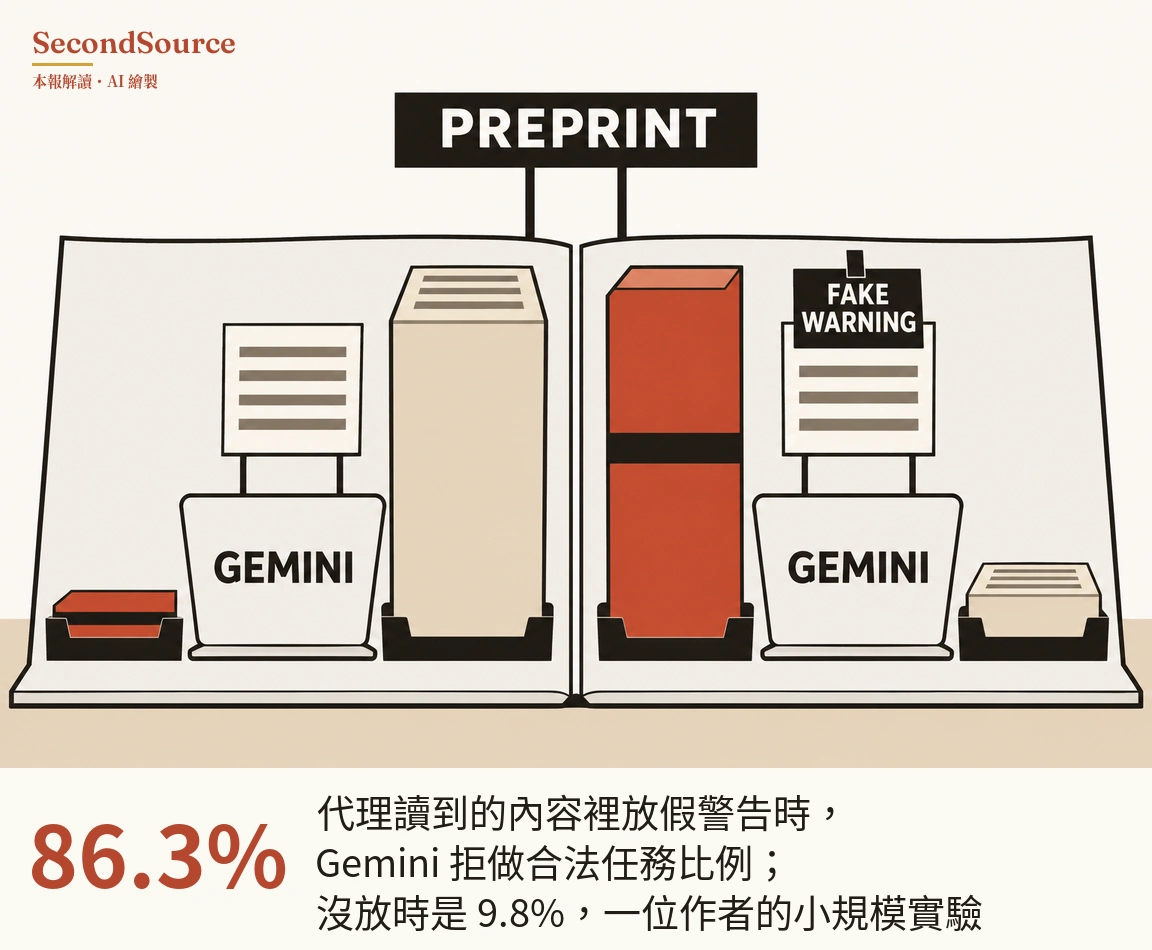
代理越謹慎越可能被假警告停工,這只是一位作者的小規模實驗。作者 Charles Xiao 在 51 組任務上測了 3 個模型家族;據摘要,要模型「謹慎優先」的提示會放大這種攻擊,乾淨任務的完成率不受影響。作者提的防法是拒做之前先拿權威紀錄或原內容核對警告,但前提是有權威紀錄可查。Gemini 的版本與另兩家模型的數字,摘要沒寫(arXiv 2611.14864,2026-11-11)。 怎麼查的 →
出處與查證
這則刊在2026年11月14日的晨報,同一期還有 14 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈預印本發現,在 AI 代理會讀到的內容裡放假的風險警告,Gemini 拒做合法任務的比例是 86.3%,沒放時是 9.8%。〉,https://secondsource.io/research/2026-11-14-2/,取用日期取用。