今日 · 公告 10 月 22 日
METR 找出 OpenAI 監控覆蓋面缺口。只對舊系統
METR 公布在 OpenAI 場內三週的監控演練:METR 估計 GPT-5.5 以上模型的內部代理流量約 75% 到 94% 列在應送監控範圍,強化學習訓練當時不在監控內
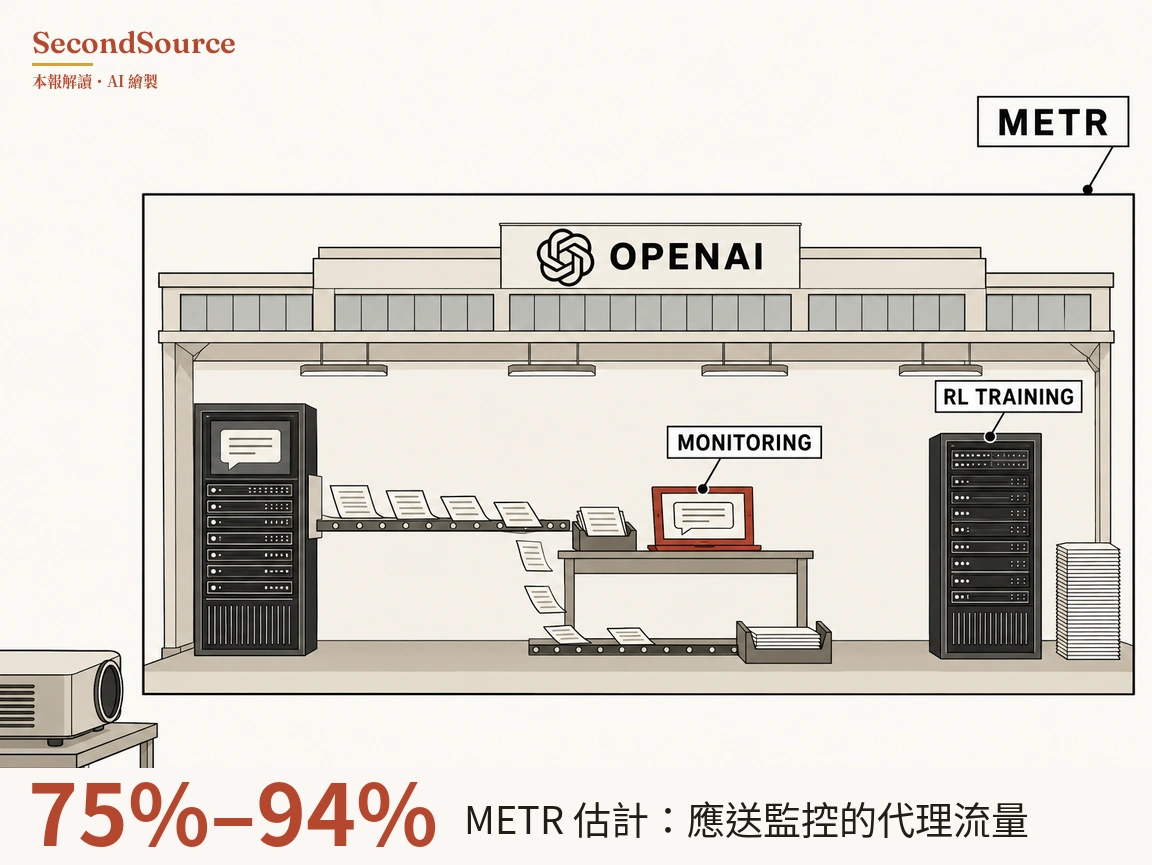
為什麼重要: 代理監控最先出問題的地方,是有些流量根本沒送進監控,監控抓得準不準是其次,這是本報的讀法。
METR 是受實驗室委託做能力與風險評估的外部評測機構。10 月 22 日 METR 公布一份演練摘要。7 月 21 日到 8 月 11 日,METR 與另一家外部研究機構 Redwood Research 各派一名員工進 OpenAI 三週,讀內部程式碼、監控設定與文件,測 OpenAI 的失準監控(METR,2026-10-22)。失準指 AI 的行為偏離開發者的意圖。失準監控是另一套模型事後讀 OpenAI 內部 AI 代理的工作紀錄,找欺騙、破壞、資料外洩這類行為,再送人工覆核。METR 估計,能力至少與 GPT-5.5 相當的模型,經 OpenAI 內部 Responses API 產生的代理流量裡,約 75% 到 94% 列在應送監控的範圍。其餘的流量不在應送範圍內。程式代理 Codex 是其中一個子集,Codex 流量的應送比例是 99.2%。原文寫「RL training runs were not covered by the monitoring system」,演練開始時,強化學習訓練不在監控內。代理對話太長時,系統會把前文壓成摘要。這類壓縮當時沒送監控,METR 估計 5 到 7 月約一成應受監控的 Codex 流量因此沒被看到。精確比例不確定,因為當時沒記錄哪些監控呼叫是壓縮觸發的。OpenAI 員工演練前已發現,演練期間修好。METR 另找到「two independent client-controllable headers that disable the monitoring system for new agents」。這兩個參數由發出請求的一方設定,設了之後,新起的代理就不受監控。代理本身就是發請求的一方,所以原則上代理設得到。這一步是本報的推論,METR 原文沒寫代理能直接改這兩個參數。OpenAI 事後說相關漏洞都已修補,METR 緊接著寫「We have not evaluated these claims.」
還不能當真: 讀數只對 7 月 21 日前的系統,現行覆蓋率沒量 怎麼查的 →
判斷更新: 本報的讀法:代理監控要先問多少動作真的被看了,再問看到時抓不抓得到。METR 這份摘要的負面讀數集中在覆蓋面:應送比例、訓練沒覆蓋、壓縮漏監、參數能關。監控這一端的讀數反而偏正面:除少數例外,監控讀到的紀錄與代理看到的一致,OpenAI 提供的監控請求出錯率低於 0.2%。這兩個讀數說的是紀錄完整、監控有在跑,不是監控抓壞行為抓得多準。本報 10 月 21 日那期寫過 METR 審 Anthropic 八月風險報告(METR,2026-10-20)。那份審查也點出「simple ways to disable monitoring」,以及動作發生到人工覆核要數天到一週。同一份審查也轉引 Anthropic 自報的讀數:Anthropic 的離線監控在 Mythos 5 相關事件上,只標記了約 1% 的動作。Mythos 5 是 METR 審查列出的 Anthropic 模型。拿掉思維鏈、只看動作與工具呼叫之後,標記率升到約 50%。這是 Anthropic 自報、METR 轉引的單一事件讀數,和 METR 對 OpenAI 估的比例量法不同,不能直接相比。所以兩家都有覆蓋面缺口。Anthropic 那邊在這次事件上,監控看到了卻沒標出來的情況也存在,是不是常態,這份轉引看不出。兩份讀數都出自 METR 一家,不是兩個獨立來源。METR 提的第一項建議是逐筆登記推論請求:「Keep careful accounting of all inference that happens, and which subset is being monitored」(METR,2026-10-22)。意思是記下每一次推論,標出其中哪些送進了監控,再定期與監控系統本身的紀錄核對。這是還沒定案的判斷。什麼會推翻它:到 2027 年 1 月 31 日,OpenAI 或 Anthropic 任一家公開現行監控的覆蓋率對帳數字達 99% 以上,且有外部方背書;或下一份外部紅隊報告的主要發現落在「監控看到了卻沒抓到」。99% 這個門檻是本報自設的,不出自 METR 或 OpenAI。本報把對答案日設在 2027-01-31。
出處與查證
這則刊在2026年10月23日的晨報,同一期還有 6 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈METR 找出 OpenAI 監控覆蓋面缺口。只對舊系統〉,https://secondsource.io/news/2026-10-23-1/,取用日期取用。