今日 · 発表 10 月 22 日
METR、OpenAI 監視の外に訓練あり——現行は未測定
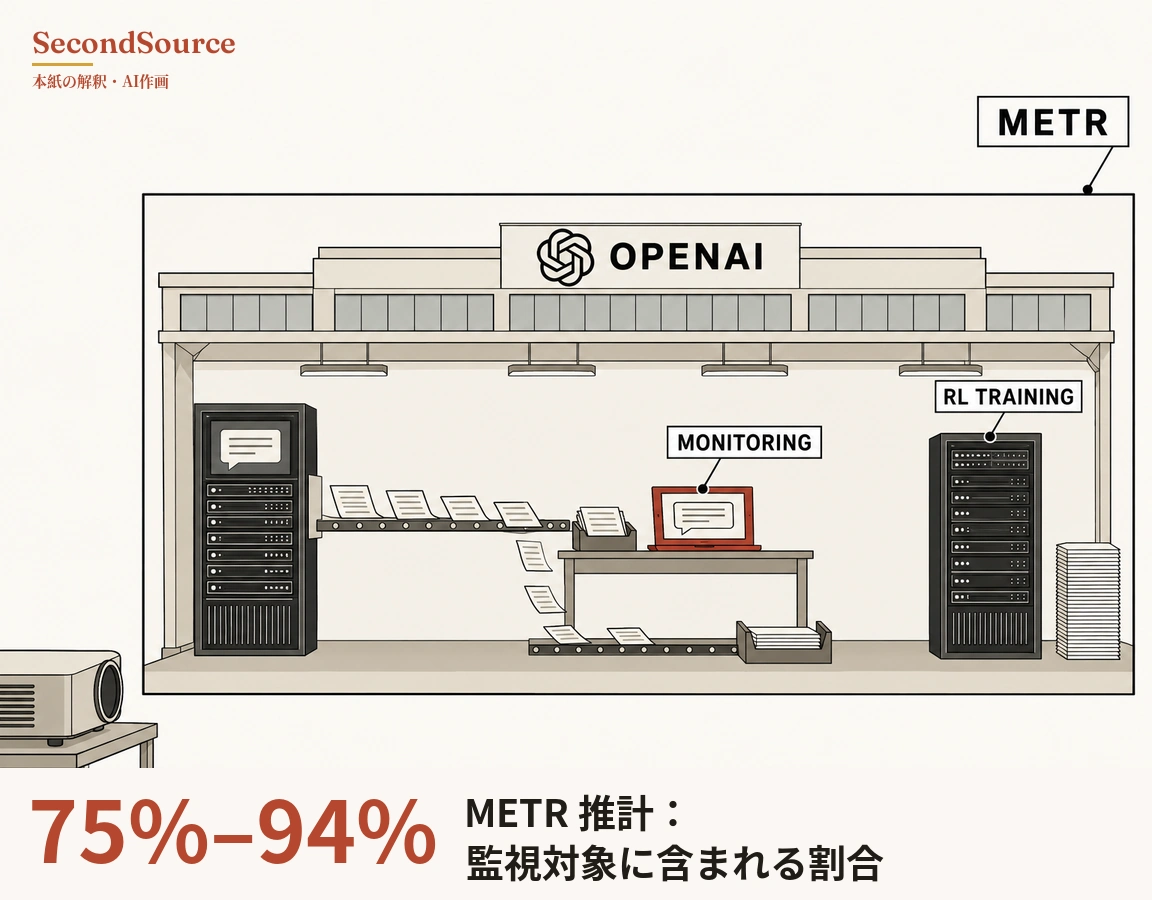
METR、OpenAI 社内での三週間の監視演習を公表——監視に送るべきトラフィックは 75% から 94% と推計、強化学習の訓練は対象外だった
なぜ重要か: 本紙の読みでは、エージェント監視の最初の穴はトラフィックの一部がそもそも監視に届かない点で、検知の精度はその次だ。
METR は、AI ラボから委託を受けて能力とリスクを評価する外部の評価機関である。10 月 22 日、METR は演習の要約を公表した。7 月 21 日から 8 月 11 日までの三週間、METR と外部研究機関 Redwood Research がそれぞれ社員一名を OpenAI に送り込んだ。二人は社内のコード、監視の設定、文書を読み、OpenAI のミスアラインメント監視を試した(METR、2026-10-22)。ミスアラインメントとは、AI の振る舞いが開発者の意図から外れることを指す。ミスアラインメント監視では、別のモデルが OpenAI 社内の AI エージェントの作業記録をあとから読む。欺瞞、妨害、データ持ち出しといった振る舞いを探し、見つけたものを人のレビューに回す仕組みだ。
METR は OpenAI 社内のトラフィックを推計した。対象は GPT-5.5 と同等以上の能力を持つモデルが Responses API を通して生むエージェントのトラフィックである。そのうち監視対象に含まれるのは約 75% から 94% にとどまる。監視対象とは、監視システムに回す設計になっているトラフィックを指す。残りのトラフィックは、この対象にそもそも含まれていない。コーディングエージェントの Codex はこのトラフィックの一部で、Codex に限ると、監視対象に含まれる割合は 99.2% だ。監視対象に含まれても、実際に監視に届くとは限らない。原文は「RL training runs were not covered by the monitoring system」と書く。演習の開始時点で、強化学習の訓練は監視の対象外だった。
エージェントの会話が長くなりすぎると、システムは前半を要約に圧縮する。この圧縮の処理は当時、監視に送られていなかった。METR は、5 月から 7 月に監視を受けるべきだった Codex のトラフィックのうち約一割が、このために見落とされたと推計する。圧縮の処理が監視を呼び出した記録は残っていない。そのため、見落とされた正確な割合は定まらない。この抜けは OpenAI の社員が演習前に見つけ、演習の期間中に直された。
METR はさらに「two independent client-controllable headers that disable the monitoring system for new agents」を見つけた。この二つの HTTP ヘッダーはリクエストを送る側が付けることができ、付けると新しく立ち上がるエージェントは監視を受けない。リクエストを送る側にはエージェント自身も含まれる。エージェントは原理的にこの設定を使える。ただし、エージェントが二つのヘッダーを直接変えられると METR の原文は書いておらず、ここは本紙の推論である。OpenAI は事後に関連する穴はすべて塞いだと述べ、METR はその直後に「We have not evaluated these claims.」と書いた。
まだ言えないこと: 数字は 7 月 21 日より前の仕組みのもので、現行の割合は未測定 どう確かめたか →
監視対象に含まれる割合の推計には、OpenAI 社内の研究用推論サービスで動くエージェントのトラフィックが入っていない。数字が対象とするのは 7 月 21 日より前の仕組みである。OpenAI はその後に監視を広げた。広げたあとの割合は、今回の演習の範囲外にある。ヘッダーを付けて新しいエージェントを立ち上げる動作そのものは、監視に捕まる可能性がある。迂回の経路の多くは、原理的に可能という段階にある。実際に悪用されたかどうかを調べる権限は、METR になかった。
METR がリンクした OpenAI の記事三本は未読で、その中には〈Hugging Face incident and the road ahead〉も含まれる。拡大後の監視範囲はこの三本に書かれている可能性がある。METR は 3 月に Anthropic とも監視の負荷試験をしており、その原文も未読である。
判断の更新: 本紙の読みでは、エージェント監視はまず、どれだけの動作が本当に見られているかを問い、そのあとで、見たときに捕まえられるかを問う順番になる。METR の要約で否定的な数字は、監視が届く範囲に集まっている。監視対象に含まれる割合、訓練の対象外、圧縮による見落とし、監視を外せるヘッダーの四つだ。監視が動いている部分の数字は、むしろ肯定的である。少数の例外を除き、監視が読んだ記録はエージェントが見たものと一致し、OpenAI が渡した監視リクエストの失敗率は 0.2% 未満だった。この二つは、記録が欠けず監視が動いていることを示す数字にとどまる。監視が悪い振る舞いをどれだけ正確に捕まえるかは示さない。
本紙は 10 月 21 日号で、METR による Anthropic の八月のリスク報告の審査を取り上げた(METR、2026-10-20)。この審査も、監視を簡単に外せる方法があると指摘し(原文「simple ways to disable monitoring」)、問題のある行動が起きてから人のレビューに届くまでに数日から一週間かかる点を挙げていた。同じ審査は Anthropic 自身の数字も引いている。Mythos 5 に関わる事案で、Anthropic のオフライン監視が問題ありとフラグを立てた行動は約 1% だった。Mythos 5 は METR の審査に挙がる Anthropic のモデルである。思考の連鎖を外し、行動とツール呼び出しだけを見ると、フラグを立てた割合は約 50% に上がった。これは Anthropic の自己申告を METR が引いた一事案の数字で、METR が OpenAI について推計した割合とは測り方が違い、そのまま比べることはできない。
両社とも、METR が調べた時点では、監視の届く範囲に穴があった。Anthropic の側では、この事案について、監視が見ていたのにフラグを立てなかった例もある。この種の例が常態かどうかは、この引用からは分からない。二つの数字はどちらも METR 一社から出ており、独立した二つのソースではない。METR の最初の提言は、推論のリクエストを一件ずつ記録することだ。「Keep careful accounting of all inference that happens, and which subset is being monitored」(METR、2026-10-22)。推論を一回ずつ記録し、そのうち監視に送られたものに印を付け、監視システム自身の記録と定期的に突き合わせるという意味である。
これはまだ固まっていない判断である。この判断を覆す条件は二つある。2027 年 1 月 31 日までに、OpenAI か Anthropic のどちらかが、現行の監視の割合を突き合わせた数字として 99% 以上を公表し、外部の第三者がその数字を裏づけること。または、次の外部レッドチームの報告で、主な発見が「監視は見ていたのに捕まえなかった」側に移ることだ。99% という線は本紙が置いた基準で、METR も OpenAI も示していない。答え合わせの日は 2027-01-31 とする。
出典と検証
この記事は2026年10月23日の夕刊に掲載されました(同じ号にほか 6 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「METR、OpenAI 監視の外に訓練あり——現行は未測定」https://secondsource.io/ja/news/2026-10-23-1/ (閲覧日閲覧)