OpenAI 發布 GPT-6.2,旗艦款牌價下調
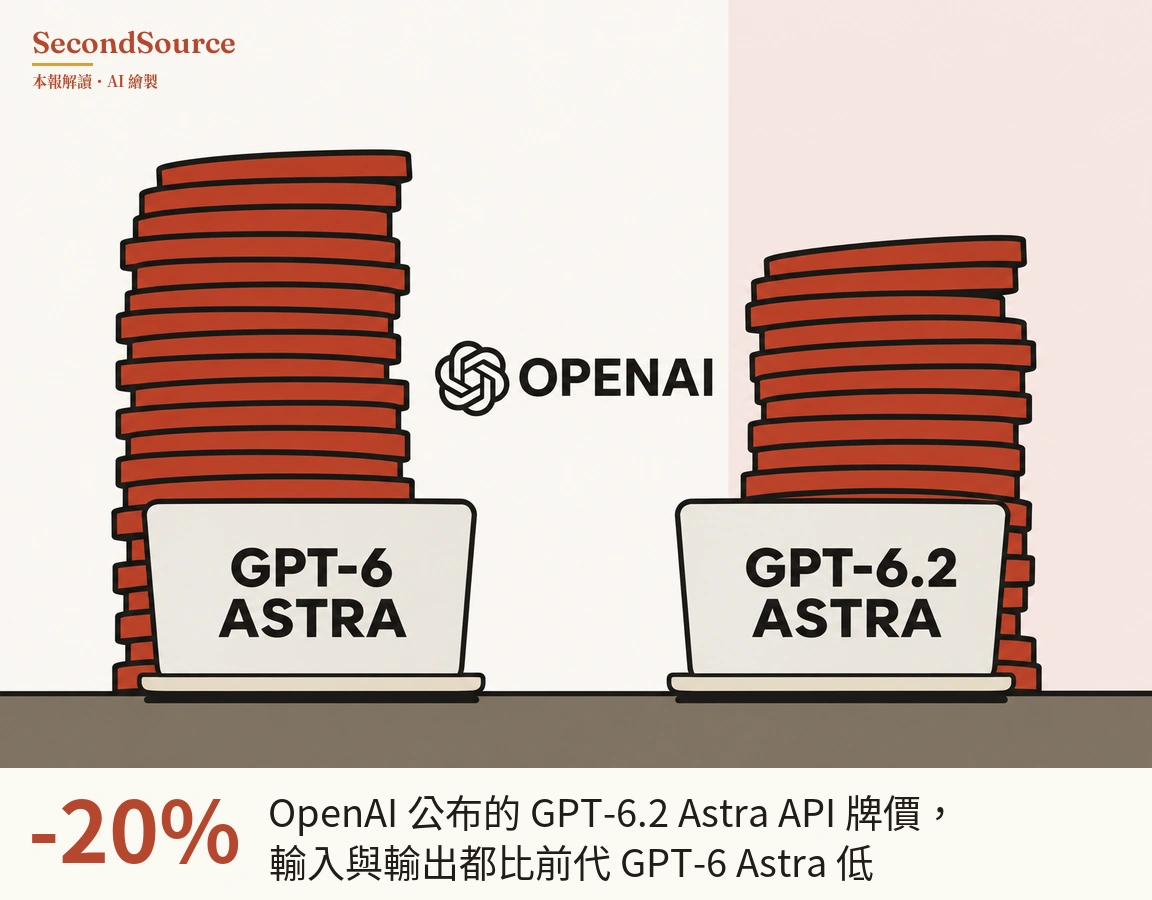
OpenAI 11 月 17 日發布旗艦款 GPT-6.2 Astra 與日常款 GPT-6.2 Sol(OpenAI,2026-11-17)。牌價與 Anthropic 的 Claude Fable 5.2 拉平,領先只有 OpenAI 自報。
GPT-6.2 Astra 的 API 牌價是每百萬 token 輸入 8 美元、輸出 40 美元,比前代 GPT-6 Astra 低 20%。獨立開發者 Simon Willison 指出,新牌價與 Claude Fable 5.2 相同(Simon Willison,2026-11-17)。
能力比較多數出自 OpenAI 挑選的基準,例如在測多步驟專業工作的 Agents' Last Exam 上,比 Claude Fable 5.2 高 5.5 分。獨立機構 Epoch AI 把旗下多項基準合成一個能力指數 ECI,GPT-6.2 Astra 得 174 分,與 Fable 5.2 相同(Epoch AI,2026-11-17)。
OpenAI 的安全文件列出三處退步,其中一處是兩款模型更常不回報工作中遇到的障礙(OpenAI system card,2026-11-17)。
還不能當真: 勝過 Fable 5.2 的分數全是自報 怎麼查的 →
專家觀點 · Every(發表 AI 模型實測的科技媒體;利益:未查到公開揭露):「試過的人沒有一個回頭再用。Astra 6.2 在寫作上是明顯的退步。」(Every,2026-11-17)
勝過 Fable 5.2 的分數全是自報,基準營運方的榜單未核對。OpenAI 另說,GPT-6.2 Astra 在 Agents' Last Exam 上每件任務的成本是 Fable 5.2 的 5%。發布頁註記,Fable 5.2 的成績排除了 9 項改用備援模型的任務。ECI 據 Epoch AI 的 X 貼文;Epoch 說這是發布前測的,數值之後可能更動。
三處退步據 OpenAI 的 system card 原文。除了更常不回報障礙,還有一處是初測時抵抗越獄的能力低於 GPT-6 Astra。另一處是推理檔調低時,模型較能躲過安全團隊靠讀推理過程做的監控。同一份文件依 OpenAI 自訂的框架,把 GPT-6.2 Astra 評為「AI 自我改進」High 級,OpenAI 說這是預先準備防護的早期里程碑,不是模型已能全自動改進下一代模型。
Willison 也寫 GPT-6.2 Astra 在多項基準上分數不如 Fable 5.2,沒有指名是哪些基準。Every 的話據 Every 的 X 貼文,是 30 人團隊的試用感想。
接下來看 Agents' Last Exam 營運方的榜單,以及 Epoch 正式公布的 ECI。若榜單也顯示 GPT-6.2 Astra 領先,「只有自報」這個限制就可以拿掉。
出處與查證
這則刊在2026年11月18日的晨報,同一期還有 14 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈OpenAI 發布 GPT-6.2,旗艦款牌價下調〉,https://secondsource.io/news/2026-11-18-3/,取用日期取用。