OpenAI が GPT-6.2 を公開、最上位版の定価を下げる
OpenAI は 11 月 17 日、最上位版の GPT-6.2 Astra と日常向けの GPT-6.2 Sol を公開した(OpenAI、2026-11-17)。定価は Anthropic の Claude Fable 5.2 と並び、上回るという成績は OpenAI の自己申告だけである。
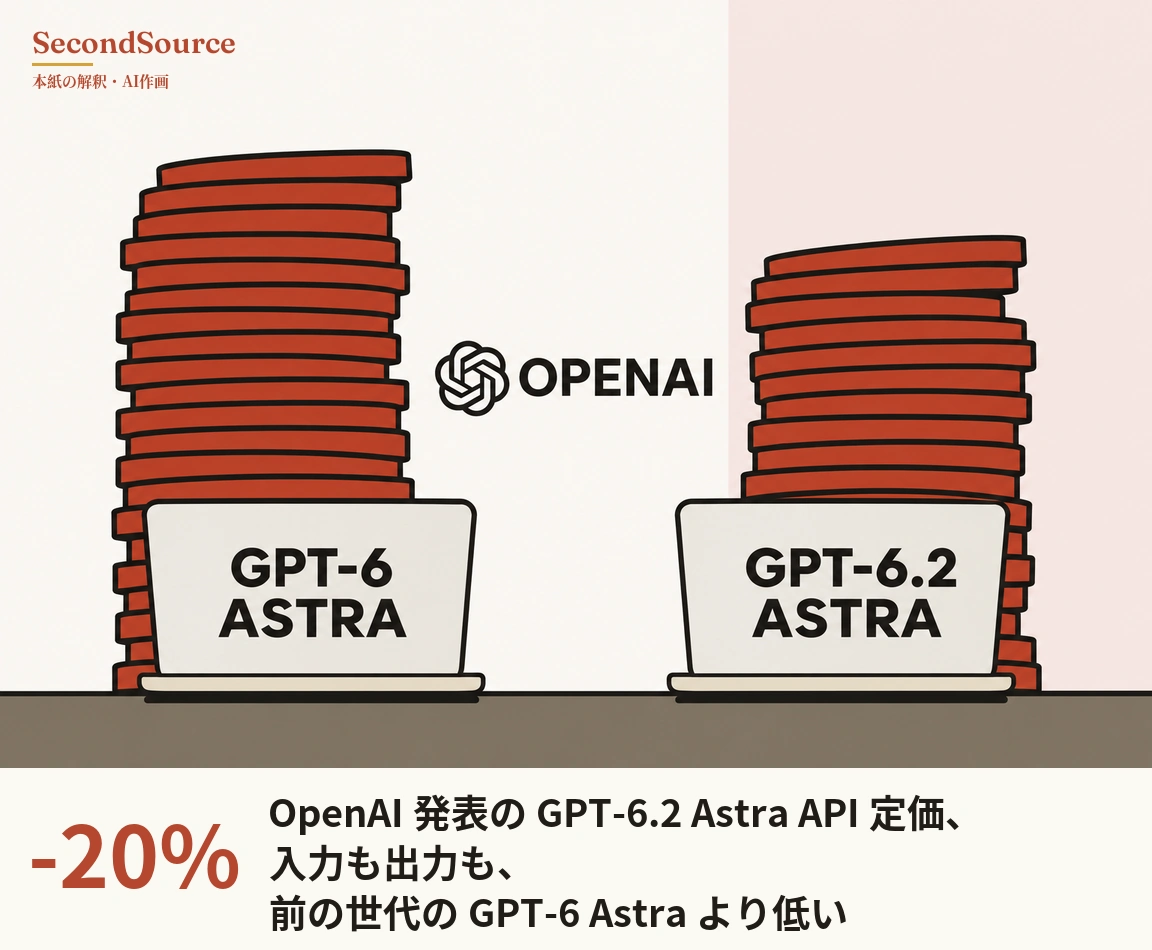
GPT-6.2 Astra の API の定価は、100 万トークンあたり入力 8 ドル、出力 40 ドルで、前の世代の GPT-6 Astra より 20% 安い。独立開発者の Simon Willison 氏は、新しい定価が Claude Fable 5.2 と同じだと指摘した(Simon Willison、2026-11-17)。
能力の比較の多くは OpenAI が選んだベンチマークによる。たとえば複数の手順にわたる専門的な仕事を測る Agents' Last Exam で、GPT-6.2 Astra は Claude Fable 5.2 を 5.5 ポイント上回った。独立した立場で AI モデルの能力を測る Epoch AI は、自社の複数のベンチマークを一つの能力指数 ECI にまとめており、GPT-6.2 Astra は 174 点で Fable 5.2 と同じだった(Epoch AI、2026-11-17)。
OpenAI の安全性文書は後退した点を三つ挙げ、その一つは、二つのモデルが作業中にぶつかった障害を報告しないことが増えた点である(OpenAI system card、2026-11-17)。
まだ言えないこと: Fable 5.2 を上回る点数はすべて OpenAI の自己申告 どう確かめたか →
専門家の見方・Every(AI モデルの実地評価を発表するテック媒体。利害:公開の開示は見つかっていない): Every はチームの試用の感想として「No one on our team who tried it switched back to it. Astra 6.2 is a real step back for writing.」と書いた。試したメンバーで Astra 6.2 に戻って使い続けた人はおらず、文章を書く用途では明らかな後退だという評価である(Every、2026-11-17)。
Fable 5.2 を上回る点数はすべて自己申告で、ベンチマーク運営者のランキングとはまだ照合されていない。OpenAI はさらに、Agents' Last Exam での GPT-6.2 Astra のタスク一件あたりのコストは Fable 5.2 の 5% だとする。発表ページの注記によると、Fable 5.2 の成績からは、予備のモデルに切り替えた 9 件のタスクが除かれている。ECI は Epoch AI の X の投稿に拠り、Epoch は公開前に測った値で今後変わりうるとしている。
三つの後退は OpenAI の system card の原文に拠る。障害を報告しないことが増えたほかに、初期の試験でジェイルブレイクへの耐性が GPT-6 Astra より低かった点がある。もう一つは、推論の段階を下げたとき、推論の過程を読む安全チームの監視をモデルがすり抜けやすくなる点である。同じ文書は OpenAI 独自の枠組みで、GPT-6.2 Astra を「AI の自己改善」で High の段階と評価した。OpenAI は、これは防護を前もって用意するための早い段階の目印であり、モデルが次の世代のモデルを全自動で改良できるようになったという意味ではないと説明する。
Willison 氏は、GPT-6.2 Astra が複数のベンチマークで Fable 5.2 より低い点数だったとも書いたが、どのベンチマークかは挙げていない。Every の評価は Every の X の投稿に拠り、30 人のチームの試用の感想である。
次に注目するのは、Agents' Last Exam の運営者のランキングと、Epoch が正式に公表する ECI である。運営者のランキングでも GPT-6.2 Astra が上回っていれば、「自己申告だけ」という限定は外せる。
出典と検証
この記事は2026年11月18日の夕刊に掲載されました(同じ号にほか 14 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「OpenAI が GPT-6.2 を公開、最上位版の定価を下げる」https://secondsource.io/ja/news/2026-11-18-3/ (閲覧日閲覧)