本週 · 論文 10 月 8 日投稿
Internalizer 把文件轉成附加權重。只測短文件
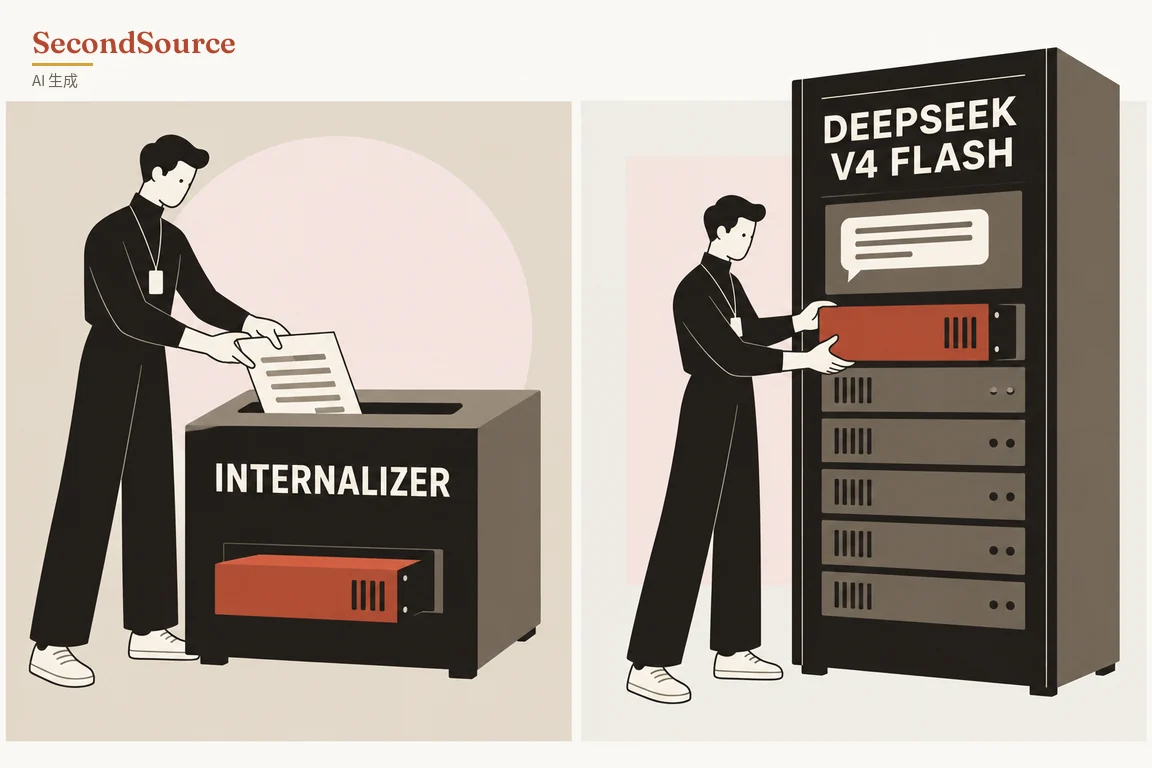
預印本 Internalizer 把一份文件一次轉成附加在模型上的小組權重,做在 2,840 億參數的 DeepSeek V4 Flash 上;先前同類方法最大只做到 140 億參數。 方法是用一個專門產生權重的小模型讀文件,輸出一組 LoRA,也就是只改少量參數、掛在原模型外面的附加層(標題說的小組權重就是它),原模型本身不動。摘要寫,測試用的是 4,096 個 token 以內、模型沒看過的文件,模型的輸入裡只有三個字的指令、不放文件。token 是 AI 讀寫文字時的計量單位,一小段字算一個,用得越多收費越高。量法是給定正確的前文,讓模型列出它認為最可能的下一個 token,看正確答案是不是排第一、是不是在前五:掛上附加層後排第一的比例是 84.9%、在前五的是 97.8%;同一個原模型、輸入裡同樣不放文件,是 63.4% 與 83.5%(arXiv 2610.11715)。摘要沒有拿它跟「把文件直接放進輸入」的做法比。論文原話是規模比過去大兩個數量級;本報用 140 億對 2,840 億算,只有約 20 倍,兩者為什麼對不上,摘要沒有說明。意義在成本:現在要模型記得一份文件,得每次把文件塞進輸入或另建檢索系統。這是本報的讀法:附加層產生一次之後,每次提問就不必把整份文件再送進輸入;若產生附加層的成本與延遲夠低,每位客戶、每份文件各掛一組附加層才會成為選項。要看的是:論文會不會公開程式碼與權重、有沒有別人做出相同結果、產生一組附加層要花多少成本和時間。⚠️ 論文自報、本報只讀摘要;猜中下一個 token 不等於回答問題答得對,也只測了短文件,產生附加層的成本與延遲摘要沒給。
出處
引用這則
SecondSource(2026),〈Internalizer 把文件轉成附加權重。只測短文件〉,https://secondsource.io/research/2026-10-11-1/,取用日期取用。