今週 · 10 月 8 日投稿の論文
Internalizer、文書をアダプタ化——数字は自己申告
プレプリント Internalizer は、一つの文書を一度で、モデルに付け足す軽量アダプタ(LoRA)に変える。2,840 億パラメータの DeepSeek V4 Flash で実施しており、これまでの同種の手法は最大でも 140 億パラメータだった。 手法はこうだ。重みを生成する専用の小型モデルが文書を読み、LoRA を一組出力する。LoRA は、ごく一部のパラメータだけを変えて元のモデルの外側に掛けるアダプタで、見出しの「軽量アダプタ(LoRA)」がこれにあたる。元のモデル自体には手を付けない。要旨によると、テスト文書は 4,096 トークン以内で、モデルが見たことのないものに限った。入力に入れたのは三語の指示だけで、文書そのものは入れていない。トークンとは AI が文章を読み書きするときの処理単位で、数文字ごとに 1 つと数え、使うほど料金が上がる。
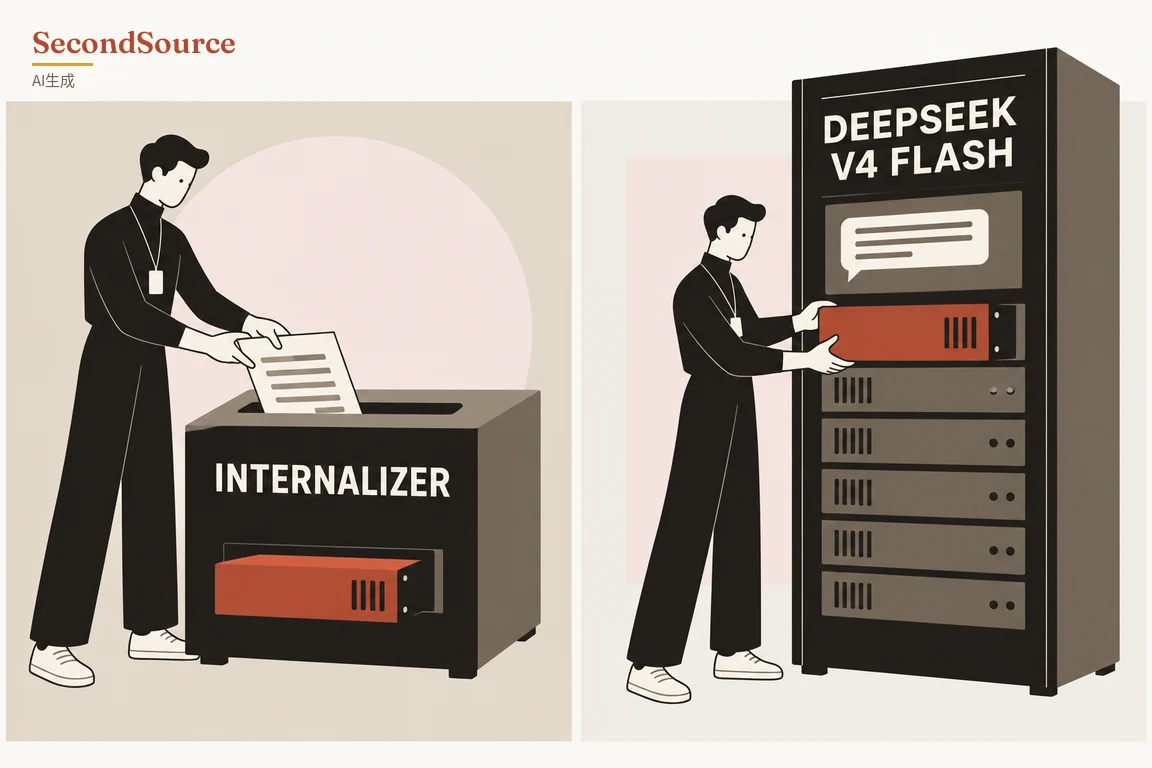
測り方は、正解の直前までの文脈を与え、モデルが最も確からしいと見る次のトークンを挙げさせ、正解が一位か、上位五つに入るかを見るというもの。アダプタを掛けると、正解を第一候補に挙げる割合は 84.9%、上位五候補に入る割合は 97.8% だった。同じ元のモデルに、同じく文書を入れずに聞いた場合は 63.4% と 83.5% である(arXiv 2610.11715)。要旨は、文書を入力に直接入れるやり方との比較をしていない。論文は規模が従来より二桁大きいと書くが、140 億と 2,840 億で計算すると約 20 倍にとどまる。なぜ食い違うのか、要旨に説明はない。
この手法の意義はコスト面にある。いまモデルに文書を覚えさせるには、毎回文書を入力に詰め込むか、別に検索の仕組みを組む必要がある。以下は本紙の読みだ。アダプタを一度生成すれば、質問のたびに文書全体を入力に送り直さずに済む。アダプタを生成するコストと遅延が十分に小さければ、顧客ごと、文書ごとにアダプタを一組ずつ掛けることが選択肢に入ってくる。見るべき点は三つある。論文がコードと重みを公開するか、他者が同じ結果を出せるか、アダプタ一組の生成にどれだけのコストと時間がかかるかだ。⚠️ 論文の自己申告で、本紙が読んだのは要旨だけ。次のトークンを当てることは質問に正しく答えることと同じではなく、試したのも短い文書だけで、アダプタを生成するコストと遅延は要旨に示されていない。
出典
この記事を引用
SecondSource(2026)「Internalizer、文書をアダプタ化——数字は自己申告」https://secondsource.io/ja/research/2026-10-11-1/ (閲覧日閲覧)