印度語音 AI 公司 Gnani.AI 的研討會論文自報,強化學習後 MATH 數學基準分數大漲,作者說約 95% 的升幅來自模型更常把答案寫進評分器要求的答案框。
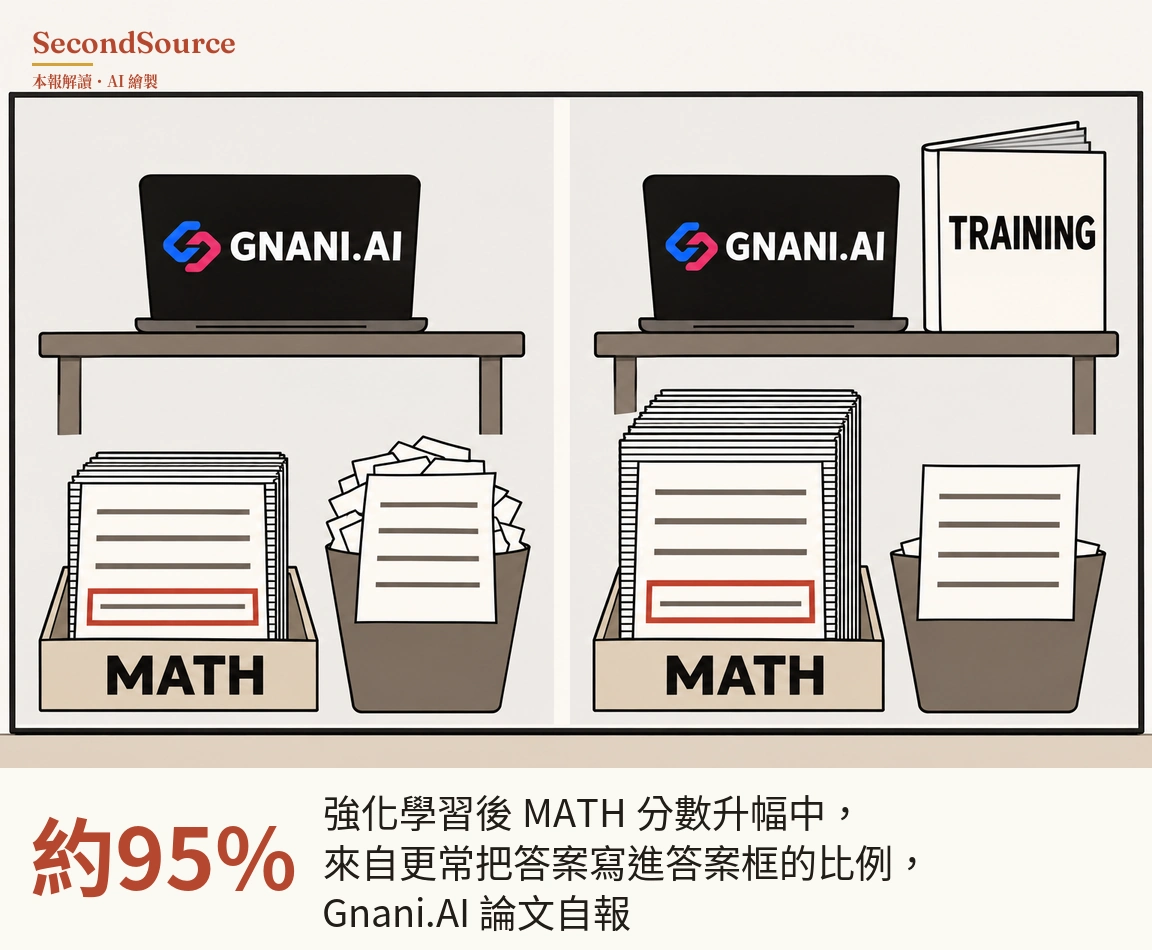
分數升幅主要來自作答格式、加框後的正確率幾乎沒變,這是單一訓練種子、Gnani.AI 測自家模型的結果。MATH 的評分器只從答案框裡抽答案,沒加框就算錯。據論文,MATH 分數從 48.69 升到 84.76,加框的比例從 55.2% 升到 91.6%,加框後的正確率只從 91.1% 到 92.6%。據第二篇論文,只獎勵任務結果的訓練讓印度語系問答 XQuAD-Indic 的 F1 分數從 36.51 掉到 17.19。F1 是衡量答案和標準答案重合多少的分數。作者把下滑歸給模型改用英語作答,比例從 8.7% 升到 91.7%。兩篇論文出自同一組作者,還沒有別人重做(arXiv 2611.15717,2026-11-11;arXiv 2611.16228,2026-11-12)。 怎麼查的 →
出處與查證
這則刊在2026年11月15日的晨報,同一期還有 9 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈印度語音 AI 公司 Gnani.AI 的研討會論文自報,強化學習後 MATH 數學基準分數大漲,作者說約 95% 的升幅來自模型更常把答案寫進評分器要求的答案框。〉,https://secondsource.io/research/2026-11-15-1/,取用日期取用。