インドの音声 AI 企業 Gnani.AI は学会論文で、強化学習の後に数学ベンチマーク MATH の点数が大きく上がったが、上げ幅の約 95% はモデルが採点プログラムの求める解答枠に答えを書くことが増えた結果だったと自己申告している。
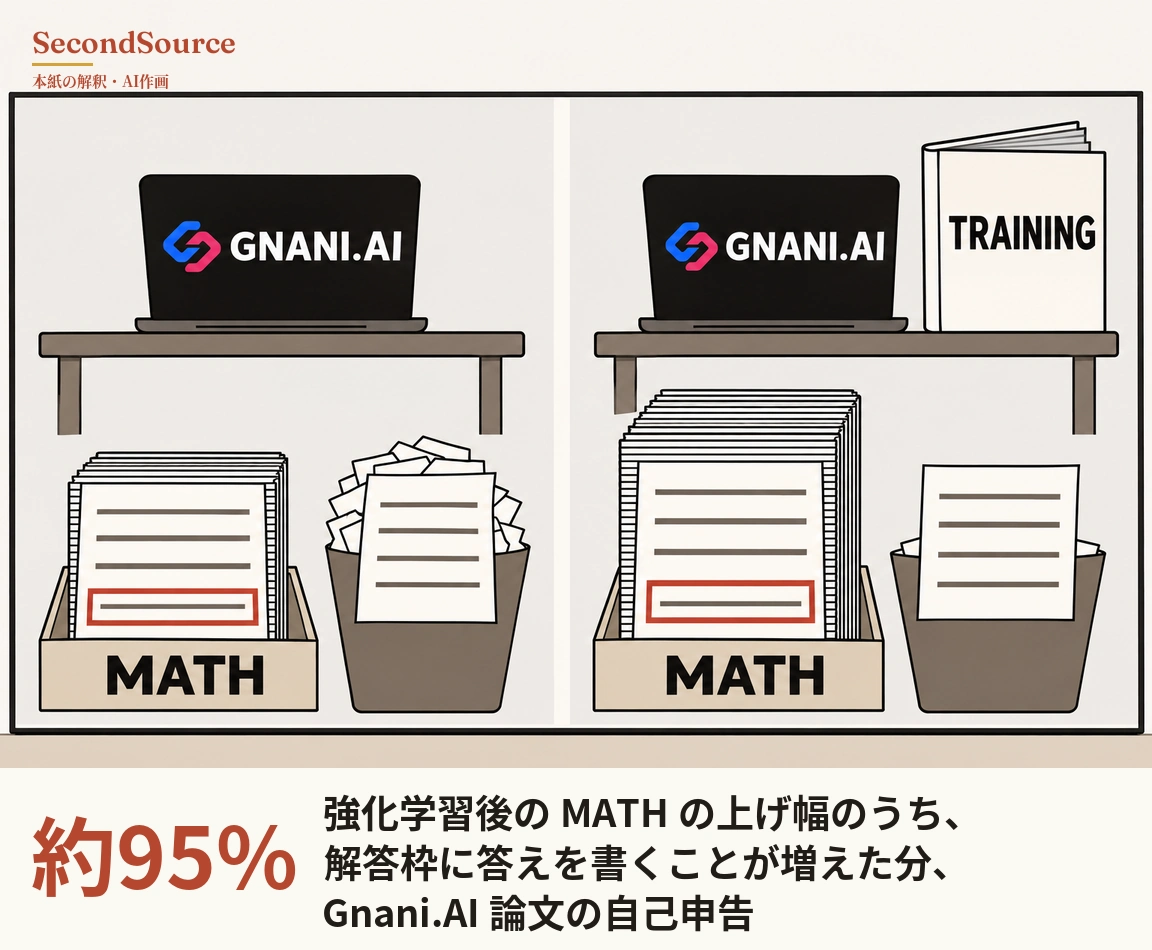
点数の上げ幅の大半は解答の書式から来ており、枠に書いた答えの正答率はほとんど変わらなかったが、これは一つの訓練シードで Gnani.AI が自社のモデルを試した結果である。MATH の採点プログラムは解答枠の中からだけ答えを取り出し、枠に書かなければ不正解になる。論文によると、MATH の点数は 48.69 から 84.76 に上がり、答えを枠に書いた比率は 55.2% から 91.6% に上がったが、枠に書いた答えの正答率は 91.1% から 92.6% にしか上がっていない。同じ著者グループのもう一本の論文によると、課題の結果だけに報酬を与える訓練で、インド諸語の質問応答 XQuAD-Indic の F1 スコアは 36.51 から 17.19 に下がった。F1 スコアは、答えが模範解答とどれだけ重なるかを測る点数である。著者らはこの低下を、モデルが英語で答えるようになったためとし、英語で答えた比率は 8.7% から 91.7% に上がった。二本の論文は同じ著者グループによるもので、まだ誰も再現していない(arXiv 2611.15717、2026-11-11;arXiv 2611.16228、2026-11-12)。 どう確かめたか →
出典と検証
この記事は2026年11月15日の夕刊に掲載されました(同じ号にほか 9 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「インドの音声 AI 企業 Gnani.AI は学会論文で、強化学習の後に数学ベンチマーク MATH の点数が大きく上がったが、上げ幅の約 95% はモデルが採点プログラムの求める解答枠に答えを書くことが増えた結果だったと自己申告している。」https://secondsource.io/ja/research/2026-11-15-1/ (閲覧日閲覧)