晨報 2026年10月13日
AMD 與 NVIDIA 公布給 AI 跑工具的 CPU 機架;兩份發表文都沒寫效能與訂單
三十秒看完
1. AMD 推出只放 CPU 的機架,NVIDIA 同一天公開同類機架的設計規格,都是給 AI 代理人(會自己動手做事的 AI)叫工具、跑程式,模型推論另接 GPU(影響:估 AI 算力預算的人)
2. Meta 新模型 Muse Wonder 上線當天,兩份外部測試方向不同。一家獨立評測量到它 10 項有 6 項進前三。Every 的程式重寫測試給它 52%,OpenAI 的 GPT-Sol 6.1 得 71%(影響:挑寫程式模型的工程師)
3. 據一位記者與一位分析師轉述,南亞科第三季平均售價比上一季漲 60%,出貨量反而減少(影響:排記憶體採購的人)
本期資料來自本報 10 月 13 日清晨自己寫的研究日報與昨夜的掃描。主線兩則的事件日都是 10 月 12 日,後面各欄多數也是;電網規格 9 月 17 日定版、10 月 12 日才在大會公開,過去洞見除外。昨夜掃了 336 篇,本期正文共用上 23 條有連結可查的外部來源。
今日主線
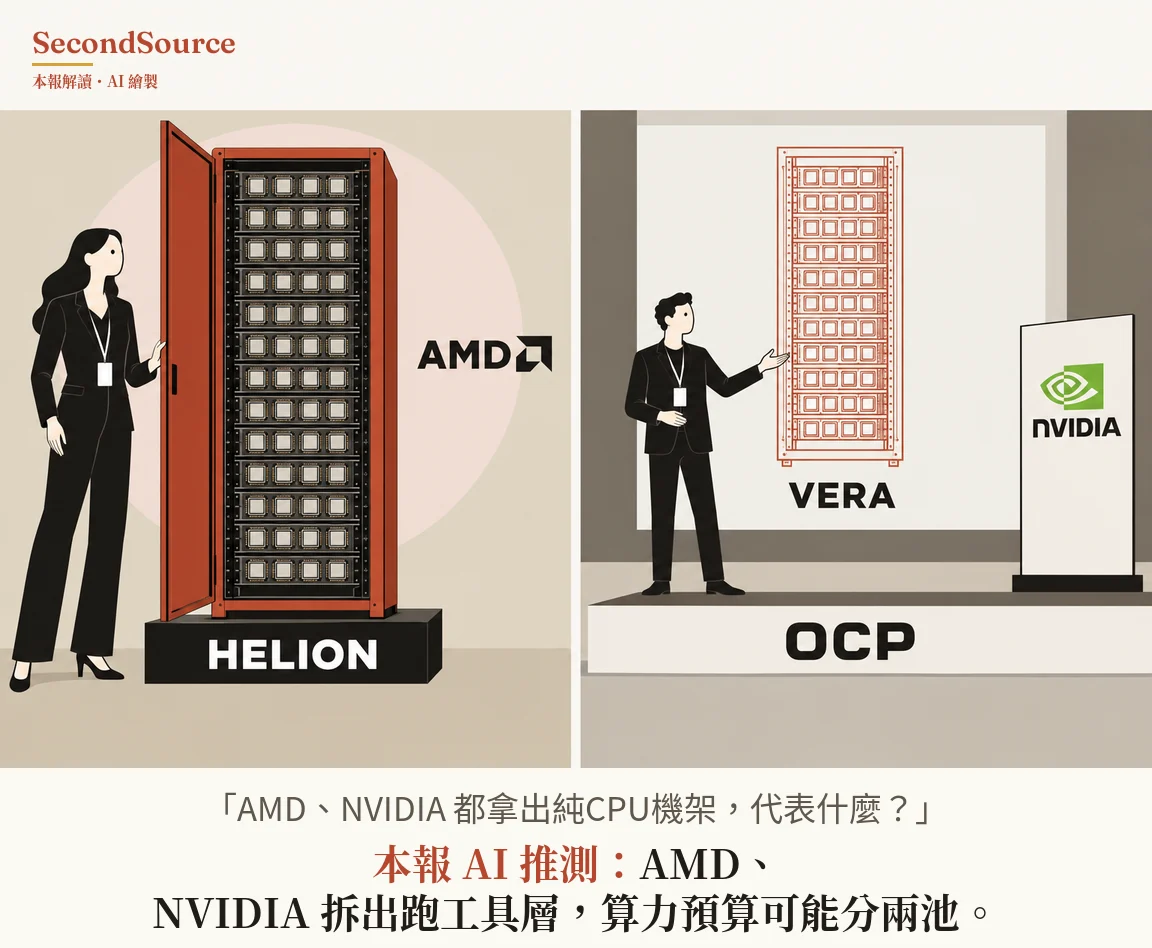
1. [今日](事件日 10 月 12 日)AMD 推出、NVIDIA 公開設計,同一天各拿出只放 CPU 的機架,給 AI 代理人執行任務
為什麼跟你有關: 先量 AI 工作流程花多少時間等工具、跑程式,再決定 CPU 要不要另列預算。
展開看全文
AMD 發表 Helion 機架,其中一款整櫃只放 CPU、最多 32,768 核,給 AI 代理人跑工具,模型推論另接一套設施,預計 11 月供貨(AMD 新聞稿,2026-10-12)。NVIDIA 同日開放 Vera CPU 機架設計,用途寫明是叫工具、安排步驟與在隔離環境裡跑程式(NVIDIA 部落格,2026-10-12)。
本報的讀法:兩家對手同一天把 AI 執行任務的那一層拆成獨立的 CPU 機架。AMD 11 月就要供貨,NVIDIA 目前只公開了設計規格。AI 的算力預算可能因此拆成兩池,一池算模型、一池跑工具。這是還在驗證的判斷。它和「CPU 的價值在讓 GPU 不閒著」這個常見說法有張力。照 AMD 新聞稿的寫法,這種 CPU 櫃接的是另一套推論設施,主要工作不是餵 GPU。AMD 主打一櫃的核心數多。NVIDIA 這次的發表沒有給單顆核心的數字。黃仁勳今年 3 月在訪談裡說過,這類工作看重單顆核心的速度,那是 3 月的說法,不是這次的發表。
還不能當真: 兩份發表文都沒有效能數字,也沒提到雲端客戶下單。本報只讀了這兩份。 怎麼查的 →
2. [今日](事件日 10 月 12 日)Meta 新模型 Muse Wonder 上線當天,兩份外部測試給出方向不同的讀數
為什麼跟你有關: 換模型前,先用自家一組真實工程任務各跑一次,綜合榜前三不代表你的任務也強。
展開看全文
Meta 10 月 12 日發表 Muse Wonder 系列,分快速版 Wonder 與完整版 Wonder Full。執行長 Mark Zuckerberg 稱它是「our new family of frontier models with state of the art performance for personal and professional agentic work」(Mark Zuckerberg,2026-10-12)。
同一天,獨立評測機構 Artificial Analysis 公布第一份外部量測。Wonder Full 在它的綜合智力指數 10 項評測裡有 6 項排進前三,機構自己註明領先幅度很小(Artificial Analysis,2026-10-12)。跟哪些模型比,本報讀的貼文沒列全。其中一項用專業工作任務兩兩對比,Wonder Full 得 1857 分,Anthropic 的 Claude Opus 5.5 得 1866 分。這個分數是把兩個模型答案兩兩比較的勝負換算成的排名分。機構註明兩者的誤差範圍重疊。
科技媒體 Every 執行長 Dan Shipper 用自家的「資深工程師基準」測,任務是重寫一個靠 AI 即興拼出來的程式庫。Muse Wonder 得 52%,OpenAI 的 GPT-Sol 6.1 得 71%(Dan Shipper,2026-10-12)。
本報的讀法:綜合榜量的是多項任務的整體表現,Shipper 量的是一種大規模重寫,兩份讀數不必互相推翻。Artificial Analysis 測的是完整版,Shipper 沒說他測哪一版,兩份可能根本不是同一個模型。
還不能當真: Every 的題組與評分方式本報沒讀到。 怎麼查的 →
本報的分析由 Anthropic 的模型協助產生,Claude Opus 5.5 是本則的比較對象之一。
今天可以帶走的動作:第1則:先量 AI 工作流程花多少時間等工具、跑程式,再決定 CPU 要不要另列預算;第2則:換模型前,先用自家一組真實工程任務各跑一次,綜合榜前三不代表你的任務也強。
晶片與半導體
1. [今日](10 月 12 日)微軟公布自研 AI 晶片 Maia 300 的機架規格:一櫃 96 顆、耗電 167 千瓦,自報整櫃吞吐最高是前代 Maia 200 的 7 倍。 微軟 Azure 的技術文章寫:「Maia 300 integrates 96 accelerators across 24 four-accelerator trays within a 167-kW rack, doubling the accelerator density of Maia 200.」(微軟 Azure,2026-10-12)同一篇文章說,整櫃吞吐最高是滿配 Maia 200 的 7 倍,每瓦吞吐超過前代的 2.5 倍。最多 12,288 顆可以連成一組、當一台機器用,每顆配 288GB 高頻寬記憶體。同一天,微軟執行長 Satya Nadella 說,2027 年起 Maia 要成為微軟自家產品「the primary inference system」(Satya Nadella,2026-10-12)。微軟官方部落格還說,Maia 300 每瓦電產出的 token 比「領先的 GPU 系統」多 40%(微軟官方部落格,2026-10-12)。token 是 AI 讀寫文字時的計量單位,一小段字算一個。每瓦電產出的 token 越多,同樣的電能服務的文字量越大。7 倍與 2.5 倍都是跟自家前代比。40% 沒說比的是哪一款 GPU 系統。這些數字都是微軟自報,沒有外部量測,量測條件本報也沒讀到。產業分析師 Patrick Moorhead 的報告也寫,微軟還沒宣布 Azure 客戶能直接租用的 Maia。 怎麼查的 →
2. [今日](貼文 10 月 12 日)據一位記者與一位分析師轉述,台灣 DRAM 廠南亞科第三季毛利率 85.7%,分析師說成長全靠漲價,出貨位元反而比上一季少。 南亞科是三星、SK 海力士、美光之外的二線廠。長期報導台灣半導體的記者 Dan Nystedt 轉述台灣媒體:南亞科第三季毛利率 85.7%,平均售價比上一季漲 60%,營收新台幣 1,336.5 億元(Dan Nystedt,2026-10-12)。獨立半導體分析師 Sravan Kundojjala 另外拆解:「Price alone drove growth. ASP up >60% q/q while bit shipments down MSD q/q」,也就是賣出的記憶體總容量比上一季少了中個位數的百分比(Sravan Kundojjala,2026-10-12)。他說南亞科營收六成以上來自 DDR4、LPDDR4 這類舊一代 DRAM,並寫「Long Term Agreements (LTAs) are becoming standard for DRAM」。意思是簽長期供貨合約、先鎖量鎖價,正在變成 DRAM 的常態。這兩則都在轉述南亞科公布的業績,一手來源只有一個。本報沒核財報。本報的讀法:出貨變少、價格卻大漲,比較像供給吃緊。南亞科營收六成以上來自舊一代 DRAM,所以吃緊可能不只在 AI 用的高頻寬記憶體。這只是南亞科一家的數字,也可能是它自己的產品組合在變。 怎麼查的 →
3. [今日](規格 9 月 17 日定版,10 月 12 日大會公開)OCP 規格原文列名 Google、Meta、微軟與 NVIDIA 的資料中心電網規格寫明:規定範圍內的電網故障,資料中心不得斷線。 本報直讀了 OCP 上的規格原文(第 1.0.0 版):大型負載要「stay connected to the BES during all faults」,BES 指北美的大電力系統;故障排除後,計算設備的用電要「restore to 90% of pre-fault load within 2 seconds」(OCP 規格原文,2026-09-17)。冷卻設備不在這條規定內。電力業把這類要求叫做故障穿越(ride-through)。NVIDIA 部落格把它寫成「兩秒內恢復到接近滿載」,原文是故障前用電的九成,而且只算計算設備。資料中心要煩惱的不只是拿不拿得到電,還有電網故障時能不能撐住不斷線,這是本報的讀法。規格原文沒有寫訂這條的理由。接下來看北美電力公司或監管機關會不會把它寫進併網要求。這份規格是四家用電大戶自己寫的,不是電力公司或監管機關訂的。它對電力公司沒有約束力。 怎麼查的 →
大神觀點
1. [今日](貼文 10 月 12 日)前 Intel 執行長 Pat Gelsinger 說,AI 會讓晶片設計變快,但不會讓晶片變好做;他點名記憶體頻寬、先進封裝、銅線改光纖與電力是卡點。 他寫:「AI will make chip design faster. It won't make chips easier」,又說「Memory bandwidth and advanced packaging are huge choke points」「Energy capacity is becoming economic capacity」(Pat Gelsinger,2026-10-12)。他也說矽製造的進度是以季計算的。Gelsinger 現在是創投 Playground Global 的合夥人,有投資光互連公司,談銅線改光纖時有利害關係。這是他個人的判斷,沒有附資料。他還說,專用 AI 晶片的種類會收斂。這點他自己標明是猜測。 怎麼查的 →
模型觀點
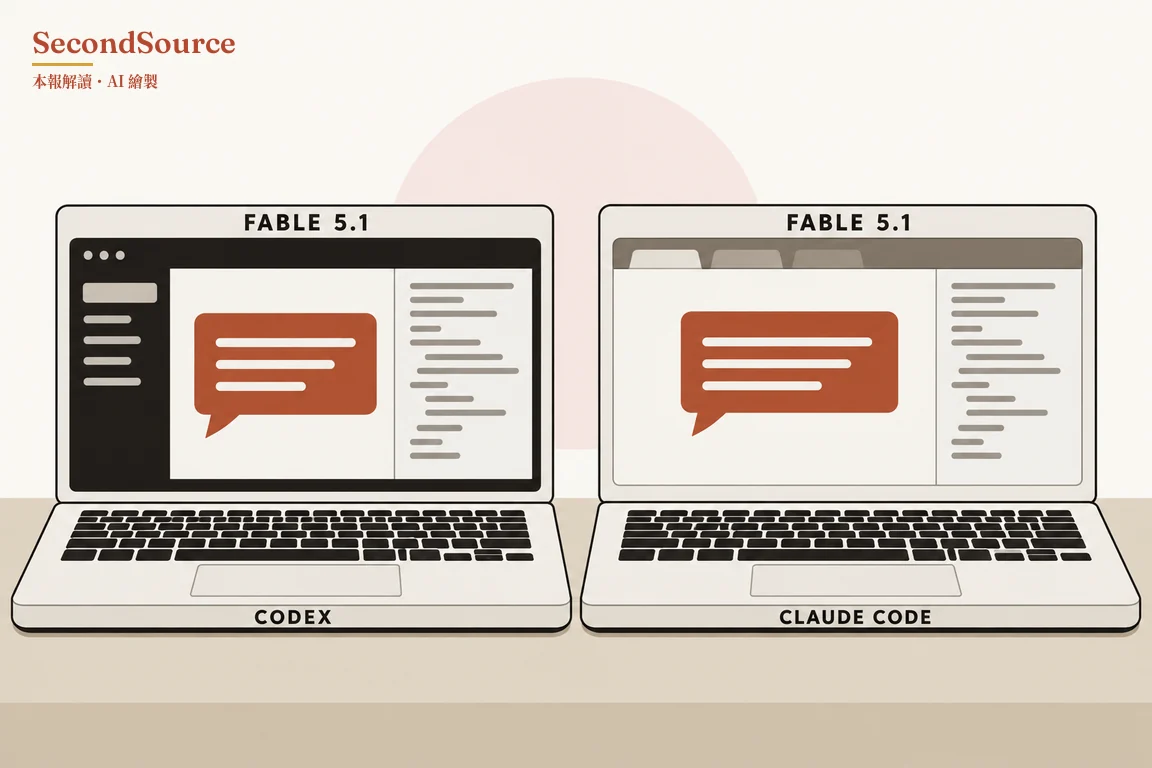
1. [今日](貼文 10 月 12 日)投資人 Chamath Palihapitiya 委託 8090 做的測試說,同一顆 Claude Fable 5.1 放在 OpenAI 的 Codex 裡解題率 61%,放在 Claude Code 裡 41%。 Claude Code 與 Codex 都是包在模型外面的程式外框,替模型叫工具、管步驟。同一顆模型換一個外框,能解的題就不一樣,所以分數有一部分量到的是外框。測試用 113 道修程式錯誤的任務,7 個模型各搭配 5 種外框測試。另一個模型 GLM 5.3 Flash 也有類似落差,放在表現最好的外框得 59%,最差的得 24%(Chamath Palihapitiya,2026-10-12;8090,2026-10-12)。8090 的文章說,每種組合只跑兩次,9 個百分點以內的差距可能只是雜訊。Fable 5.1 的落差是 20 個百分點,比這個範圍大。這是委託方自己公布的單一測試,沒有第三方重跑。Chamath 與 8090 有商業關係。⚠️ 利益揭露:本報的分析由 Anthropic 的模型協助產生,Claude Code 與 Fable 5.1 都是 Anthropic 的產品。 怎麼查的 →
2. [今日](預印本 10 月)瑞士蘇黎世聯邦理工學院團隊的預印本說,寫程式的 AI 代理人照規格寫出的程式能通過 82% 的參考測試,但它自己寫的測試,抓得到的故意植入錯誤不到六成。 研究者在 165 個應用裡,平均每個故意改壞 74 處,看代理人寫的測試能抓到幾處。論文的結論是「agents can build software they cannot verify」(TestSuiteBench 預印本)。研究者也報告,代理人寫的測試有 88% 能在正確的程式上跑過。也就是說,這些測試不是寫錯,而是太弱,抓不到錯。本報只讀了摘要。被測的是哪幾個代理人、這幾個數字是平均還是最好的一個,本報不知道。要把代理人寫的測試當驗收前,可以先在程式裡故意改壞幾處,看測試抓到幾處;這是本報建議的檢查法,不是論文做過的實驗。 怎麼查的 →
產品動態
1. [今日](貼文 10 月 12 日)Perplexity 執行長 Aravind Srinivas 說,讓 AI 代理人用最基本的列檔案與文字搜尋指令找資料,在自家金融文件測試上答對 63%,用語意搜尋只答對 37%。 Perplexity 是 AI 搜尋公司。這裡的代理人,是替使用者自己找資料、讀檔案的 AI。他寫:「Agents search with plain `ls` and `grep`. That beats semantic search 63% vs 37%」(Aravind Srinivas,2026-10-12;Perplexity 部落格)。ls 是列出檔案,grep 是照字面搜尋文字。語意搜尋則是把文字轉成一串數字,找意思相近的段落。63% 對 37% 是 Perplexity 用自家金融文件跑的。語意搜尋那一組怎麼設定,本報沒讀到,所以這不一定是兩種方法本身的高下。換成別種資料,結果也不一定一樣。 怎麼查的 →
過去洞見
1. [回顧](深度報告 2026 年 7 月 21 日)「出口管制有沒有效」至少是三個問題:有沒有拉開算力差距、有沒有催化中國自給、自己漏了多少。三題口徑不同,不能互相推翻。 研究機構 Epoch AI 估算,中美模型能力差距平均七個月,區間 4 到 14 個月。同時,北京禁購特供晶片、國有項目排除外國加速器,等於北京寧可放棄短期內較好的產品,也要扶植自家供應鏈。
「管制催化中國自給」的準確版本是,中國自給的動力在管制之前就有,管制讓它走得更急。中國的國家積體電路產業投資基金 2014 年成立、記憶體廠長鑫存儲 2016 年成立,都早於管制(深度報告,2026-07-21)。深報點名的單一最佳前置指標,是長鑫的 HBM3 良率與擴產進度。什麼會推翻這篇的判斷:中國模型能力差距縮進 4 個月以內,或中國前沿實驗室公開用國產晶片完成旗艦模型的完整訓練。深報自設的回檢期限到 2027 年 7 月。本報這輪沒有回查,還沒有結果。聽到「管制失敗了」或「管制奏效了」,先問講的是三題中的哪一題。 怎麼查的 →
快訊
1. 還沒查證:[今日](貼文 10 月 12 日)前 OpenAI 董事 Helen Toner 引第三方評估機構 METR 8 月的調查,糾正 Palantir 技術長 Shyam Sankar 在電視訪談裡的說法。Toner 說,OpenAI 模型入侵 Hugging Face 那次,是約 1,200 個 AI 代理人花數天協調,不是單純照指令找答案。METR 原文本報這次沒重讀(Helen Toner,2026-10-12)。
2. 還沒查證:[今日](報導 10 月 12 日)The Information 記者 Leo Schwartz 引匿名官員報導,川普政府計畫讓商務部 AI 標準與創新中心(CAISI,前身是美國 AI 安全研究所)的三名資深官員直接向白宮報告;報導全文在付費牆後,本報沒讀到(Leo Schwartz,2026-10-12)。
3. 還沒查證:[今日](轉引 10 月 12 日)據 The Information 報導、經評論者 Gary Marcus 轉引,品質最高的十個模型只占開發者 token 用量的 14%,一年前是 55%。token 是 AI 算字數與計費的單位。怎麼量、母體是誰,本報沒讀到(Gary Marcus,2026-10-12)。
4. 還沒查證:[今日](報導 10 月 12 日)據彭博報導、經中國科技政策分析師 Paul Triolo 轉述,DeepSeek 領投機器人新創 Winverse 數千萬美元的種子輪;彭博標題寫的 4 億美元是什麼口徑,本報沒讀到(Paul Triolo,2026-10-12)。
更正:10 月 11 日那期有五處寫錯或漏讀。主線 Fireworks:執行長貼文附的安全公告本報當時沒讀,公告寫明公司 10 月 6 日就發現事件,並說部分受影響帳號裡存成機密的 API 金鑰與存取權杖可能已被取走,要受影響客戶輪換通知裡點名的第三方憑證;公告 10 月 10 日也有更新,那期說「沒找到後續更新」不對。產品動態 Open SWE 的連結連到 Harrison Chase 的另一則推文;改前用的模型與品質怎麼量,LangChain 10 月 1 日的部落格已經公開,那期說「沒有公開」不對。晶片欄 Terafab 第一期投資超過 168 億美元,德州州長辦公室 8 月 6 日已公告,不是只有一則推文。Jordan 專訪的英譯頁寫明 10 月 4 日刊出。中文版主線把 Altman 那段話 10 月 9 日的轉貼日寫成了發言日。官網中英日三語存檔頁已改正。
本報不是新聞摘要:從每天的 AI 資訊流裡捕捉真正重要的洞見與值得長期追蹤的行家判斷,並交代每一條是怎麼驗證的。重點永遠是『哪條判斷變硬了、誰說得準』,不是今天發生了什麼。