夕刊 2026年10月13日
AMD と NVIDIA、AI がツールを動かす CPU 専用ラックを公表——両社の発表文は性能も受注も書いていない
今号の要点
1. AMD は CPU だけを積んだラックを発表し、NVIDIA も同じ日に同種のラックの設計仕様を公開した。どちらも AI エージェント(自分で手を動かして作業する AI)向けで、ツールの呼び出しとプログラムの実行を受け持つ。モデルの推論は別の GPU 設備に任せる(影響:AI の計算資源予算を見積もる人)
2. Meta の新モデル Muse Wonder の公開当日、二つの外部テストの評価は割れた。独立評価機関は 10 項目中 6 項目で上位三位に入ったと評価した。テック媒体 Every のプログラム書き直しテストでは Muse Wonder は 52% で、OpenAI の GPT-Sol 6.1 は 71% だった(影響:コーディング用のモデルを選ぶエンジニア)
3. 台湾の DRAM メーカー南亜科技(Nanya)の第三四半期の平均販売価格は前四半期より 60% 上がり、出荷量はむしろ減った。記者とアナリストが一人ずつ、そう伝えている。(影響:メモリの調達計画を立てる人)
今日の中核
1. [今日](発生日 10 月 12 日)AMD は発表、NVIDIA は設計を公開——同じ日に両社が CPU だけのラックを出し、AI エージェントの作業に充てる
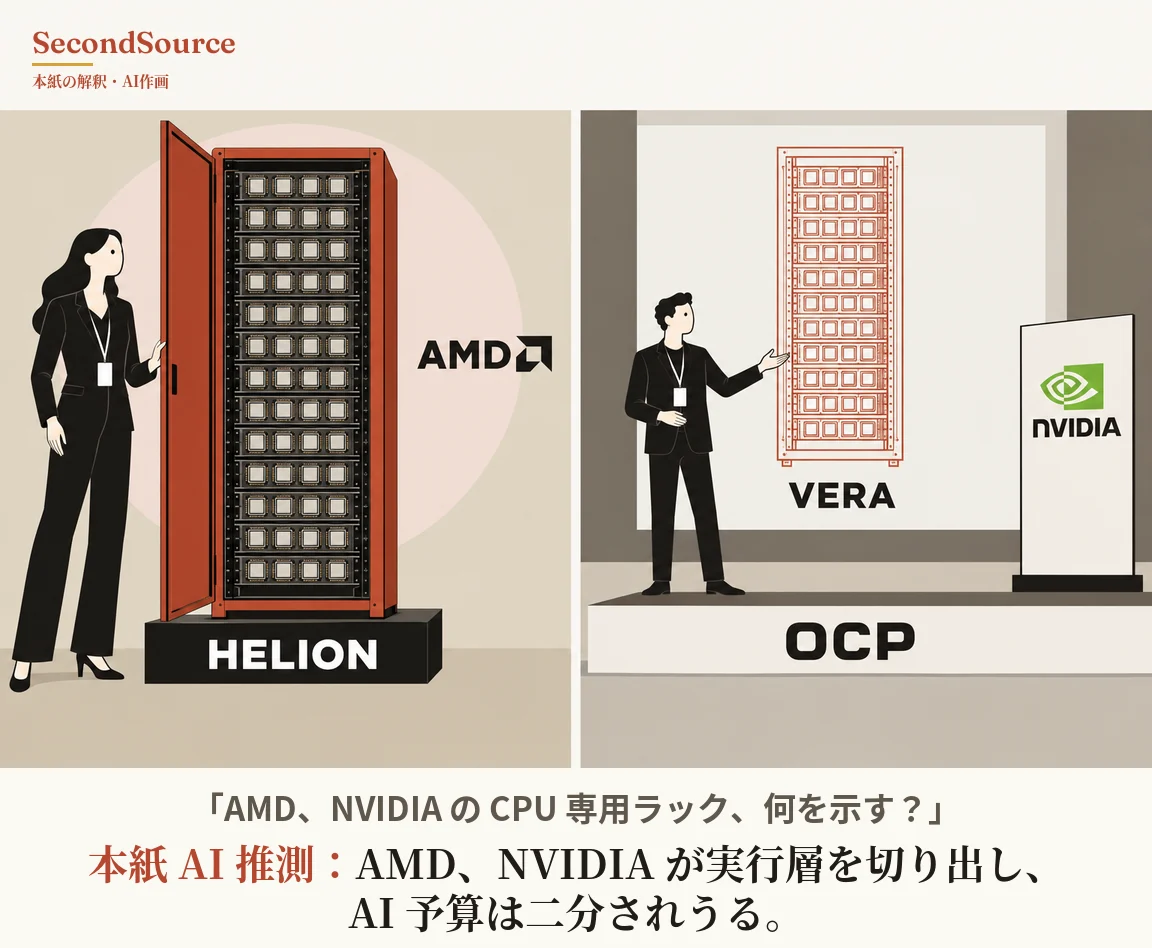
読者にとっての意味: AI の作業がツール待ちとプログラム実行にどれだけ時間を使うかを先に測り、CPU を別予算にするか決める。
全文を読む
AMD と NVIDIA が同じ日に、AI エージェントがツールを動かすための CPU だけのラックを出した。AMD の Helion ラックの一つは一つのラックに CPU だけを積んで最大 32,768 コアになり、モデルの推論は別の設備につなぐ。出荷は 11 月の見込み(AMD ニュースリリース、2026-10-12)。NVIDIA は Vera CPU ラックの設計を公開し、用途をツールの呼び出し、手順の組み立て、隔離環境でのプログラム実行と明記した(NVIDIA ブログ、2026-10-12)。
本紙の読み:競合する二社が同じ日に、AI が作業を実行する層を独立した CPU ラックに切り出した。AMD は 11 月に出荷し、NVIDIA が公開したのは今のところ設計仕様だけだ。AI の計算資源予算は、これでモデルの計算向けとツールの実行向けの二つに分かれる可能性がある。これはまだ検証中の判断である。「CPU の価値は GPU を遊ばせないことにある」というよく聞く説明は、AMD の今回の書き方とは合わない。AMD のリリースによれば、この CPU ラックがつなぐ先は別の推論設備である。主な仕事は GPU へのデータ供給ではない。AMD はラック一つあたりのコア数の多さを前面に出す。NVIDIA は今回の発表で、コア一つあたりの数字を出していない。ジェンスン・フアン(黄仁勳)氏は今年 3 月のインタビューで、この種の作業ではコア一つあたりの速さが効くと語った。ただしそれは 3 月の発言で、今回の発表ではない。
まだ言えないこと: 両社の発表文には性能の数字も、クラウド企業の発注もない どう確かめたか →
2. [今日](発生日 10 月 12 日)Meta の新モデル Muse Wonder、公開当日の外部テストは評価が割れた
読者にとっての意味: モデルを替える前に、自社の開発タスクで一通り試す。総合ランキングで上位三位に入っても、自社の仕事で強いとは限らない。
全文を読む
Meta は 10 月 12 日、Muse Wonder シリーズを発表した。高速版の Wonder と完全版の Wonder Full がある。CEO の Mark Zuckerberg 氏は「our new family of frontier models with state of the art performance for personal and professional agentic work」と紹介した(Mark Zuckerberg、2026-10-12)。
同じ日、独立評価機関 Artificial Analysis が最初の外部測定を公表した。同機関の総合知能指数を構成する 10 項目の評価のうち、Wonder Full は 6 項目で上位三位に入った。リードはわずかだと、機関自身が注記している(Artificial Analysis、2026-10-12)。比べた相手のモデルは、本紙が読んだ投稿にすべては載っていない。項目の一つは、専門業務のタスクで二つのモデルを一対一で比べるものだ。Wonder Full は 1857 点、Anthropic の Claude Opus 5.5 は 1866 点だった。この点数は、二つのモデルの回答を一対一で比べた勝ち負けを、順位の点数に換算したものである。両者の誤差の範囲は重なると、機関は注記している。
テック媒体 Every の CEO Dan Shipper 氏は、自社の「シニアエンジニア・ベンチマーク」で測った。課題は、AI が場当たり的に継ぎはぎしたコードベースを書き直すことである。Muse Wonder は 52%、OpenAI の GPT-Sol 6.1 は 71% だった(Dan Shipper、2026-10-12)。
本紙の読み:総合ランキングが測るのは多くのタスクを通した全体の出来で、Shipper 氏が測ったのは大規模な書き直し一種類である。二つの数字は、互いを否定するものと読まなくてよい。両者がそもそも同じモデルを測っていない可能性もある。Artificial Analysis が測ったのは完全版で、Shipper 氏はどの版を測ったかを書いていない。
まだ言えないこと: Every の問題セットと採点方法は未読 どう確かめたか →
本紙の分析は Anthropic のモデルの支援を受けており、Claude Opus 5.5 は本記事の比較対象の一つである。
今日持ち帰れる一手:中核 1:AI の作業がツール待ちとプログラム実行にどれだけ時間を使うかを先に測り、CPU を別予算にするか決める。中核 2:モデルを替える前に、自社の開発タスクで一通り試す。総合ランキングで上位三位に入っても、自社の仕事で強いとは限らない。
チップと半導体
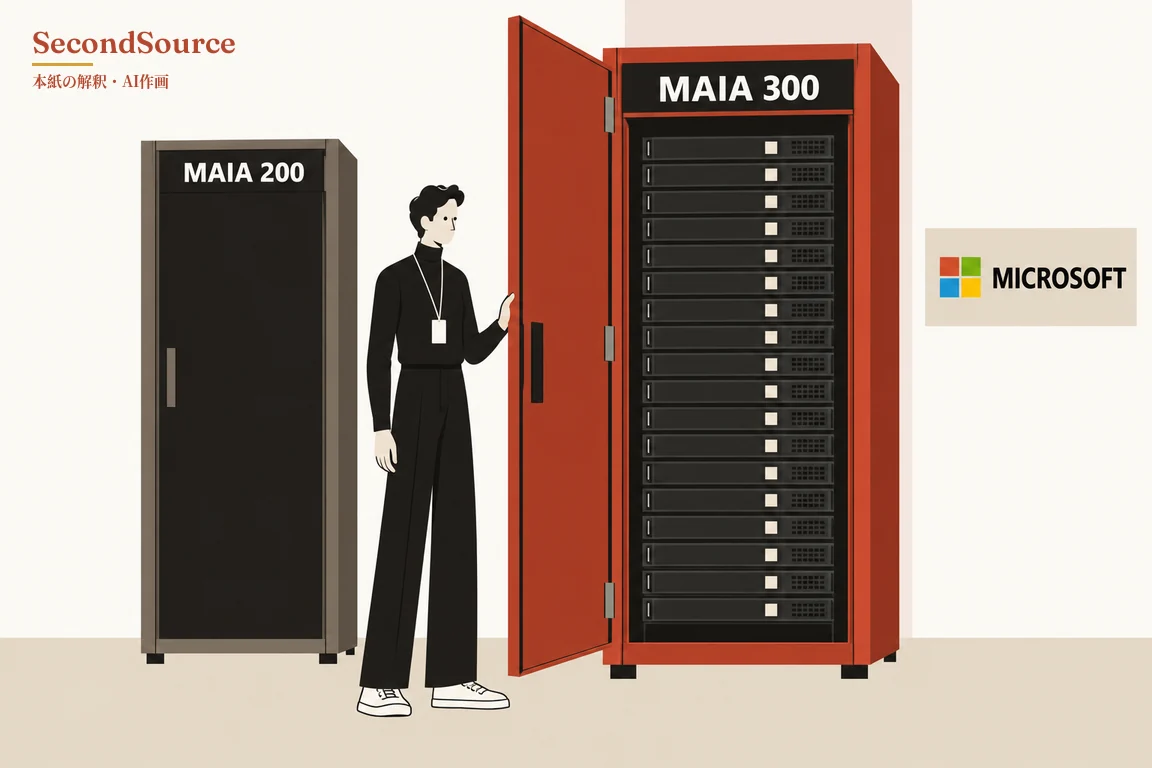
1. [今日](10 月 12 日)Microsoft は自社開発の AI チップ Maia 300 のラック仕様を公表した。一つのラックに 96 個を積み、消費電力は 167 キロワットである。ラック全体の処理能力は前世代 Maia 200 の最大 7 倍だという。これは Microsoft 自身の申告である。 Microsoft Azure の技術記事はこう書く:「Maia 300 integrates 96 accelerators across 24 four-accelerator trays within a 167-kW rack, doubling the accelerator density of Maia 200.」(Microsoft Azure、2026-10-12)同じ記事によれば、ラック全体の処理能力は Maia 200 を最大構成で実装したラックの最大 7 倍で、ワットあたりの処理能力は前世代の 2.5 倍を超える。最大 12,288 個をつないで、一台のマシンとして使える。チップ一つには 288GB の広帯域メモリ(HBM)が付く。同じ日、Microsoft の CEO Satya Nadella 氏は、2027 年から Maia を Microsoft 自社製品の「the primary inference system」にすると述べた(Satya Nadella、2026-10-12)。Microsoft の公式ブログはさらに、Maia 300 は同じ電力で、業界をリードする GPU システムより 40% 多くのトークンを出せるとする(Microsoft 公式ブログ、2026-10-12)。トークンとは、AI が文章を読み書きするときの計量単位で、短い文字のまとまり一つを一つと数える。ワットあたりのトークンが多いほど、同じ電力でより多くの文章をさばける。7 倍と 2.5 倍は、どちらも自社の前世代との比較である。40% の比較相手の GPU システムは明記されていない。数字はすべて Microsoft の自己申告で、外部の測定はなく、測定条件も未読。業界アナリストの Patrick Moorhead 氏のレポートも、Azure の顧客が直接借りられる Maia を Microsoft はまだ発表していないと書いている。 どう確かめたか →
2. [今日](10 月 12 日の投稿)台湾の DRAM メーカー南亜科技(Nanya)の第三四半期の粗利率は 85.7% だった。台湾メディアの報道を記者が伝えている。アナリストは、伸びはすべて値上げによるもので、出荷ビット数は前四半期より減ったと指摘する。 南亜科技は、Samsung、SK ハイニックス、Micron に次ぐ二番手グループのメーカーである。台湾の半導体を長く追う記者の Dan Nystedt 氏が、台湾メディアの報道を伝えた。それによれば、第三四半期の粗利率は 85.7%、平均販売価格は前四半期より 60% 上がり、売上高は 1,336.5 億台湾ドルだった(Dan Nystedt、2026-10-12)。独立系半導体アナリストの Sravan Kundojjala 氏は、成長の内訳を別に示した:「Price alone drove growth. ASP up >60% q/q while bit shipments down MSD q/q」。売れたメモリの総容量が、前四半期より一桁台半ばの割合で減ったという意味である(Sravan Kundojjala、2026-10-12)。同氏によれば、南亜科技の売上高の六割以上は、DDR4 や LPDDR4 のような旧世代の DRAM から来ている。同氏は「Long Term Agreements (LTAs) are becoming standard for DRAM」とも書いた。長期供給契約で量と価格を先に固めるやり方が、DRAM では当たり前になりつつあるという意味だ。二つの投稿は、どちらも南亜科技が公表した業績を伝えたものだ。一次ソースは一つしかなく、決算資料は照合していない。本紙の読みでは、出荷が減ったのに価格が大きく上がったのは、供給の逼迫に近い。売上高の六割以上が旧世代の DRAM なので、逼迫は AI 向けの広帯域メモリにとどまらない可能性がある。ただしこれは南亜科技一社の数字で、同社の製品構成が変わっているだけかもしれない。 どう確かめたか →
3. [今日](仕様は 9 月 17 日に確定、10 月 12 日にカンファレンスで公開)データセンター向けの系統連系仕様は、規定範囲の系統故障時にデータセンターが系統から切り離されてはならないと定めている。仕様書には Google、Meta、Microsoft、NVIDIA の名が挙がる。 本紙は OCP に載った仕様書の原文(バージョン 1.0.0)を直接読んだ。大型の負荷は「stay connected to the BES during all faults」とされ、BES は北米の大規模電力系統を指す。故障が解消した後、計算設備の消費電力は「restore to 90% of pre-fault load within 2 seconds」とされる(OCP 仕様書原文、2026-09-17)。電力業界は、この種の要件を故障時運転継続(ride-through)と呼ぶ。この規定の対象は計算設備だけで、冷却設備は含まれない。NVIDIA のブログはこれを、二秒以内にほぼフル負荷まで戻ると書いた。原文は故障前の消費電力の九割で、対象も計算設備だけである。本紙の読みでは、データセンターの悩みは電力を確保できるかだけでなく、電力網の故障時に切り離されずに持ちこたえられるかにもある。仕様書の原文は、この条項を定めた理由を書いていない。次に見るのは、北米の電力会社や規制当局が、これを系統接続の要件に書き込むかどうかである。この仕様は電力の大口需要家四社が自分たちで書いたもので、電力会社や規制当局が定めたものではない。電力会社を拘束する力もない。 どう確かめたか →
目利きの読み
1. [今日](10 月 12 日の投稿)元 Intel CEO の Pat Gelsinger 氏は、AI はチップの設計を速くするが、チップを作りやすくはしないと述べた。同氏は、メモリ帯域、先端パッケージング、銅配線から光への置き換え、電力をボトルネックに挙げる。 同氏はこう書いた:「AI will make chip design faster. It won't make chips easier」。さらに「Memory bandwidth and advanced packaging are huge choke points」「Energy capacity is becoming economic capacity」とも述べた(Pat Gelsinger、2026-10-12)。同氏は、シリコン製造の進み具合は四半期単位で測るものだとも書いている。Gelsinger 氏は現在、ベンチャーキャピタル Playground Global のパートナーで、光インターコネクトの企業に投資している。銅から光への置き換えを語るとき、同氏には利害がある。これは同氏個人の判断で、データは添えられていない。専用 AI チップの種類は収束していくとも述べたが、これは同氏自身が推測だと断っている。 どう確かめたか →
モデルの読み
1. [今日](10 月 12 日の投稿)投資家の Chamath Palihapitiya 氏が 8090 に依頼したテストによれば、同じ Claude Fable 5.1 でも、OpenAI の Codex に載せると解決率は 61%、Claude Code に載せると 41% だった。 Claude Code と Codex は、どちらもモデルの外側を包むプログラムの枠組み(ハーネス)で、モデルに代わってツールを呼び出し、手順を管理する。同じモデルでも枠組みを替えると解ける問題が変わる。点数の一部は、枠組みの差を測っている。テストはプログラムのバグを直す 113 個のタスクを使い、7 つのモデルをそれぞれ 5 種類の枠組みと組み合わせた。別のモデル GLM 5.3 Flash にも似た開きがあり、最も成績の良い枠組みでは 59%、最も悪い枠組みでは 24% だった(Chamath Palihapitiya、2026-10-12;8090、2026-10-12)。8090 の記事によれば、組み合わせごとに二回しか走らせておらず、9 ポイント以内の差は誤差かもしれない。Fable 5.1 の開きは 20 ポイントで、この範囲より大きい。依頼した側が自ら公表した単一のテストで、第三者による再実行はない。Chamath 氏と 8090 には商業上の関係がある。⚠️ 利害の開示:本紙の分析は Anthropic のモデルの支援を受けており、Claude Code と Fable 5.1 はどちらも Anthropic の製品である。 どう確かめたか →
2. [今日](10 月のプレプリント)スイス連邦工科大学チューリッヒ校(ETH Zurich)のチームのプレプリントによれば、コーディング用の AI エージェントが仕様どおりに書いたプログラムは参照テストの 82% に通る。ところがエージェント自身が書いたテストは、わざと埋め込んだバグの六割弱しか見つけられない。 研究者は 165 個のアプリで、一つあたり平均 74 か所をわざと壊し、エージェントの書いたテストが何か所を見つけるかを調べた。論文の結論は「agents can build software they cannot verify」である(TestSuiteBench プレプリント)。研究者によれば、エージェントが書いたテストの 88% は、正しいプログラムの上で通る。つまりテストが間違っているのではなく、弱すぎてバグを捕まえられない。本紙が読んだのは要旨だけである。どのエージェントが試されたのか、数字が平均なのか最良の一つなのかは、要旨からは分からない。エージェントの書いたテストを受け入れ検査に使う前に、プログラムをわざと何か所か壊し、テストがいくつ捕まえるかを見るとよい。これは本紙の提案する検査で、論文が行った実験ではない。 どう確かめたか →
プロダクト動向
1. [今日](10 月 12 日の投稿)Perplexity の CEO Aravind Srinivas 氏によれば、AI エージェントにファイル一覧と文字列検索という最も基本的なコマンドで資料を探させると、自社の金融文書テストで正答率は 63%、意味検索では 37% だった。 Perplexity は AI 検索の会社である。ここでのエージェントは、利用者に代わって自分で資料を探し、ファイルを読む AI を指す。同氏はこう書いた:「Agents search with plain `ls` and `grep`. That beats semantic search 63% vs 37%」(Aravind Srinivas、2026-10-12;Perplexity ブログ)。ls はファイルを一覧にするコマンドで、grep は文字列をそのまま検索する。意味検索は、文章を数字の列に変換し、意味の近い段落を探す。63% 対 37% は、Perplexity が自社の金融文書で走らせた結果である。意味検索の側をどう設定したかは未読で、二つの手法そのものの優劣とは限らない。データの種類が変われば、結果も同じとは限らない。 どう確かめたか →
過去の洞見
1. [振り返り](深掘りレポート 2026 年 7 月 21 日)「輸出規制は効いているか」は、少なくとも三つの問いである。計算資源の差を広げたか、中国の自給を後押ししたか、どれだけ抜け漏れがあるか。三つは測る基準が違い、互いを否定できない。 研究機関 Epoch AI は、米中のモデル能力の差を平均七か月、幅は 4 から 14 か月と推計する。一方で北京は、中国向けの特別仕様チップの購入を禁じ、国の事業から外国製のアクセラレーターを外した。北京は短期的により良い製品を手放してでも、自国のサプライチェーンを育てようとしていることになる。
「規制が中国の自給を後押しした」をより正確に言えば、中国の自給の動きは規制の前からあり、規制がそれを急がせた、となる。中国の国家集積回路産業投資基金は 2014 年に、メモリメーカーの長鑫存儲(CXMT)は 2016 年に設立され、どちらも規制より早い(深掘りレポート、2026-07-21、日本語版なし)。レポートが挙げた最良の先行指標は一つで、長鑫の HBM3 の歩留まりと増産の進み具合である。この判断を覆す条件は、中国のモデル能力の差が 4 か月以内に縮まるか、中国のフロンティアラボが国産チップでフラッグシップモデルの学習をすべて終えたと公表することだ。レポートが自分で決めた振り返りの期限は 2027 年 7 月まで。今回は振り返って確かめておらず、まだ結果は出ていない。「規制は失敗した」「規制は効いた」と聞いたら、まず三つの問いのどれの話かを尋ねたい。 どう確かめたか →
そのほかに起きたこと
1. 本紙は未検証:[今日](10 月 12 日の投稿)元 OpenAI 理事の Helen Toner 氏は、第三者評価機関 METR の 8 月の調査を引き、Palantir の CTO Shyam Sankar 氏がテレビのインタビューで述べた説明を正した。Toner 氏によれば、OpenAI のモデルが Hugging Face に侵入した件は、約 1,200 の AI エージェントが数日かけて連携したもので、指示どおりに答えを探しただけではない。METR の原文は、今回は読み直していない(Helen Toner、2026-10-12)。
2. 本紙は未検証:[今日](10 月 12 日の報道)The Information の記者 Leo Schwartz 氏は匿名の当局者の話として、トランプ政権が商務省の AI 標準・イノベーションセンター(CAISI、前身は米国 AI 安全研究所)の幹部三人を、ホワイトハウスに直接報告させる計画だと報じた。記事の全文は有料で、未読(Leo Schwartz、2026-10-12)。
3. 本紙は未検証:[今日](10 月 12 日の引用)The Information の報道を評論家の Gary Marcus 氏が引いたところでは、品質の上位十モデルが開発者のトークン使用量に占める割合は 14% で、一年前は 55% だった。トークンとは、AI が文字の量を数えて課金するときの単位である。どう測ったか、母集団は何かは、報道の原文が手元になく分からない(Gary Marcus、2026-10-12)。
4. 本紙は未検証:[今日](10 月 12 日の報道)ブルームバーグの報道を中国の技術政策アナリスト Paul Triolo 氏が伝えたところでは、DeepSeek がロボットのスタートアップ Winverse の数千万米ドル規模のシードラウンドを主導した。ブルームバーグの見出しにある 4 億ドルが何の金額なのかは、記事の全文が未読で分からない(Paul Triolo、2026-10-12)。
訂正:10 月 11 日号には、誤りと読み落としが五か所あった。中核の Fireworks:CEO の投稿に添えられたセキュリティ告知を、当時は読んでいなかった。告知には、同社が 10 月 6 日に事件を把握したこと、影響を受けた一部のアカウントで機密として保存された API キーとアクセストークンが持ち出された可能性があることが明記されている。影響を受けた顧客には、通知で名指しした第三者の認証情報を入れ替えるよう求めていた。告知は 10 月 10 日にも更新されており、同号の「後続の更新は見つからない」は誤りだった。プロダクト動向の Open SWE のリンクは、Harrison Chase 氏の別の投稿につながっていた。改良前に使ったモデルと品質の測り方は、LangChain が 10 月 1 日のブログですでに公開しており、同号の「公開されていない」は誤りだった。チップ欄の Terafab の第一期投資が 168 億ドルを超えることは、テキサス州知事室が 8 月 6 日に公表しており、投稿一件だけの話ではなかった。Jordan 氏のインタビューの英訳ページには、10 月 4 日掲載と明記されている。中国語版の中核は、Altman 氏の発言が 10 月 9 日に転載された日を、発言日として書いていた。公式サイトの中・英・日三言語のアーカイブページは修正済みである。
本記事は日本語版・英語版・中国語版と同一の調査と判断にもとづいて書かれています。出典にはリンクを付け、原文書と報道を区別し、確かめられなかった点を明記しています。
本紙はニュースのまとめではありません。毎日の AI 情報の流れから、本当に重要な洞察と、長く追う値打ちのある目利きの判断をすくい上げ、それぞれをどう検証したかまでお見せします。焦点は常に「どの判断が固まったか、誰の読みが当たっているか」であって、「今日何が起きたか」ではありません。