晨報 2026年10月22日
OpenAI:可控性變化不是特別由架構造成。本報判斷,監控更依賴不寫推理時的推理能力,卡上沒解釋這項能力為何大升
本期比平常晚了 2 小時送達,抱歉。
今日主線
1. [今日](深度專欄 10 月 22 日)OpenAI 在 GPT-6 Astra 系統卡說,可控性的變化不是特別由架構造成。監控更依賴不寫推理時還能推理多少,這個能力為何大升,系統卡沒說明
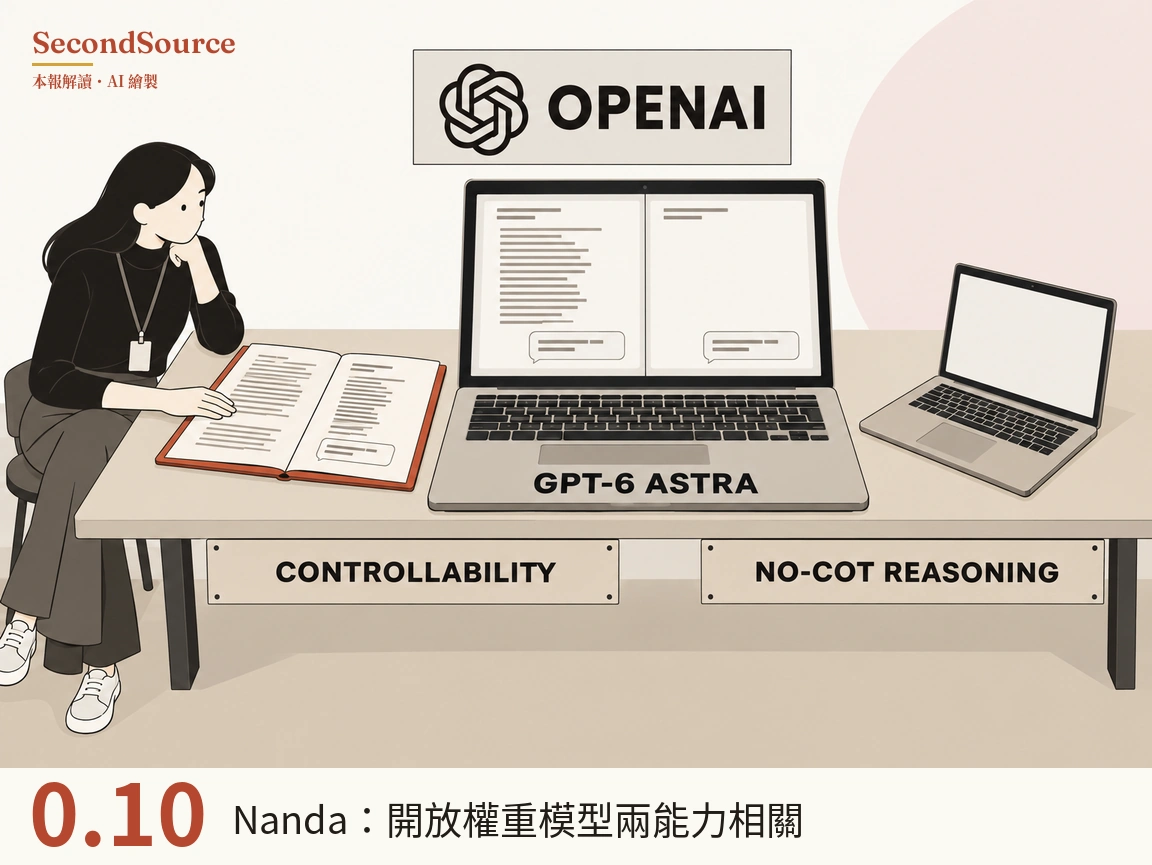
為什麼重要: OpenAI 說明架構沒問題的那句話量的是可控性,不是監控真正依賴的不寫推理也能推理的能力,這是本報的讀法。
展開看全文
OpenAI 為旗艦模型 GPT-6 Astra 發布的系統卡裡,有一句話說可控性的變化不是特別由架構造成。本報今天的深度專欄問:這句話量的是哪一項指標?思維鏈是模型答題前寫出來的推理文字。業界抓模型做壞事的常見做法之一,是派另一個模型去讀這段文字。系統卡第 9.2.1 節寫:「We are also quite confident that changes in CoT controllability are not differentially due to any architectural changes.」(OpenAI Astra 系統卡,2026-09-03)。原文用的是 differentially。意思是架構沒有比其他因素更特別地造成這個變化,原文沒有說架構毫無影響。這一段的主詞都是可控性。可控性是模型照指令改寫推理文字的能力。監控看的是另一件事:不准寫推理文字時,模型靠內部運算還能答對多少。這個能力越強,模型越不必把推理寫出來。可控性和這個能力可以各自升降。Google DeepMind 研究員 Neel Nanda 量到,Astra 不寫思維鏈時的答對勝算約是 Claude Fable 5.1 的 8.6 倍。這是兩款模型之間的勝算比,不是跨世代的升幅。系統卡全文沒有一句說明這個能力為什麼大升。本報 9 月 10 日那期寫過 Nanda 以個人身分量到的讀數:34 個開放權重模型上,可控性與無思維鏈推理的相關係數 0.10(Alignment Forum,2026-09-10)。這次新加進來的是三件證據,都出自 9 月的文件。
第一,同代的 GPT-6 Sol 可控性遠低於 Astra。系統卡 9 月 22 日的附錄加入了 GPT-6 Sol。在 750 到 1,250 個 token 的思維鏈長度視窗裡,GPT-6 Sol 遵從改寫指令 23.2%,前代 GPT-5.6 Sol 16.1%,Astra 60.9%,三個數字由 OpenAI 自量。Astra 的思維鏈變短了,落進同一長度視窗的題目,三個模型之間可能不同。以前代 GPT-5.6 Sol 的 16.1% 為基準,GPT-6 Sol 升了約 7 個百分點,Astra 升了約 45 個百分點。這是本報用卡內同一長度視窗的數字相減。
第二,OpenAI 兩份文件各自寫到 Astra 的思維鏈變短。可監控性是讀思維鏈時,看不看得出模型在做什麼。系統卡寫可監控性的落差「大部分」來自 Astra 的思維鏈變短,沒給比例。9 月 9 日 OpenAI 的企業版發布稿把同一件事寫成「被訓練成用更少 token、更少重試完成任務」(OpenAI,2026-09-09)。兩份文件沒有互相引用,放在一起讀是本報的做法。
第三,可控性、可監控性、無思維鏈推理這三項,量測的人各不相同。可控性的量法,外部能在開放權重模型上照做。重跑的是開放權重模型,不是 Astra 本身。可監控性的量測方是 OpenAI,用的是自家度量,英國 AI 安全研究所的部落格把結果指回系統卡。無思維鏈推理,公開程式碼與資料的只有 Nanda 一人。
為什麼現在挖:本報追蹤的這條線問的是,模型的推理還看不看得懂、由誰來驗證。本報 9 月 5 日那期判斷,OpenAI 拿來替新旗艦掛保證的那道監控防線,和 OpenAI 自家文件用來證明安全的,不是同一道(9 月 5 日那期)。今天要查的是:系統卡用來說明架構沒問題的可控性,是不是監控實際依賴的那個能力。
進行中 ?
還不能當真: OpenAI 研究員說的「兩者一起上升」沒有公開數字 怎麼查的 →
判斷更新: 本報的讀法:OpenAI 系統卡上說架構不是原因的那句只涵蓋可控性,監控真正依賴的量為什麼大升,卡上沒有表態。兩個讀數與「可控性主要由後訓練決定」相容。後訓練是模型基本訓練完成之後,再調整行為的階段。靠讀思維鏈做監控的產品,保證力取決於模型不寫推理時還能推理多少,不是可控性。第一個讀數是 Nanda 在 34 個開放權重模型上量到,可控性與無思維鏈推理的相關係數只有 0.10。第二個讀數是同代的 GPT-6 Sol 與 Astra,可控性 23.2% 對 60.9%,差距很大。兩個讀數各自都不能單獨證明這個讀法。規模或預訓練的差異,同樣能解釋 Sol 與 Astra 的差距。這類說法可以用三個問題檢驗:掛在哪個量上,用的是同一家內部的縱向比較還是跨公司的橫斷面,外部能不能重跑。什麼會推翻它:下一款 OpenAI 前沿模型的系統卡在發布後十四天內,對無思維鏈能力的變化給出成因或架構歸因句;或到 2027 年 3 月 31 日,任一第三方在至少三款閉源前沿模型上量到兩個量的相關係數 0.5 以上。十四天、0.5 與 2027 年 3 月 31 日都是本報自設的門檻。只有三款模型算出的相關係數很不穩,第二條只能看方向。長版全文
2. [今日](公告 10 月 21 日)OpenAI 模型進 Google Cloud 市集,可抵扣承諾額,目前是私人預覽。同日公告 11 月 20 日起模型路由器要先經 OpenAI 審批
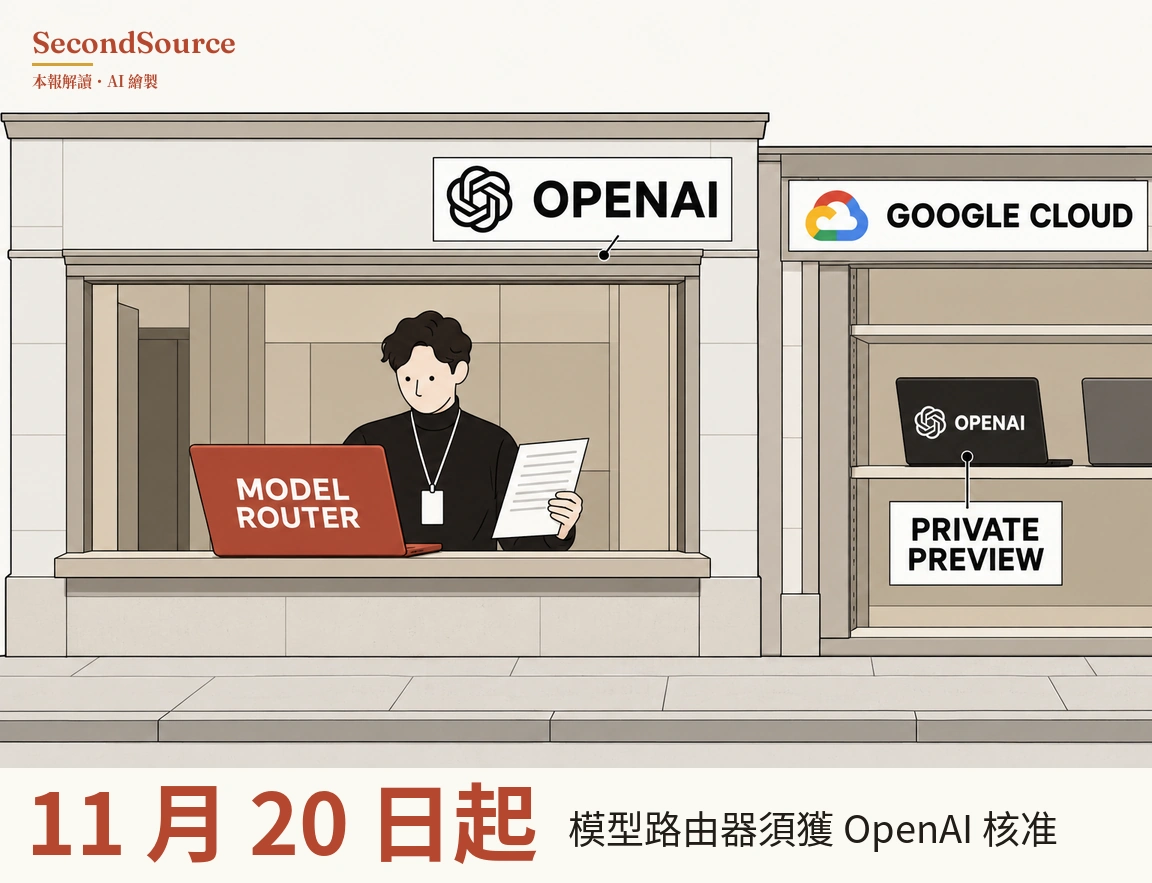
為什麼重要: OpenAI 先把 Frontier 平台帶上 AWS,現在模型又進了 Google Cloud 預覽,同一天把模型路由器與 AI 閘道收進自家審批,競爭點可能從在哪朵雲買移到誰獲 OpenAI 核准做路由,這是本報把兩篇公告並讀的讀法。
展開看全文
OpenAI 模型進 Google Cloud 市集,承諾額可抵扣(OpenAI,2026-10-21),併入單一發票(Google Cloud,2026-10-21),目前是私人預覽。同日政策文:11 月 20 日起模型路由器要先經 OpenAI 審批(OpenAI,2026-10-21)。4 月 27 日修約後 Microsoft 授權已非獨家(OpenAI,2026-04-27)。
還不能當真: 三篇全是當事方自述,正式上線日與價目未公開 怎麼查的 →
判斷更新: 本報的讀法:OpenAI 一邊放開通路,一邊把路由資格收回自家審批。OpenAI 的雲通路從 Azure 一家,到 2 月 27 日的 AWS、10 月 21 日的 Google Cloud,變成三家。AWS 上的是 Frontier 平台,和 Google Cloud 市集賣的模型是不是同一種產品,未經核對,所以「三家」這個算法還不確定。AWS 那一步是 OpenAI 與 Amazon 宣布把 OpenAI 的 Frontier 平台帶上 AWS,早於 4 月 27 日的修約(OpenAI,2026-02-27)。「在哪朵雲上買」不再是 OpenAI 的差異點,競爭點可能移到誰獲 OpenAI 核准做路由與閘道。受審批影響最直接的是獨立的模型路由器與 AI 閘道業者。靠這類中介在多家模型之間切換的企業,11 月 20 日起也要看自己用的業者有沒有獲准。Microsoft 留著先上 Azure 與到 2030 年的分成,Google Cloud 拿到的是帳單整合。有 Google Cloud 承諾額的企業,可以用同一筆承諾額買 GPT、Gemini 與 Claude,成本列在同一張發票上對照。目前只限私人預覽的客戶。科技策略分析師 Ben Thompson 2025 年 6 月在 Stratechery 建議 Microsoft 保住獨家在 Azure 銷售 OpenAI 模型的權利(Stratechery,2025 年 6 月)。這是本報對該文方向的轉述,沒有逐字引用。4 月的修約結果與這個建議相反,Microsoft 的獨家銷售權已經取消。本報把這個差異留作未解的分歧。這是還沒定案的判斷。什麼會推翻它:到 2026 年 12 月 31 日 Google Cloud 上的 OpenAI 模型仍未正式上線;或到 2027 年 1 月 31 日,沒有任何一家獨立路由器或 AI 閘道業者因 11 月 20 日政策送審或停止提供 OpenAI 模型。兩個日期都是本報自設的觀察窗,OpenAI 只說正式上線「預計數週內」。
晶片與半導體
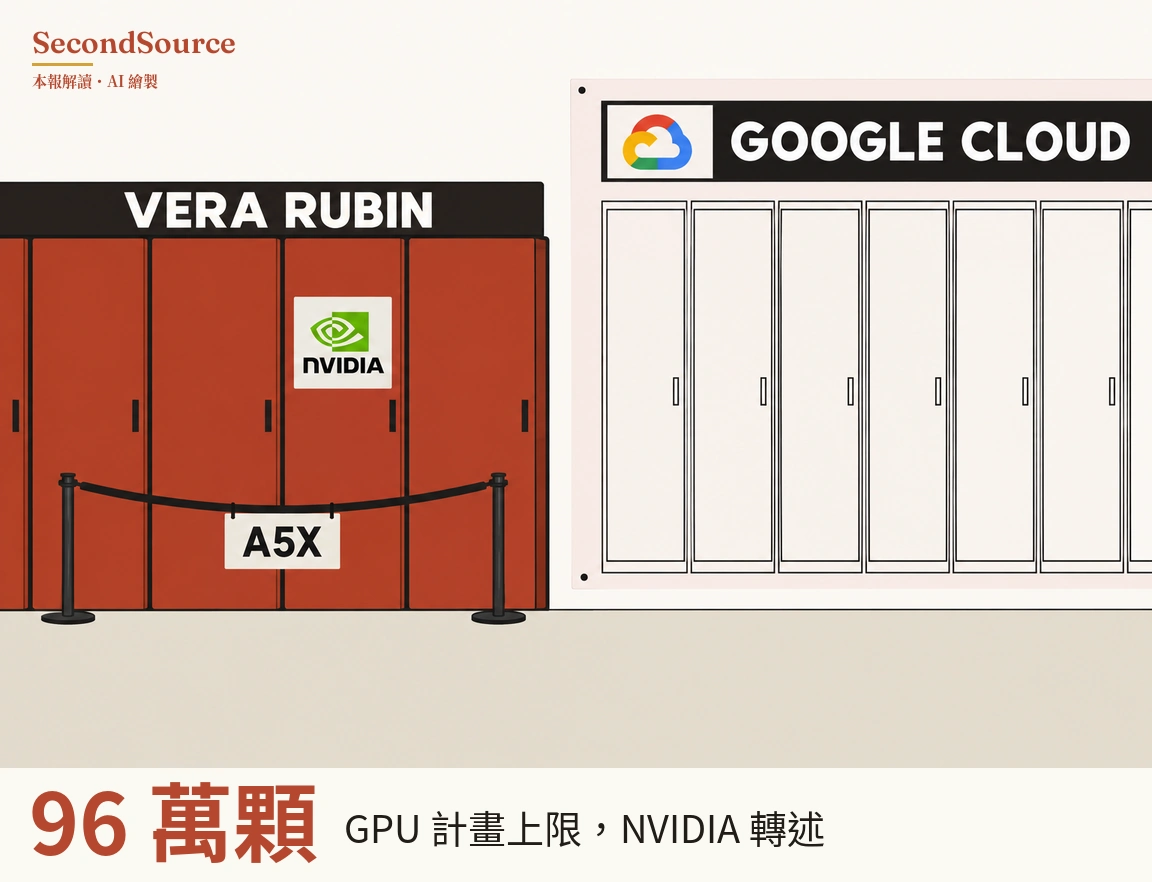
1. [今日](公告 10 月 21 日)NVIDIA 寫 Google Cloud 的 Vera Rubin 機種 A5X 下月正式上線,Google 計畫最多擴到 96 萬顆 Rubin GPU,這是計畫上限不是部署數。 A5X 是 Google Cloud 以 NVIDIA Vera Rubin NVL72 機櫃組成的機種。NVIDIA 原文:「Google Cloud plans to scale its Vera Rubin-based infrastructure to as many as 960,000 Rubin GPUs across multiple sites.」(NVIDIA,2026-10-21)。96 萬顆沒給時程與已部署數,是否全歸 A5X 也沒說明。AlphaGo 作者 David Silver 創辦的 Ineffable Intelligence 是 A5X 首位客戶,做大規模強化學習。Ineffable 共同創辦人 10 月 13 日自述是「GCP 最大叢集的首批客戶」,NVIDIA 坐實了首位客戶與 11 月時程,「最大」一詞 NVIDIA 沒用,叢集規模兩方都沒寫。同篇另寫 Google Cloud 將是首批在裸機提供 NVIDIA 機櫃級機密運算的雲。裸機機密運算這一項也是 NVIDIA 轉述的 Google 計畫,Google 官方部落格原文未經查閱。本報 10 月 21 日那期寫過 Google 前一天把 TPU 軟體開放給 PyTorch,自研晶片與外購 NVIDIA 同時進行。A5X 是否如 NVIDIA 所說在 11 月正式上線,是下一個可核對的點。 怎麼查的 →
大神觀點
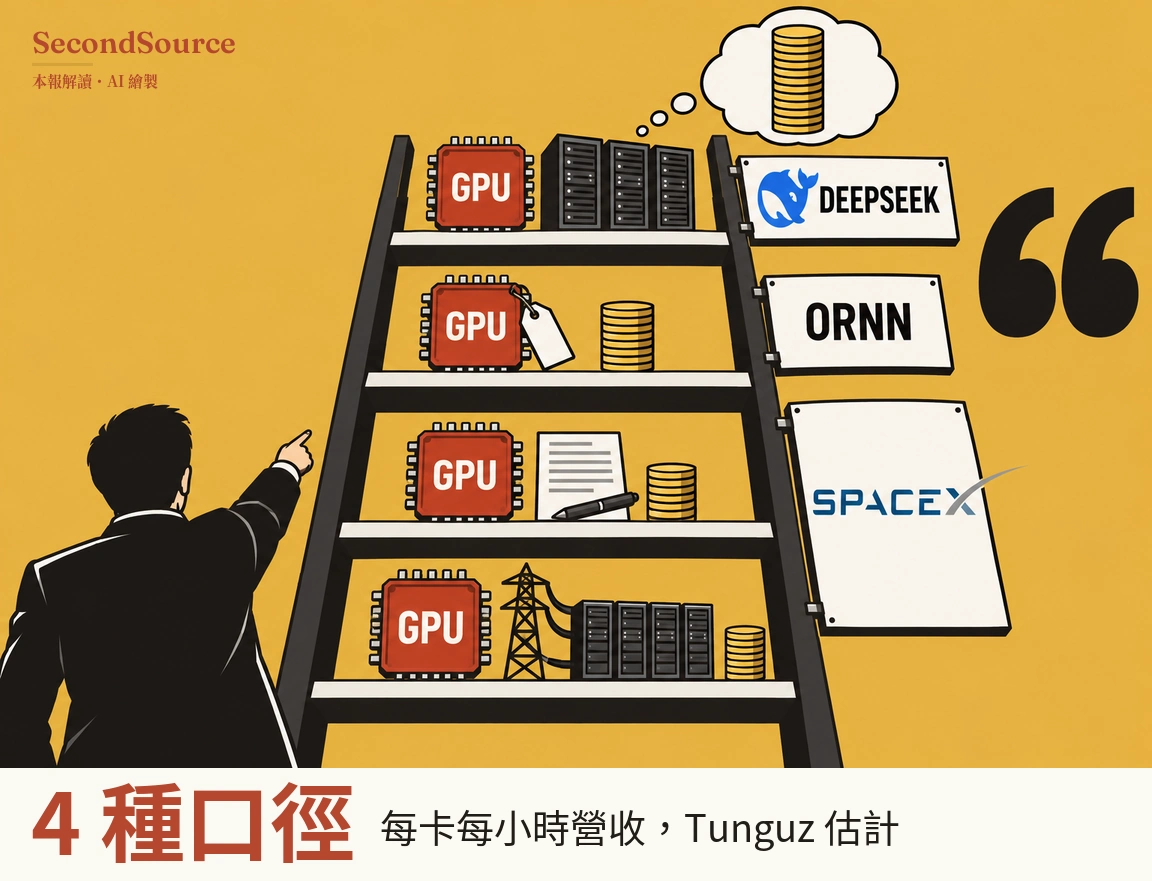
1. [今日](文章 10 月 21 日)創投 Theory Ventures 合夥人 Tomasz Tunguz 把每張 GPU 每小時的營收排成四階:38、8.77、5.27、2.44 美元,四個數字是四種口徑,Tunguz 自註全是估計。 Tunguz 長期寫 SaaS 與 AI 的財務分析。四階依序如下(Tomasz Tunguz,2026-10-21)。38 美元是 DeepSeek 自算的單一叢集上限,Tunguz 標「theoretical maximum」。8.77 美元是 ORNN 指數 10 月 20 日的 B200 現貨租價,ORNN 是 Tunguz 引用的 GPU 雲成交價指數。5.27 美元是 SpaceX 上市文件裡 12.5 億美元對 32.5 萬顆 GPU 的合約價,Tunguz 把這筆錢當成 32.5 萬顆 GPU 一個月 730.5 小時的費用,換算成每卡每小時。2.44 美元是 Tunguz 用 SpaceX 第三季申報的 AI 分部營收年化後除以 1.7 GW 已裝機容量算出,用的是裝機不是在用容量。從 GW 換成 GPU 張數要假設每張卡的功耗,Tunguz 原文沒寫這個數。每往下一階,數字比上一階低 40% 到 77%。四階口徑不同,這不是同一個價格逐階下跌。本報的讀法:推論在現價能不能回本,看站在哪一階,引用任何單一數字前都得先確認是哪種口徑。Tunguz 寫「Every figure here is an estimate」。本報 10 月 21 日那期把 38 美元寫成「離峰實收」,Tunguz 的表把 38 美元標為理論上限,兩種口徑哪個對,DeepSeek 原頁未經查閱;SpaceX 申報原文也未經查閱。Tunguz 是創投,持股原文未揭露。 怎麼查的 →
模型觀點
1. [今日](研究文章 10 月 21 日)Anthropic 寫 Claude 主導設計能結合蠍毒的蛋白,兩家實驗室測了 211 個設計、17 個達到結合標準,還沒確認能否在細胞環境中中和蠍毒,Anthropic 明說不是抗毒血清。 Anthropic 原文:「We have not confirmed whether these binders neutralize scorpion venom in a cellular environment, so we do not claim to have produced an antivenom.」(Anthropic,2026-10-21)。211 個設計裡,180 個由 Claude 篩出,31 個是人類團隊補上的,數字都是 Anthropic 自報。達標 17 個,占 211 個的 8.1%,這是本報的計算。達標的 17 個分布在四種蠍毒素上。單一毒素設計 60 個中 11 個達標,另外 6 個達標設計屬於哪一類,原文分項沒有交代。151 個多毒素設計中,沒有一個能同時結合超過一種毒素。實測交給 Anthropic 委託、替人代做實驗的兩家公司 Adaptyv Bio 與 Twist Bioscience。達標門檻是兩家實驗室每次重複都要結合、解離常數 KD 不高於 1 µM;KD 越低代表結合越緊,表現最好的兩個設計到個位數 nM,原文對照的三個抗體都低於 1 nM。Claude 自主跑了前 24 小時,之後 Anthropic 團隊追加四次提示,多數入選設計是第三次追加提示之後才選出,所以 AI 的功勞與人的功勞不好切分,這是本報的讀法。技術報告未經查閱。 怎麼查的 →
快訊
1. 還沒查證:[今日](公告 10 月 21 日)SAP 第三季業績:雲 ERP Suite 營收成長 29%、固定匯率 28%,財務長 Dominik Asam 說季營收首次突破 100 億歐元;2026 年展望寫「更新」但未說升降,比較期與會計口徑新聞稿未寫,季報 PDF 未經查閱(SAP News,2026-10-21)。
2. 還沒查證:[今日](公告 10 月 21 日)GTC Berlin 上 NVIDIA 說模組化 AI 工廠 DSX POD 讓現場部署「from six months to just 14 days once site utilities are ready」,並承諾在歐洲投入近 100 億美元,用途未拆分,皆 NVIDIA 自述(NVIDIA,2026-10-21)。
3. 還沒查證:[今日](公告 10 月 21 日)NVIDIA 轉述英國 GPU 雲業者 Nscale 在 GB300 NVL72 上用 NVIDIA 協調電力分配與負載需求的軟體 DSX MaxLPS,同一配置電力預算內多裝 37% GPU、總推論吞吐高近 50%,對照組與負載未說明(NVIDIA,2026-10-21)。
4. 還沒查證:[今日](公告 10 月 21 日)Mistral 寫 Mistral Large 4 以 3,800 顆 Grace Blackwell GPU 在自營歐洲資料中心訓練,算力路線目標 2030 年 1 GW 容量,是自訂目標不是已部署(Mistral,2026-10-21)。
5. 還沒查證:[今日](客戶故事 10 月 21 日)OpenAI 發布的 Cloudflare 客戶故事:Cloudflare 營收總裁 Mark Anderson 說四名開發者三天用 Codex 重建一個產品、token 花費 1,100 美元,原估需數月;單一自述,Cloudflare 自家部落格未經查閱(OpenAI,2026-10-21)。
6. 還沒查證:[今日](公告 10 月 21 日)PHP 引擎兩個 9.2 分漏洞 php2shell 修補 10 月 21 日釋出。Wiz 找到兩個,OpenAI 說合作方 Calif 也找到其中一個。本報判斷:php2shell 兩個漏洞 Wiz 都找到,OpenAI 說 Calif 獨立找到其中一個,「混用兩家模型」是 Wiz 一方的工具,轉述把兩方併成一句(Wiz Research,2026-10-21)。
7. 還沒查證:[今日](公告 10 月 21 日)ChatGPT 廣告新增 26 國、累計 89 國。OpenAI 工程篇寫廣告系統與答案生成分離。廣告模型讀對話脈絡,使用者選擇個人化廣告時也參考過去的對話。本報判斷:ChatGPT 廣告的隔離是單向的,答案路徑不碰廣告,廣告系統記住多少對話、記多久,OpenAI 原文沒有規格(OpenAI,2026-10-21)。
學界動向
1. [趨勢](預印本 10 月 17 日)Snowflake AI Research 的 Arctic-SWE 不加新演算法,把 40 億參數的 Qwen3.5-4B 訓到程式評測 SWE-bench Verified 解題率 62.0%,比作者自量的對照組 FrogNano 高 0.5 個百分點,論文自報。 SWE-bench Verified 是修真實 GitHub 問題的程式能力評測。作者寫「On raw R2E-Gym data, without new algorithms or data work, Arctic-SWE trains Qwen3.5-4B to 62.0% pass@1 on SWE-bench Verified」(arXiv 2610.24914,2026-10-17)。pass@1 是每題只試一次的解題率。R2E-Gym 是既有的公開訓練環境。對照組是同樣用線上任務合成的 FrogNano,分數 61.5%。兩者分數只差 0.5 個百分點,Arctic-SWE 用的訓練取樣次數約只有 FrogNano 的六分之一。篩選資料後 4B 模型的 Verified 分數到 65.0%。單篇自報,預印本 10 月 17 日才發表,獨立重做的結果不在本期資料範圍內。分數隨資料篩選與測試強度而變。本報的讀法:小模型在這項評測要再往上拿分,關鍵可能在強化學習系統與資料品質,不在演算法;現役最強模型在同一評測的分數,本則沒有比較。
2. [趨勢](預印本 10 月 19 日)兩篇預印本對「Lean 定理證明的增益來自外框還是基礎模型」結論方向不同:Maestro 說同一基礎模型換協調外框,48 題解出 34 題、原生代理解 19 題,mini-Lean 說通用程式代理加最小外框就夠。 Lean 是數學證明的形式化語言。外框是包在模型外面、負責調度的程式。Maestro 是一套協調多個代理的外框,arXivLean 是一套 Lean 題庫。Maestro 自量 arXivLean 2026 年 6 月版 48 題中解 34 題,原生代理 Claude Code 或 Codex 解 19 題,作者單位原文未提供(arXiv 2610.25920,2026-10-19)。Maestro 寫兩邊用的是同一個基礎模型。10 月 12 日普林斯頓 Sanjeev Arora 等的 mini-Lean 寫「a generic coding agent with a minimal harness can already achieve strong performance on Lean benchmarks」,自量 Putnam 2025 共 12 題,Gemini 3.8 Flash 解 7 題、對手 AxProverBase 解 4 題(arXiv 2610.17331,2026-10-12)。兩篇的外框形態與題庫不同,不是同題反駁。兩篇的題庫都很小,12 題與 48 題差幾題就會改變結論。本報的讀法:現有證據還不足以判斷外框值不值得投入開發資源。外框形態相同、題庫更大的重測,才分得出增益來自外框還是基礎模型。
產品動態
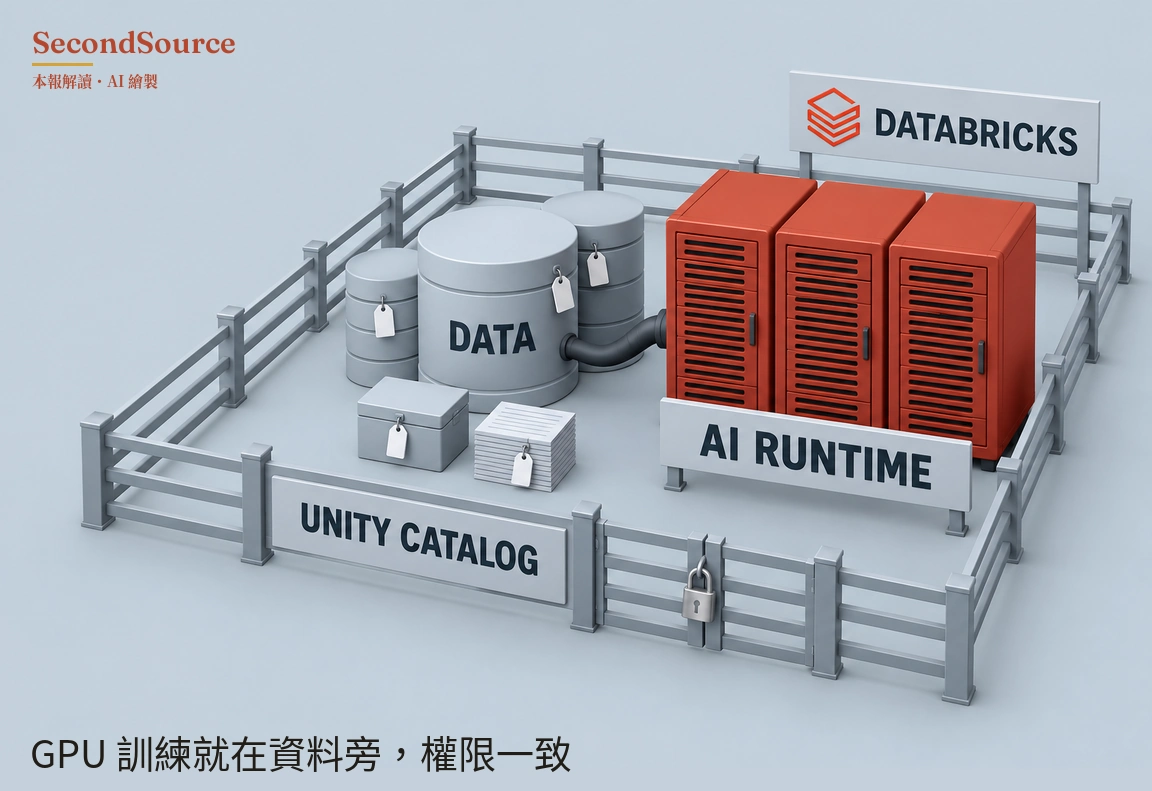
1. [今日](公告 10 月 21 日)Databricks 宣布 AI Runtime 正式上線:託管 GPU 訓練直接接到自家資料平台,賣點是訓練資料不用離開治理邊界;定價與 GPU 型號原文未提供。 Databricks 是資料與 AI 平台公司。原文:「bringing fully managed GPU infrastructure directly into Databricks so customers can train their most demanding models where their enterprise data already lives」(Databricks,2026-10-21)。AI Runtime 做訓練與微調,不是推論服務:無伺服器、可跨多台機器,GPU 工作也受資料治理層 Unity Catalog 管理,資料、檢查點與日誌的讀寫權限一致。Databricks 自報「hundreds of companies」在用,具名 Robinhood、Merck、FactSet 等六家;在 AI Runtime 上把 Qwen 訓練時間縮成改善前的六分之一,對照的是改善前的自家設定。這次正式上線有多少是既有預覽版改名,原文沒交代。最直接的使用者,是資料已經放在 Databricks 上、要自行訓練或微調模型的企業,這是本報的讀法。資料平台往託管 GPU 訓練延伸,會不會和 GPU 雲業者正面競爭,要看定價與 GPU 型號,兩者原文都沒提供。 怎麼查的 →
過去洞見
本期版位讓給今日主線,這一欄改到官網讀。〈[回顧](本報深度報告 7 月 23 日)「AI 能連續工作幾小時」這把尺,同一季被受測模型攪動〉(本報 2026-07-23 深度報告)。
更正:8 月 13 日那期說 Nebius 第二季調整後 EBITDA「首度轉正」、上一季還是負 5,370 萬美元,其實負 5,370 萬是 2025 年第一季的數字,Nebius 從 2025 年第四季起已連續三季為正(1,500 萬、1.295 億、2.362 億美元);「首度轉正」這一半撤回,另一半結論沒變:這一季資本支出約是營收的 9.7 倍,全年營收指引沒有上調;官網中英日三語存檔頁已加註更正。
本報不是新聞摘要:從每天的 AI 資訊流裡捕捉真正重要的洞見與值得長期追蹤的行家判斷,並交代每一條是怎麼驗證的。重點永遠是『哪條判斷變硬了、誰說得準』,不是今天發生了什麼。