NVIDIA 示範把 7,530 億參數的開放權重模型 GLM-5.3 拆到兩台桌邊型 DGX Station 上跑,量化後約 464 GB,單顆 GB300 的高頻寬記憶體只有 252 GB。
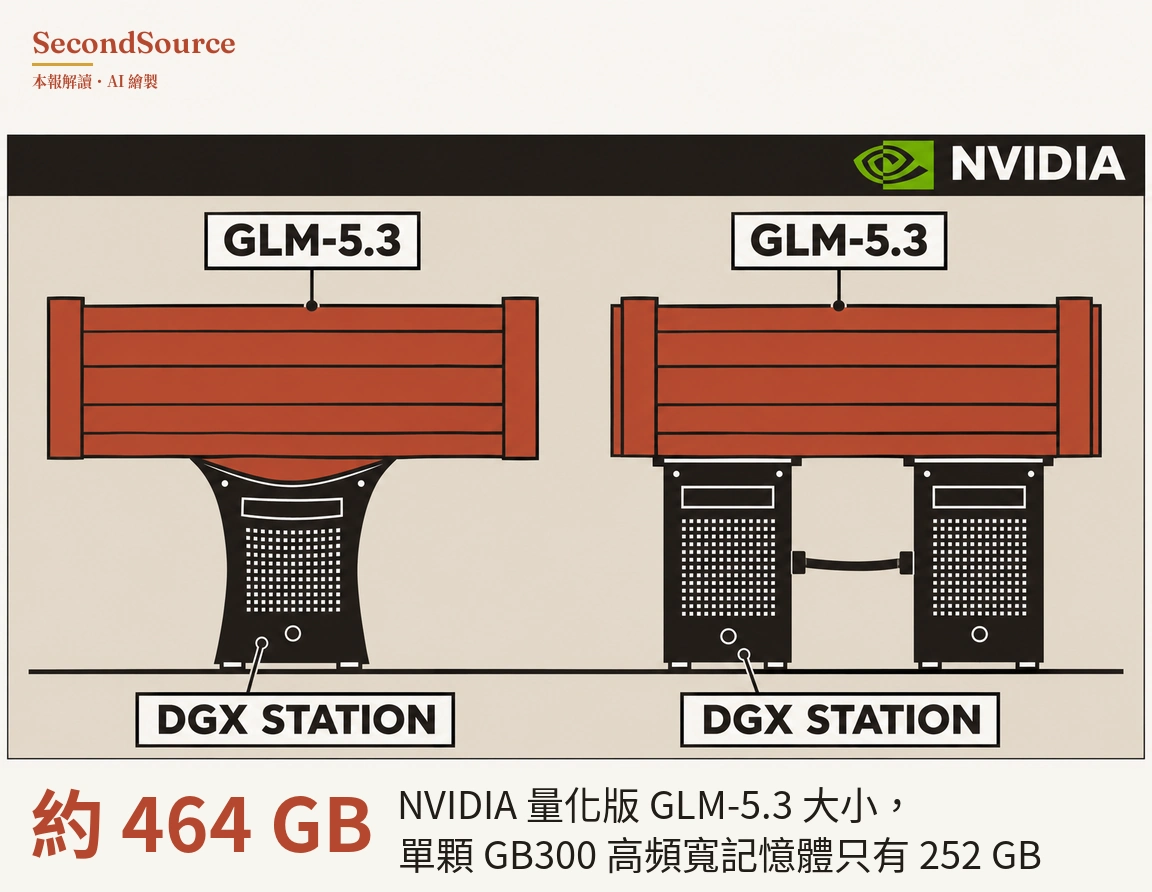
前沿級的開放權重模型不上雲也跑得動,但效能是 NVIDIA 自測、沒有和雲端或單機比。GLM-5.3 是中國模型公司 Z.ai 的混合專家模型,每個 token 啟用 400 億參數;NVIDIA 用的是自家 NVFP4 量化版。兩台各裝一顆 GB300,以開源推論伺服器 vLLM 把每層權重切開分到兩台,經 ConnectX-8 網路卡直連,由一個相容 OpenAI 格式的端點對外服務。NVIDIA 自測寫程式對話,同時 16 個連線時總吞吐量最高,每秒 607.8 個 token;32 個連線反而降到每秒 385.0 個(NVIDIA Technical Blog,2026-11-13)。 怎麼查的 →
出處與查證
這則刊在2026年11月14日的晨報,同一期還有 14 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈NVIDIA 示範把 7,530 億參數的開放權重模型 GLM-5.3 拆到兩台桌邊型 DGX Station 上跑,量化後約 464 GB,單顆 GB300 的高頻寬記憶體只有 252 GB。〉,https://secondsource.io/news/2026-11-14-6/,取用日期取用。