NVIDIA は、7,530 億パラメーターのオープンウェイトモデル GLM-5.3 を卓上型の DGX Station 二台に分けて動かす例を示した。量子化後の重みは約 464 GB で、GB300 一個の広帯域メモリは 252 GB しかない。
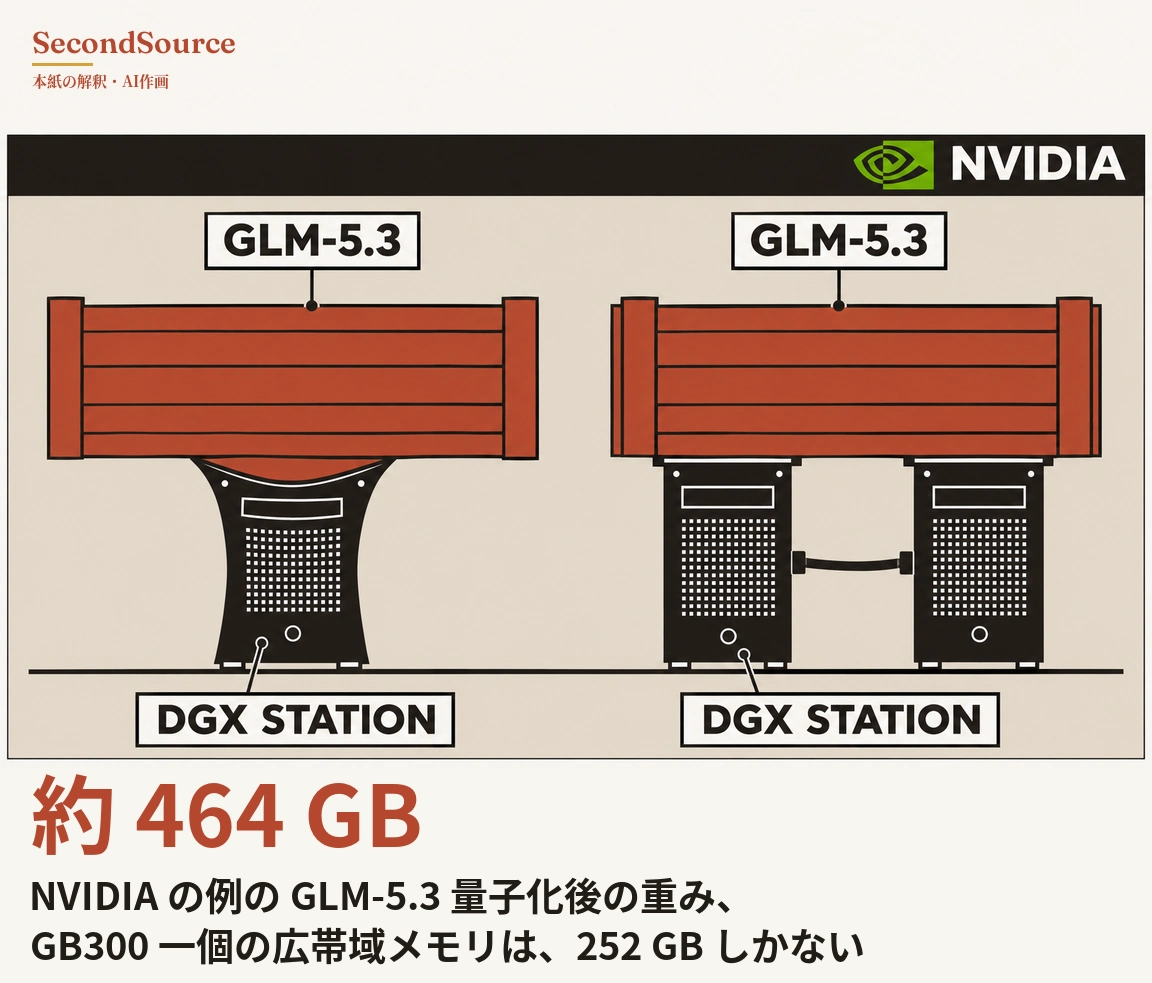
フロンティア級のオープンウェイトモデルはクラウドなしでも動くが、性能は NVIDIA の自社測定で、クラウドや一台構成とは比べていない。GLM-5.3 は中国のモデル企業 Z.ai の混合専門家モデルで、トークンごとに 400 億パラメーターが働く。NVIDIA が使ったのは自社の NVFP4 で量子化した版である。二台はそれぞれ GB300 を一個積み、ConnectX-8 のネットワークカードで直結する。オープンソースの推論サーバー vLLM が各層の重みを二台に分けて載せる。外部には OpenAI 互換の一つのエンドポイントで提供する。NVIDIA が自社で測ったプログラミングの対話では、同時接続 16 で合計スループットが最も高く毎秒 607.8 トークン、同時接続 32 ではかえって毎秒 385.0 トークンに落ちた(NVIDIA Technical Blog、2026-11-13)。 どう確かめたか →
出典と検証
この記事は2026年11月14日の夕刊に掲載されました(同じ号にほか 14 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「NVIDIA は、7,530 億パラメーターのオープンウェイトモデル GLM-5.3 を卓上型の DGX Station 二台に分けて動かす例を示した。量子化後の重みは約 464 GB で、GB300 一個の広帯域メモリは 252 GB しかない。」https://secondsource.io/ja/news/2026-11-14-6/ (閲覧日閲覧)