本週 · 節目 10 月 9 日
Reflection AI 強化學習比預訓練耗算力。自報
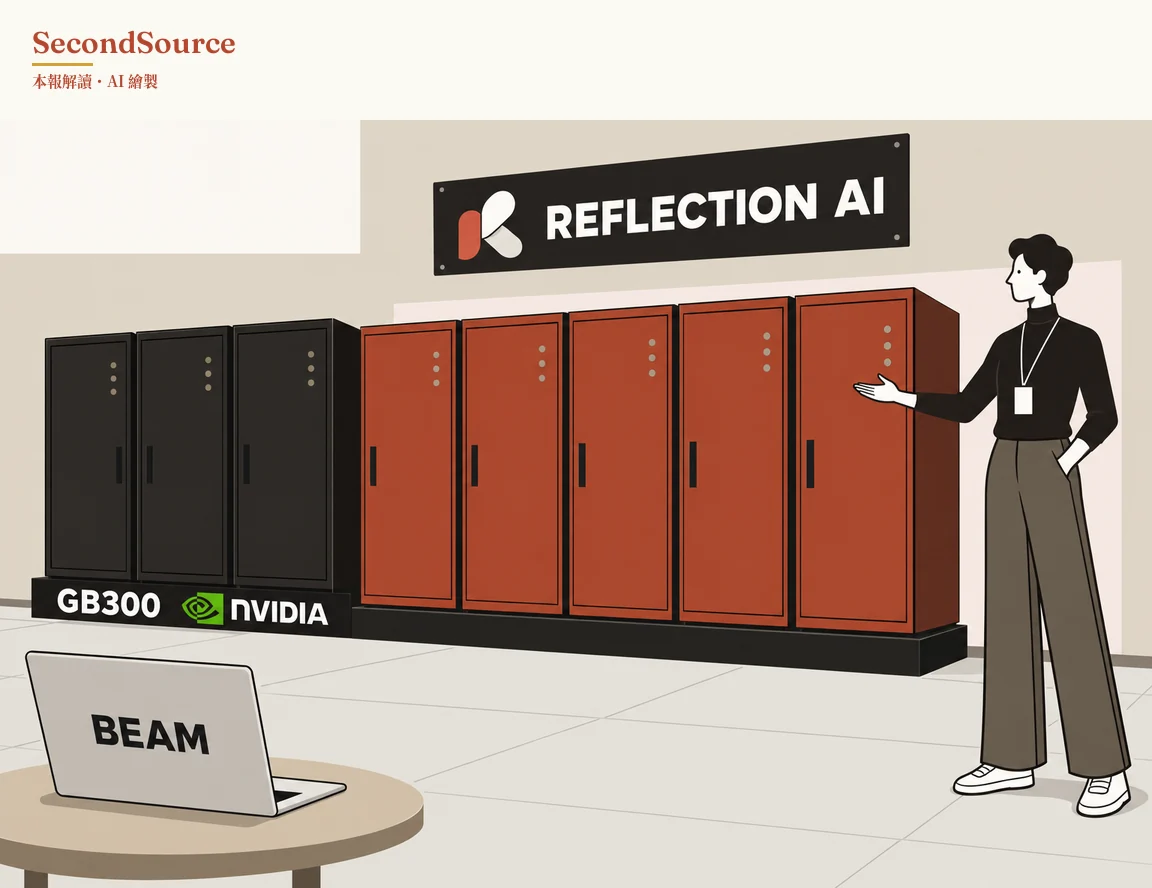
Reflection AI 執行長 Misha Laskin 說,自家開放模型 Beam 預訓練用了 6,000 顆 GB300、跑數週,強化學習用了一萬多顆、跑 4 週,花在強化學習上的算力比預訓練多。 預訓練是讓模型讀大量文字、學會接下一個字;強化學習是讓模型做題、依對錯給獎勵再調整。GB300 是 NVIDIA 最新一代的資料中心 GPU。Beam 總參數 5,000 億、每次只啟用 230 億,屬於混合專家架構,也就是每次只叫用一部分參數(No Priors,2026-10-09)。一般印象是預訓練最吃算力,他的說法正好相反,但沒說強化學習多用了多少。他另外提到預訓練現在約 12 天可跑完,那是現在的速度,不是這一版實際花的時間。這是公司自報,沒有第三方核對;Laskin 同一集的另一段話也出現在今日主線第 1 點。 怎麼查的 →
出處與查證
這則刊在2026年10月12日的晨報,同一期還有 13 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈Reflection AI 強化學習比預訓練耗算力。自報〉,https://secondsource.io/research/2026-10-12-2/,取用日期取用。