晨報 SecondSource 晨報 · 2026/10/12 · 2026年10月12日
Coinbase 說自家微調的開放小模型勝過最先進的大模型,是不是真的
三十秒看完
1. 只有執行長一則貼文、沒有評測:Coinbase 說微調的阿里 Qwen3.5-9B 在詐欺防治贏過前沿模型(當下最先進的那批模型)(影響:付大模型 API 費的團隊)
2. OpenRouter 自報:9 月第二週 73% 的花費付給封閉模型,1 月初是 89%(影響:管 AI 預算的人)
3. 本週專欄:投資人 Gavin Baker 說,董事若無視外部稽核報告可能被股東追究,所以 9 月 29 日六家 AI 公司在白宮簽的自願協定有約束力;本報判定這個說法存疑:這條追究董事的路很少走得通,而且只在出事後發動(影響:審 AI 供應商的合規主管)
本期資料來自本報 10 月 12 日清晨的研究日報與昨夜的掃描。主線事件日是 10 月 11 日,背景數字取自 OpenRouter 9 月 22 日的文章。本週專欄對帳 10 月 1 日的一句說法,並結算一條 8 月寫下的判斷。後面各欄的材料在 10 月 9 日到 11 日之間,過去洞見除外。昨夜掃了 118 篇,本期正文共用上 25 條有連結可查的外部來源。
本週專欄:AI 說法對帳
白宮 AI 協定沒有罰則,靠董事的法律責任就能約束簽署公司,是不是真的?
先講結論:科技基金 Atreides Management 創辦人 Gavin Baker 說,靠董事責任,這份協定就有約束力;本報的對帳結果是存疑。德拉瓦州法確實有追究董事責任這條路,但很少追究得成,而且只在出事後才發動。Baker 描述的「有委員會卻無視報告」,最接近一類歷史上全數敗訴的指控。要走通這條路,得有兩個前提:一個具名的外部稽核方,以及董事會裡接收稽核報告的委員會。本報 10 月 11 日搜尋,還沒找到任何一家簽署公司公開這兩樣。
誰說了什麼。 9 月 29 日,Google、Anthropic、Meta、OpenAI、xAI、NVIDIA 的領導人在白宮簽了一份自願協定,沒有罰則。10 月 1 日 Baker 寫:「If they ignore a report from the third party auditors then a bad faith finding from a court is a real possibility.」(Gavin Baker,2026-10-01)照他的說法,董事無視外部稽核報告,法院可能認定惡意,替董事承保責任險的保險公司也可據此拒賠。這裡的「惡意」是法律用語,不是指動機壞,而是董事明知該監督卻刻意不做;有些責任險條款會把這種故意不作為排除在外。他還說,這比幾乎任何監管動作在近期更有實際意義。
協定文字要求董事會設委員會接收稽核報告(本專欄最直接的證據,但讀的是轉載全文)。 第四層原文:「Designate an independent committee of the board of directors to oversee and receive reports from the teams operating the controls and the internal and external auditors and evaluators」(Zvi Mowshowitz 轉載全文,2026-09-30)。全文也寫明現在還不是法律:「Over time, it may make sense to codify these steps into laws or regulations.」⚠️ 全文本報只讀到這一個轉載通道(白宮新聞稿見 American Presidency Project 歸檔);這份轉載全文裡沒有要求公開稽核結果,也沒寫稽核方是誰。
德拉瓦法裡真的有這條路。 1996 年 Caremark 案確立董事有監督義務:董事要確保公司有機制盯住重大風險,沒做到,股東可以告董事。德拉瓦最高法院 2019 年在 Blue Bell 一案認定,沒替攸關使命的風險建立監督可能構成惡意,這屬於董事會根本沒建監督機制的情形。Anthropic 與 OpenAI 都是德拉瓦州公益公司,股東有法定權利調閱董事會資料,所以這條路至少適用於這兩家;其餘四家簽署公司,這段沒有逐一說明。以上判例與法條,本報在 10 月 4 日深度報告直讀原文整理過。
但這條路很少追究得成。 哥倫比亞法學院部落格 9 月刊出的實證研究統計,德拉瓦法院的這類監督義務指控,約 25.6% 撐過了起訴初期、沒有在正式審理前就被法官駁回;Blue Bell 案之後這個比例沒有變高。撐過只代表案子能繼續,不代表勝訴。同一研究裡,只主張「董事無視了警訊」的指控有 28 件,全部失敗(CLS Blue Sky Blog,2026-09-02)。⚠️ 單一研究。本報的判斷是:Baker 的情境是有委員會、卻無視報告,最接近這 28 件全敗的類型,而不是 Blue Bell 那種根本沒建機制的情形。
責任險拒賠要等終局判決(這一段證據最弱)。 德拉瓦最高法院 2021 年一則判決認定,在那張保單的條款下,除外條款要等「終局且不得上訴的裁判」才能啟動;這類條款是否涵蓋法院的「惡意」認定,要看各家保單怎麼寫。案子也可能在判決前和解:波音董事監督案和解金 2 億 3,750 萬美元,全由保險人支付。本報的推論是:要等到終局判決才能拒賠,這個威脅在實務上很少有機會用到。⚠️ 判決與波音和解兩項,本報讀的都是律所與業界部落格的摘要,沒有直讀原件。
協定簽署隔天,被報導有動作的是監管機關。 9 月 30 日華盛頓郵報找到美國聯邦貿易委員會(FTC)資深官員確認:「The Federal Trade Commission has opened a broad investigation into the safety of artificial intelligence systems made by Anthropic and OpenAI」(華盛頓郵報,經 Spokesman-Review 轉載,2026-09-30)。報導沒說 FTC 依據哪項權限、調查何時開始,也沒說和協定有關;FTC 本來就有調查權,用不到這份協定,這是本報的讀法。至於稽核方與委員會,本報只做了 10 月 11 日這一次搜尋,沒找到不代表不存在。專欄作者 Zvi Mowshowitz 另提前例:「OpenAI had exactly this committee, but they either were kept out of the relevant loops or failed to act.」
⚠️ 利益揭露:Baker 持有簽署公司的部位,貼文明講反對新設監管機構。本報的研究系統使用 Anthropic 的模型,Anthropic 是簽署方。
對帳結果:存疑。 成立的那一半是機制本身:董事會若收到稽核報告卻留不下處理紀錄,日後股東調閱時,這份紀錄可能成為對董事不利的證據。沒撐住的那一半是「比監管更有意義」:這條路只在出事後由股東發動,「無視警訊」型的指控全部敗訴,案子和解也照樣由保險人賠。協定簽署隔天,被報導展開調查的是 FTC,用的是它本來就有的權限(本報的讀法)。
什麼會推翻它。 ① 有簽署公司公布稽核方與委員會,且核保人在承保時開始詢問 AI 稽核情況:偏向成立,但本報還不會因此改變結論。② 出現委員會或稽核發現延後一次模型發布的公開報導:改判成立。③ 到 12 月 6 日(本報自設的觀察期限)六家都沒公布、FTC 調查卻已發出正式資料要求(要求公司交出文件的法律程序):「比監管更有意義」那半句改判不成立。
怎麼用。 供應商說「已簽協定」,問三件事:稽核方是誰、報告交給哪個委員會、你拿不拿得到稽核範圍說明。本篇對帳的是 Baker 這句話,不是協定該不該簽。
本期新開一條對答案。 到 12 月 6 日,六家簽署公司有沒有任何一家在自家官方管道,同時公布具名的外部稽核方與承接協定的董事會委員會。本報押「沒有」;只公布其一或只見媒體轉述都算沒有,結案只看六家官方新聞室與投資人關係頁。對答案 →
對答案:CoreWeave 第二季電話會上,會有分析師追問 Nvidia 兜底買了多少容量嗎?
①當時怎麼說:8 月 2 日專欄寫下這條預測,原句是「CoreWeave 下一份季報與電話會(2026Q2,預期 8 月中)是否被追問 Nvidia backstop 承接量,且公司是否給出 utilization 或承接量的可核數字」。CoreWeave 是出租 GPU 算力給 AI 公司的雲端廠商;兜底指 Nvidia 承諾買下它沒租出去的算力。當時沒記把握。
②實際讀數:事前指定的來源是 CoreWeave 2026 年第二季財報與 8 月 11 日電話會逐字稿。逐字稿全文沒有出現「backstop」,分析師問答沒有人問兜底承接量;公司沒揭露使用率或 Nvidia 承接量,只說近期產能「effectively sold out」。逐字稿是付費資料庫的版本,讀者無法公開取得,本報 9 月 30 日在其中查核;公開可看的是 CoreWeave 第二季財報。
③判定與落在哪一層:說中,但證據偏弱(理由見下)。當初寫下預測時事先寫好三種結果:分析師追問兜底承接量,算前半成立;公司揭露可核對的使用率或承接量,算後半成立;兩者都沒有,算「兜底讓財報看不出真實需求」這個預測說中。這個預測的道理是:Nvidia 承諾買下沒租出去的算力,空著的產能也有人付錢,所以使用率與營收不再單純反映外部客戶的需求。這次是第三種。沒成立的是當初引用的一個前提:創投 Benchmark 合夥人 Bill Gurley 說過,分析師會連續八季追問兜底這件事;結果第一次該問的時候就沒有人問。沒人問也可能只是分析師不關心,所以這筆結果對預測的支持有限。這條的到期日是 9 月 15 日,本報 9 月 30 日才查核,晚了 15 天。
④本報追蹤的判斷動了哪些:還沒動。這筆結果支持「兜底遮蔽需求訊號」的判斷,但如③所說支持有限;本報還沒重新評估,這條判斷的把握分數暫維持 0.6(本報對它成立程度的自評)。Nvidia 兜底條款那條事實本身沒變,不必動。
⑤判準改不改:改一處。「分析師會不會問」和「公司揭不揭露」以後拆成兩條,各自事先寫好占多少分量,免得落空的那半被蓋過。
8 月 AI 實驗室接連揭露的事故潮,是不是「舊事故集中被揭露」? 無法判定。到期那天,當初寫下的兩項會推翻這個判斷的情況都沒發生;但當初沒寫明怎樣算說中,所以沒有標準可判,細節在對答案卡上。對答案 →
Anthropic 的企業市佔率會不會掉到 35% 以下? 延期:目前還沒有可判讀的數字,要等 Menlo Ventures 下一份企業 LLM 採用報告。對答案 →
本報所有判斷與對答案日 → 判斷總表
今日主線
1. [今日](事件日 10 月 11 日)Coinbase 執行長說,自家資料微調的 90 億參數開放模型 Qwen3.5-9B 在詐欺防治勝過前沿模型
本報 AI 推測:Coinbase 執行長說微調開放小模型勝過前沿模型,比較對象與量法沒公開 2026-12-06 對答案 →
為什麼跟你有關: 先挑一個高量、規則明確的任務,記下現用模型的錯誤率與每次成本當基準。
展開看全文
Coinbase 執行長說,用內部資料微調的 Qwen3.5-9B 在詐欺防治勝過前沿模型(Armstrong,2026-10-11);Benaich 回應比的是舊模型(Benaich,2026-10-11)。OpenRouter 自報開放模型用量六成以上、73% 花費仍付給封閉模型(OpenRouter,2026-09-22);Laskin 說一般企業會先不微調(No Priors,2026-10-09)。
還不能當真: 貼文沒說比的是哪個模型、怎麼量;要等 Coinbase 公開這項任務的評測數字。 怎麼查的 →
⚠️ 本報的分析由 Anthropic 的模型協助產生,Anthropic 是封閉模型廠商之一。
今天可以帶走的動作:第1則:先挑一個高量、規則明確的任務,記下現用模型的錯誤率與每次成本當基準。
快訊
1. 還沒查證:[今日](貼文 10 月 11 日)創投 Social Capital 貼出企業支出平台 Ramp 的資料:Ramp 客戶的 AI token 花費裡,Anthropic 占比從 3 月的 69.5% 降到 51.0%,OpenAI 升到 44.5%;本報找不到 Ramp 的原始數字,Ramp 公開的 9 月讀數是另一種量法,付過款的企業占比 Anthropic 43.8%、OpenAI 39.8%(Social Capital,2026-10-11)。
2. 還沒查證:[今日](貼文 10 月 11 日)長期報導台灣半導體的記者 Dan Nystedt 轉述媒體報導,先進晶片測試報價預計漲 10% 到 30%,報導稱是「史上最強」的漲幅,點名日月光、京元電、力成、欣銓受惠;原始媒體沒具名(Dan Nystedt,2026-10-11)。
3. 還沒查證:[今日](報導 10 月 11 日)據南華早報報導,阿里巴巴董事長蔡崇信說開源 AI 是歐洲科技自主的唯一路徑;說話者是 Qwen 開放模型的供應方,本報讀到的是中國科技政策分析師 Paul Triolo 的轉述,報導全文沒讀(Paul Triolo,2026-10-11;南華早報)。
4. 還沒查證:[今日](貼文 10 月 11 日)半導體記者 Tim Culpan 寫,Musk 陣營規劃自建的晶圓廠計畫 Terafab 已向 ASML 下單極紫外光曝光機,研發廠預計 2027 年中交機,Intel 也在分享製程技術(是授權還是其他合作,貼文沒寫);台數、型號、金額都沒寫,交期他自己說偏軟。本報 10 月 11 日那期寫過分析師說四大設備商都已投入 Terafab,今天新的是下單與交期(Tim Culpan,2026-10-11)。
晶片與半導體
1. [今日](貼文 10 月 11 日)投資人 Gavin Baker 引 Silicon Data 的「token index」說,B300 自 5 月 31 日起漲了 38%、B200 漲了 10%;這個指數算不算租價、基期多少,本報都沒核到。 他寫:「Since the @Silicon_Data "token index," which captures both price and mix, peaked on May 31: B300 prices are up 38%, B200 prices are up 10%.」(Gavin Baker,2026-10-11)原句說的指數同時看價格與各機型的組成。B300、B200 是 NVIDIA 目前出貨的兩款資料中心 GPU,租價指在雲端租一張 GPU 每小時的價格;Silicon Data 是發布 GPU 租價指數的數據公司;這個指數怎麼和 token 掛鉤,原句沒說。原句說這個指數在 5 月 31 日見頂,B300、B200 的價格則從那天起上漲;指數見頂和價格上漲怎麼同時成立,原句沒解釋。本報只查到 Silicon Data B300 指數頁 上最新的讀數,每 GPU 小時 6.95 美元,沒查到 5 月底的基期,也沒確認這一頁和他引的「token index」是不是同一個口徑。Baker 是科技基金 Atreides Management 創辦人,持有相關部位;他據此推論模型市場越分散,對賣算力的人越有利,這是他的推論。
2. [今日](旁聽記錄 10 月 10 日)Qualcomm 告 Arm 的反壟斷案在德拉瓦開庭第四天,據旁聽者記錄,Arm 的經濟學家在交叉詰問下承認,最新一代 v10 架構授權全球只有 5 張。 架構授權是只向 Arm 取得指令集,處理器核心自己設計;Apple 與 Qualcomm 的 Oryon 核心都是這樣做。這和直接採用 Arm 設計好的核心不同。同一份記錄寫,法官說架構層的競爭「strictly Arm and Intel」,Arm 的經濟學家也說 RISC-V 在企業資料中心「barely off the ground」;Qualcomm 依現有合約可用到 2033 年,沒有 v10 新約就會「completely unlicensed」(庭審旁聽記錄,2026-10-10)。記錄者立場親 Qualcomm,這不是官方謄本,數字要等法院卷宗;法官當庭的話也不是判決,案子由法官審理、沒有陪審團。
大神觀點
1. [今日](貼文 10 月 11 日)前 Tesla AI 總監、OpenAI 創始成員 Andrej Karpathy 粗估,全球約 2,000 萬人在數學與程式工作上用前沿模型,約占人口 0.2%;他說爭論 AI 有多強的兩邊,站的是不同的層。 他自稱這是餐巾紙算術:約 60 億人幾乎沒碰過大型語言模型,約 10 億到 20 億人只在免費版輕度使用,約 2,000 萬人在數學與程式工作上用前沿模型,這群人親眼看過要做數週的專案,一個指令就交給 AI 做完,能用到實驗室內部前沿系統的約 5,000 人(Andrej Karpathy,2026-10-11)。他把這道落差歸因於三件事:想解的問題多大;AI 的能力不均勻,集中在數位、可驗證、值錢的領域;能用到哪一級的模型;所以「這只是聊天機器人」和「人類審查已經跟不上」可以同時為真。各層人數沒有普查,頂層的說法外界無法核實。聽人爭論 AI 能力時,先問對方用的是哪一級的模型、做的是哪類問題。
2. [今日](貼文 10 月 11 日)Wharton 商學院教授 Ethan Mollick 說,大企業導入 AI 的摩擦之一來自實驗室自己:產品與模型常突然改。 他說和幾位大企業領導者談過,模型本身已經好到企業總能想辦法用上,真正的摩擦是組織變革,加上實驗室頻繁又突然的變動:有領導者上個月才重押 OpenAI 的 GPTs(讓使用者自建客製 ChatGPT 的功能),隨即就被停掉;他也點名 Google 強制換模型,並說不只 OpenAI(Ethan Mollick,2026-10-11)。他也承認 GPTs 確實已過了有用的階段。這是他和少數領導者談話後的觀察,樣本有多大沒說。本報的讀法:怕供應商突然換模型,也可能是企業自己留一個開放權重模型的動機之一,這一點 Mollick 沒說。
模型觀點
1. [今日](貼文 10 月 11 日)Sakana AI 介紹與 UC Berkeley 合作的 MASS:讓同一個 270 億參數的開放模型扮成分工團隊,再用成功的合作紀錄微調自己。據公司貼文,跑兩輪後,每個輸出 token 換到的評測分數是原模型的 1.2 到 1.6 倍。 Sakana AI 共同創辦人 David Ha 導讀的做法分兩步輪流做:先讓模型演化出多個角色怎麼分工,再把成功的分工過程拿來訓練這個共用的模型;模型用自己產生的成功紀錄訓練自己;這算不算持續的自我改進,貼文沒有證明(David Ha,2026-10-11;Sakana AI,2026-10-11)。評測是研究類任務,貼文寫四個,只點名 MLR-Bench、ScienceAgentBench、DSBench 三個。這個比值是評測分數除以輸出長度,不等於能力提升 1.2 到 1.6 倍;比值變高也可能只是輸出變短,貼文沒分開給分數與長度的變化。論文自己警告:模型同時替自己打分數時,共同的盲點可能讓錯誤被當成進步、一路強化。⚠️ 數字只來自公司貼文,論文本報沒讀。
2. [本週](節目 10 月 9 日)Reflection AI 執行長 Misha Laskin 說,自家開放模型 Beam 預訓練用了 6,000 顆 GB300、跑數週,強化學習用了一萬多顆、跑 4 週,花在強化學習上的算力比預訓練多。 預訓練是讓模型讀大量文字、學會接下一個字;強化學習是讓模型做題、依對錯給獎勵再調整。GB300 是 NVIDIA 最新一代的資料中心 GPU。Beam 總參數 5,000 億、每次只啟用 230 億,屬於混合專家架構,也就是每次只叫用一部分參數(No Priors,2026-10-09)。一般印象是預訓練最吃算力,他的說法正好相反,但沒說強化學習多用了多少。他另外提到預訓練現在約 12 天可跑完,那是現在的速度,不是這一版實際花的時間。這是公司自報,沒有第三方核對;Laskin 同一集的另一段話也出現在今日主線第 1 點。
產品動態
1. [今日](10 月 11 日)xAI 共同創辦人 Igor Babuschkin 創辦的 River AI 推出推論服務,代跑 DeepSeek 與 GLM 兩個中國開放模型,報價比兩家原廠低 20%。 推論服務是把模型放在自己機房替客戶跑、按用量收費。公司公告:「River Inference is live! We're serving DeepSeek V4.1 Flash and GLM 5.3 Flash for 20% below official provider rates.」(River AI,2026-10-11)Babuschkin 說,他們用 Rust 從零寫了訓練與推論系統,並稱效率因此高出很多(Igor Babuschkin,2026-10-11)。比的是原廠哪一檔價格、延遲與限流怎樣都沒公開,便宜也可能是補貼搶客。本報的讀法:開放權重模型誰都能代跑,推論可以跟模型分開買;如果這個報價屬實又撐得久,DeepSeek 與做 GLM 的 Z.ai(智譜)兩家原廠自己的 API 生意就要面對第三方的價格競爭。
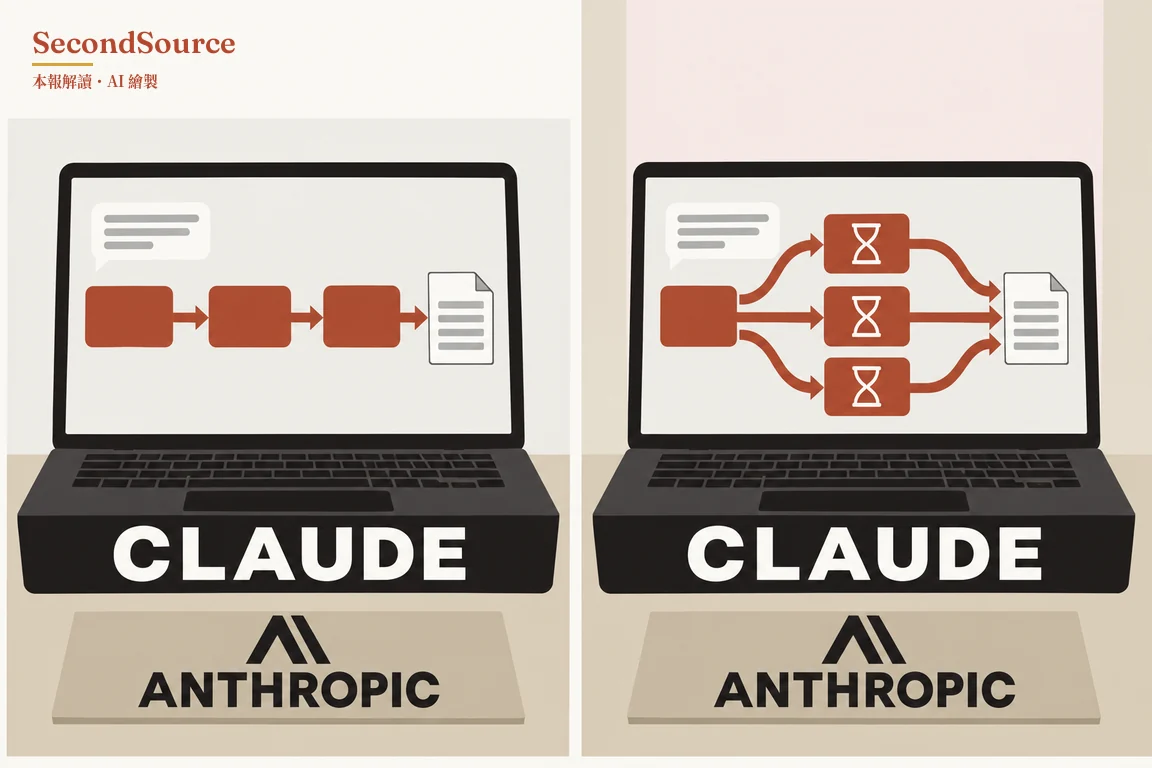
2. [今日](貼文 10 月 11 日)分析師 Patrick Moorhead 說,Claude 的聊天與 Cowork 合併後,他自訂的兩個研究流程一個從 20 分鐘變成 2 小時 57 分,另一個從 6 分鐘變成 3 小時,產出沒有變好。 Moorhead 是產業分析公司 Moor Insights & Strategy 首席分析師;Cowork 是 Anthropic 讓 Claude 自己動手做事的工作產品,他說的研究流程,是使用者事先設定好、能反覆套用的一組操作步驟(Patrick Moorhead,2026-10-11)。他追到四個原因:一次開很多分支平行做、不理會工具呼叫次數的上限、單次工具呼叫跑超過一小時、網路查詢額度用完後自己開瀏覽器操作電腦;用量額度也很快燒完。照他的診斷,模型現在會自己開很多條支線、每條又等很久,總耗時因此暴增。這是一位使用者的回報,「合併造成」是他自己的診斷,Anthropic 沒有公開回應。⚠️ 利益揭露:本報用 Anthropic 的模型協助分析,而 Claude 正是 Anthropic 的產品。
過去洞見
1. [回顧](深度報告 2026 年 10 月 7 日)AI 寫程式訂閱的「補貼」,看來主要是占用算力的問題,不是會計上的虧損。 「兩百美元方案用掉八千美元」量的是 API 牌價等值,標價含供應商利潤,不是成本;「毛利負 369%」量的是把上限用滿的極端情境;同一篇 SemiAnalysis 在平均使用率兩成下,算出中階方案小賺約 6%。
比較大的問題是算力:訂閱約占 Anthropic 一成營收,據 SemiAnalysis 估算,卻可能用掉四成以上的推論算力;2026 年各家公開的收緊理由多數是算力不夠,OpenAI 9 月 29 日砍半兩百美元方案新訂戶額度之前,9 月 10 日先以需求前所未見暫停販售,Anthropic 5 月算力到貨時則是放寬(深度報告,2026-10-07)。這篇深報也指出,額度限制早在 2025 年就開始了,所以不能把今年的方案收緊直接當成預測應驗。什麼情況會推翻這篇的判斷:主要供應商在大批算力到貨之後,仍收緊中階模型額度。本報這輪沒有回查,還沒有結果。對靠訂閱撐團隊開發的公司,曝險不是漲價,是供應商算力吃緊時額度先被砍;編預算時用「同樣用量改走 API 要付多少」當上限。⚠️ 本報自己也用 Anthropic 的模型協助分析,而它正是這裡討論的訂閱方案供應商之一。
本報不是新聞摘要:從每天的 AI 資訊流裡捕捉真正重要的洞見與值得長期追蹤的行家判斷,並交代每一條是怎麼驗證的。重點永遠是『哪條判斷變硬了、誰說得準』,不是今天發生了什麼。