Anthropic 寫,Claude Fable 5.1 在自傷題組上,經 API 直接使用時答得恰當的比例是 60%,在 claude.ai 套上系統提示詞後是 94%。
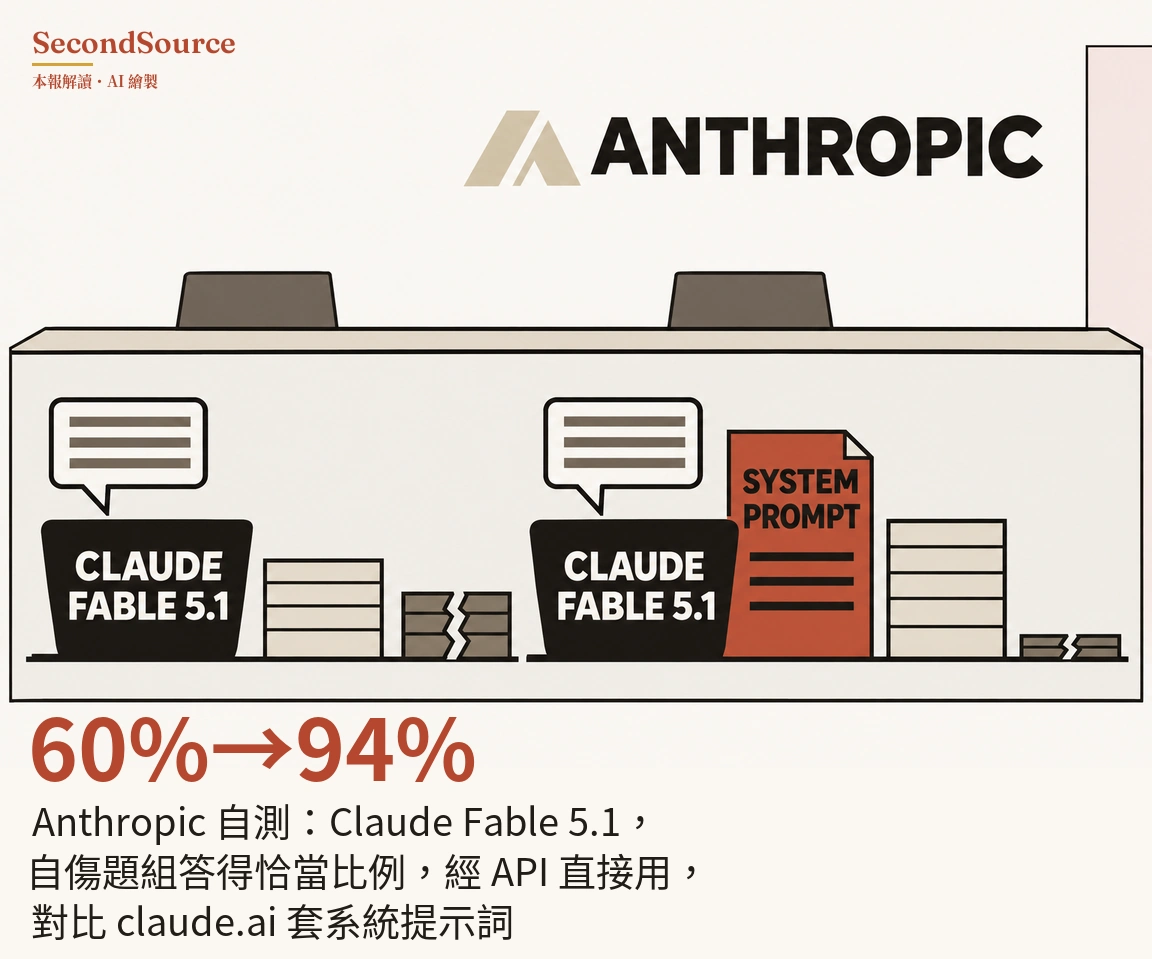
同一款模型的安全分數會隨部署設定大幅變動,拿 API 上的分數判斷 claude.ai 裡的表現會看錯,這是 Anthropic 自家評測。Anthropic 11 月 13 日的評測方法文另舉一例:Claude Opus 5 與 Opus 5.5 在愛情詐騙多輪評測上分別是 98% 與 94%,Anthropic 判定這個差距在統計上不顯著,不能說哪個較好。Anthropic 建議複雜的多輪評測至少 100 題、簡單的單輪評測至少 1,000 題,並寫多輪評測的信賴區間可超過正負 10 個百分點(Anthropic,2026-11-13)。 怎麼查的 →
出處與查證
這則刊在2026年11月14日的晨報,同一期還有 14 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈Anthropic 寫,Claude Fable 5.1 在自傷題組上,經 API 直接使用時答得恰當的比例是 60%,在 claude.ai 套上系統提示詞後是 94%。〉,https://secondsource.io/research/2026-11-14-3/,取用日期取用。