Anthropic によると、Claude Fable 5.1 が自傷の問題集で適切に答えた割合は、API から直接使うと 60%、claude.ai のシステムプロンプトを付けると 94% だった。
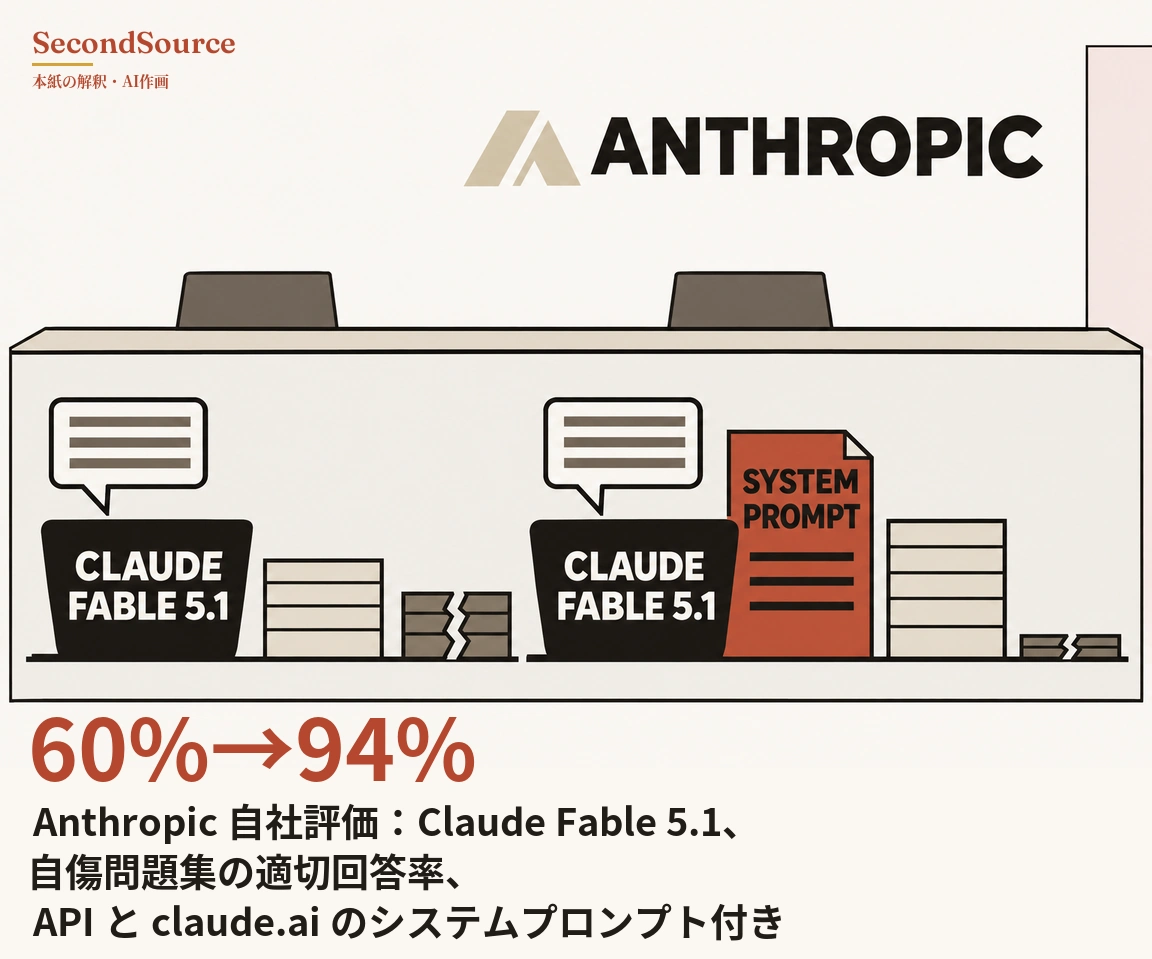
同じモデルの安全性の点数は配備の設定で大きく動き、API での点数から claude.ai での振る舞いを判断すると見誤る。評価は Anthropic が自社で行ったものだ。Anthropic は 11 月 13 日の評価方法の記事でもう一つの例を挙げた。恋愛詐欺の多ターン評価で、Claude Opus 5 は 98%、Opus 5.5 は 94% だったが、Anthropic はこの差が統計的に有意ではなく、どちらが優れているとは言えないと判定した。Anthropic は、複雑な多ターン評価には少なくとも 100 問、簡単な単ターン評価には少なくとも 1,000 問を勧め、多ターン評価の信頼区間はプラスマイナス 10 ポイントを超えうると書いた(Anthropic、2026-11-13)。 どう確かめたか →
出典と検証
この記事は2026年11月14日の夕刊に掲載されました(同じ号にほか 14 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「Anthropic によると、Claude Fable 5.1 が自傷の問題集で適切に答えた割合は、API から直接使うと 60%、claude.ai のシステムプロンプトを付けると 94% だった。」https://secondsource.io/ja/research/2026-11-14-3/ (閲覧日閲覧)