晨報 2026年10月16日
Meta 釋出 Spark Open 權重;Meta 自稱前沿的 Wonder 仍閉源,評分自報
三十秒看完
1. Meta 釋出 Muse Spark Open 權重,總共 8160 億參數,每個 token 只動用其中 420 億。以 API 賣模型服務、集團年營收逾 2,000 萬美元的公司要與 Meta 另簽。「美國最強」是 Meta 自報。
2. 台積電第三季晶圓營收裡,2 奈米占 8%、3 奈米占 33%,這是 2 奈米第一個入帳的季度。整體毛利率 66.4%,第四季指引 65% 到 67%,都是台積電申報的數字。
3. 金融時報報導 Anthropic 告訴投資人,蒸餾曾占營收 5% 到 7%、第三季已大幅縮減;四位匿名知情者,全文在付費牆後。
另有第 4 則:Anthropic 給 METR 員工級存取;第 5 則:禁建令過 400 項;第 6 則:Super Micro 換財務長。
今日主線
1. [今日](事件日 10 月 15 日)Meta 釋出 8160 億參數的 Muse Spark Open 開放權重,年營收逾 2,000 萬美元的模型服務商要與 Meta 另簽
為什麼重要: 美國開放權重供給回來,但開的不是 Meta 前沿模型,年營收逾 2,000 萬美元的模型服務商要另簽。
展開看全文
Meta 10 月 15 日釋出 Muse Spark Open 權重,8160 億參數、動用 420 億(AI at Meta,2026-10-15;Alexandr Wang,2026-10-15;Mark Zuckerberg,2026-10-15;Hugging Face,2026-10-15)。賣模型服務年營收逾 2,000 萬美元須另簽(模型頁,2026-10-15)。最強說法是 Meta 自報。
還不能當真: 「美國最強開放權重」只有 Meta 自報 怎麼查的 →
判斷更新: 本報新記一條還在驗證的判斷:Meta 把前沿模型留在內部、上一代開出去,開的那份對模型服務商設營收門檻。「上一代」是本報依發布時序與命名推論的,把握度維持不變。什麼會推翻它:Meta 在 2027 年 4 月 15 日前釋出 Wonder 的權重,或同一份獨立評測的總分上,Spark Open 與 Wonder 相差不到 3 分。期限與 3 分門檻都是本報自設的。
2. [今日](事件日 10 月 15 日)台積電第三季毛利率 66.4%,2 奈米第一個入帳季度就占晶圓營收 8%,第四季營收指引 523 到 543 億美元
為什麼重要: 先進製程占比與毛利率一起走高,但新聞稿沒有單價,看不出台積電是不是調高了價格。
展開看全文
台積電第三季營收 467.2 億美元、年增 41.2%,毛利率 66.4%;2 奈米第一個入帳季度就占晶圓營收 8%、3 奈米占 33%;第四季指引營收 523 到 543 億美元、毛利率 65% 到 67%(台積電 6-K,2026-10-15)。第四季營收指引中點比第三季營收高約 14%,這是本報算術。
還不能當真: 毛利率走高的來源,新聞稿沒有單價 怎麼查的 →
判斷更新: 本報追蹤中的一條還在驗證的判斷說,NVIDIA 與台積電手握稀缺卻刻意不把價定到頂,為的是避開反壟斷注意、不逼客戶轉向替代品。毛利率升到 66.4%,第四季指引還在 65% 到 67%,看起來像價格已經往上限靠,這與那條判斷有張力。但毛利率上升也可以來自 2 奈米與 3 奈米占比變高,或來自匯率,新聞稿本文沒有單價。本報把張力記在那條判斷旁,判斷本身不改。分得出這兩種讀法的,是法說會簡報裡有沒有談到 2 奈米的價格。
3. [今日](報導 10 月 15 日)金融時報報導,Anthropic 告訴投資人蒸餾曾占營收 5% 到 7%,第三季已大幅縮減
為什麼重要: 若這份單一報導屬實,Anthropic 擋蒸餾的代價可以用營收來算,因為付錢用模型的對手本身就是營收來源。
展開看全文
長期寫 LLM 實務的獨立開發者 Simon Willison 10 月 15 日逐字摘引金融時報的報導(Simon Willison,2026-10-15),報導全文在付費牆後(金融時報,2026-10-15)。引句:「Anthropic told investors on Wednesday distillation accounted for 5 per cent to 7 per cent of revenue and that they had cut it back 'materially' in the third quarter of the year」,四位直接知情者說的。蒸餾在這裡指對手實驗室用 Anthropic 模型的輸出去訓練自家模型。Willison 列的其他數字:第二季營收 115 億美元、第三季 168 億;第三季每 1 美元算力支出對 1.70 美元營收。
本報 10 月 15 日那期快訊提過第三季營收 168 億美元,今天新的是蒸餾那一句。同一期大神觀點引過計算治理研究者 Lennart Heim 的估計:擋住蒸餾約多換 12 個月的領先。Heim 估的是擋蒸餾對整個產業領先期的效果,5% 到 7% 是 Anthropic 一家、期間不明的營收占比。兩個數字量的不是同一件事,本報不把它們接成代價與收穫。
還不能當真: 占比是哪個期間,引句沒寫、全文未經查閱 怎麼查的 →
判斷更新: 本報有一條還在驗證的判斷:前沿模型的訓練成本要在發布後幾個月的領先期收回,之後競爭與蒸餾會把毛利壓到次前沿的水準。本報把這叫窄窗經濟。Anthropic 據稱大幅縮減蒸餾流量,等於用當期營收換領先期的長度,這是本報的讀法。單一來源,不調高把握度。Willison 的摘引沒寫第三季 168 億美元的營收有沒有扣掉蒸餾那一塊。這對投資判斷的意思:若這份單一報導屬實,各家實驗室的季增率有沒有把蒸餾流量算進去,會影響彼此的可比性;這是本報要檢驗的讀法,不是結論。
4. [今日](事件日 10 月 15 日)Anthropic 給評測前沿模型風險的非營利機構 METR 六人員工級存取,METR 發表報告 Anthropic 不能否決,只能依預定類別要求刪節
為什麼重要: 自願制外部評測有了寫明發表權的實例,但存取範圍與續約仍在被評公司手上。
展開看全文
Anthropic 10 月 15 日宣布給專門評測前沿模型風險的非營利機構 METR 六名員工「員工級存取」,與自家風險評估團隊大致相當;METR 發表分析 Anthropic 不能否決,只能依客戶資料、律師特權、模型架構三類預定類別要求刪節(Anthropic,2026-10-15)。全為被評方陳述,合約文本不在本期資料範圍內。
還不能當真: 合約文本與 METR 的說法不在本期資料內 怎麼查的 →
判斷更新: 本報 9 月 23 日在判斷帳上記了一條還在驗證的判斷,當天的晨報沒有刊出。判斷是:Anthropic 第一個嵌入評測夥伴 Accenture 同時在賣 Claude,所以「有第三方評測」還不能當成獨立查核。本報當時自設的推翻條件是「數週內有 METR 型機構拿到存取並公開寫明發表權」。今天的發表權安排只出現在 Anthropic 的新聞稿裡,METR 側還沒有證實,刪節期限也沒寫,所以那條判斷先不改。另一條判斷說,自願制評測的保證有上限,因為公司握著存取、刪節、續約三道關卡。依 Anthropic 的說法,存取與刪節兩道今天讓出了一部分,續約仍由 Anthropic 決定。
5. [今日](貼文 10 月 15 日)投資人 Kevin Xu 稱追蹤到的美國資料中心禁建令已超過 400 項,多數是一年內到期的暫停令
為什麼重要: 禁建令若多在 2027 年到期,衝擊會先反映在 GPU 租價還是供應商的在手訂單,到時候對得出答案。
展開看全文
Kevin Xu 10 月 15 日的長貼(Kevin Xu,2026-10-15):Kevin Xu 從 1 月起追蹤美國資料中心禁建令,3 月在自家基金網站建了公開儀表板,「Now that the total count has crossed 400」。四個論點:禁建擠掉只想簽租約借錢的劣質業者;「a slower pace of construction caused by these moratoriums keeps supply of compute even tighter, raises GPU rental prices, extends their usefulness」;「the vast majority of them are one year long or shorter, stretching into mid to late 2027」,400 多項是暫停不是禁止;禁建潮跨黨派。Kevin Xu 是投資中美科技的基金 Interconnected Capital 創辦人。貼文沒有揭露基金持倉。「禁建對 AI 長期有利」的立場與一家投資科技股的基金利益可能一致,這是本報的推論。
本報 10 月 8 日那期過去洞見寫過,SemiAnalysis 盤點約三百條地方禁令、真正讓專案延後的約 2.3GW。Xu 的 400 多項是另一把尺。兩邊對「暫停」「研議」「禁止」的算法不同,數字不能互證。
還不能當真: 計數方法不在貼文裡,儀表板未經查閱 怎麼查的 →
判斷更新: 本報有兩條關於禁建潮的判斷:一條說現有的禁令統計只算得出專案延後多少,算不出有多少專案直接放棄;另一條說禁建的衝擊會被在建專案與供應商的在手訂單遮住一到兩年。Xu 的「多數一年內到期」與第一條同向;Xu 的「先反映在 GPU 租價」與第二條方向相反。兩條都是主張,本報並列、不選邊。可對答案的是 GPU 租價在 2027 年上半年有沒有先動。
6. [今日](事件日 10 月 14 日)Super Micro 換財務長:David Weigand 卸任,前 Western Digital 財務長 Mark Long 即日接任,申報未寫原因
為什麼重要: AI 伺服器組裝大廠換財務長,申報沒寫原因,先記下(今天沒有新判斷)。
展開看全文
Super Micro 10 月 15 日申報,董事會 10 月 14 日任命前 Western Digital 財務長 Mark Long 即日接任財務長,David Weigand 卸任;申報沒寫原因與 Weigand 去向(Super Micro 8-K,2026-10-15)。
還不能當真: 申報沒寫更換原因與 Weigand 去向 怎麼查的 →
對答案: 本報 7 月 31 日記下的判斷「Kimi K3 官方定價頁的混合實價會在 10 月 15 日前跌破每百萬 token 0.5 美元」沒說中:10 月 15 日官方定價頁的快取輸入、輸入、輸出三價按 7:2:1 加權的混合價是每百萬 token 2.31 美元。Kimi K3 的官方牌價沒有照本報預期往下走。卡片 →
晶片與半導體
1. [本季](arXiv 預印本,2026 年 10 月)ETH Zürich 與 NYU 的 SAFARI 組實測 36 顆 HBM2,找出一種存取模式,功耗比業界記憶體標準 JEDEC 規範裡最耗電的量測迴圈平均再高 23.6%。 原句:「we engineer an access pattern that yields 23.6% higher power consumption on average across 36 tested HBM2 chips than the highest-power-consuming JEDEC-specified current measurement loop」(arXiv 2610.14244)。另一組對照:全部 bank group 的匯流排訊號翻轉,比保持常值多耗 29.4%。作者的新功耗模型對 3 台 NVIDIA H200 驗證,誤差 2.4% 到 5.3%。只測了 HBM2,不是 HBM3E 或 HBM4;36 顆是哪家的晶片、量測溫度與頻率,摘要沒寫,論文全文未經查閱。本報的讀法:對 HBM2 來說,刻意設計的存取模式可以超過 JEDEC 量測迴圈的功耗。真實工作負載會不會接近這個值、HBM3E 與 HBM4 是否一樣,摘要沒有回答。 怎麼查的 →
2. [本季](發布 9 月 30 日)PyTorch 2.14.1 升到 CUDA 13.2.2,修掉 cuBLAS 在 NVFP4 矩陣乘法可能忽略整個張量縮放係數的問題。 版本說明原句:「cuBLAS: `cublasLtMatmul()` could ignore tensor-wide scaling for NVFP4 matrix multiplications (introduced in CUDA 13.2 Update 1)」(PyTorch 2.14.1 版本說明,2026-09-30)。NVFP4 是 NVIDIA Blackwell 用的 4 位元浮點格式。同系列 2.14.0 在 9 月 2 日把 Inductor 編譯器鎖定下一代 Rubin 架構(sm_107),並內建 NVFP4 矩陣乘法(PyTorch 2.14.0 版本說明,2026-09-02)。受影響範圍與出錯案例,版本說明沒有量化。 怎麼查的 →
大神觀點
1. [今日](貼文 10 月 14 日)買方研究者 Rihard Jarc 說,信用收緊時瓶頸會變成資本,既有算力更稀缺,算力價格反而可能上漲。 Jarc 經營科技股研究服務 UncoverAlpha。Jarc 寫,若放款條件惡化,AI 建設放慢,需要外部資金蓋機房的 GPU 雲會受傷,但對 Amazon、Microsoft、Google 「the conditions are not that bad」,因為競賽放慢、資本支出壓力減輕,而「compute prices might even rise more as less new data center capacity gets funded」(Rihard Jarc,2026-10-14)。這是條件式推論,零量化數字;需求同時走弱時價格仍可能下跌。與今日主線第 5 點合看:Kevin Xu 說禁建抬高 GPU 租價,Jarc 說資本枯竭抬高算力價,兩人沒有互相回應,方向相同但不能當成兩個來源。若兩人都對,算力價格除了看建設進度,也要看融資條件,這是本報的推論。 怎麼查的 →
模型觀點
1. [本季](發布 9 月 3 日)阿里巴巴 Qwen 團隊與淘寶天貓發布 E-Commerce Bench:18 個模型各經營一年模擬網店,只有 Qwen 自家一個模型明顯學會把重複採購價壓低,年末總資產第一的 GPT-5.6 Sol 防詐排第 16。 每個模型本金 10 萬人民幣、跑 5 回合。年末資產:GPT-5.6 Sol 143 萬人民幣,Qwen3.5-Plus 平均只剩 1,100。防詐:流向詐欺供應商的採購占比,Claude Opus 4.7 0.12%、Qwen3.5-Plus 20.11%,不篩選的基準是 26.4%。對接觸過的詐欺供應商下單的比例,GPT-5.6 Sol 是 31.7%,Claude Opus 4.7 是 4.0%。學習指標 AnchorRatio 量同一供應商同一商品的重複採購價有沒有越談越低,1.0 等於與隨機無異,低於 1.0 代表越買越便宜。原句:「Over a full year, the models do not get better at buying. Qwen3.8-Max-Preview is the only one of the 18 showing a clear sign of long-horizon learning, at an AnchorRatio of 0.834」(Qwen 部落格,2026-09-03)。Qwen3.5-Plus 與唯一會學的 Qwen3.8-Max-Preview 是同一家的兩個模型。這是 Qwen 自建的評測,唯一會學的是 Qwen 自家模型,論文與程式碼未經查閱。本報的讀法:長程代理人只看總資產會漏掉防詐與學習兩個失效面。 怎麼查的 →
2. [本週](預印本 10 月 13 日)一篇 arXiv 論文用隨機開關實驗篩選代理人寫下的教訓手冊:篩過的手冊平均成功率 66.9,不用手冊 54.1。整份照用 55.5,讓代理人挑選 53.8。 方法叫 RBC,隨機開關手冊裡的每條教訓,用成功率差估每條的效果。原句:「the same procedure can write a playbook that helps or one that falls up to 69.6 points below no playbook」(arXiv 2610.18427)。受測模型與評測基準的名稱摘要沒寫。成功率的單位與基準也沒寫,全文未經查閱。同日另外三篇預印本也只改提示、記憶或工作流程、不改權重,並用保留資料或獨立驗證決定要不要採納(arXiv 2610.18216;arXiv 2610.18813;arXiv 2610.18845)。代理人「自我改進」在這批論文裡指的是外層配方加統計守門,不是改模型權重,這是本報的讀法。同日出現四篇可能是巧合,本報只記為還在驗證的觀察。 怎麼查的 →
3. [本週](模型卡更新 10 月 14 日;模型 8 月 25 日發表)Z.ai 更新 GLM-5.3 模型卡的自報評測表:16 項裡只有三項居首,寫漏洞利用程式的 ExploitBench 得 54.4,Fable 5 得 78.0。 GLM-5.3 居首的三項是 CyberGym、AutomationBench、GDPval-AA。CyberGym 是模型卡寫的漏洞發掘基準,GLM-5.3 84.5、Fable 5 83.8、GPT-5.6 Sol 83.6(GLM-5.3 模型卡,2026-10-14)。模型卡原句:「GLM-5.3 uses the same base model as GLM-5.2 — every gain comes from post-training.」各欄用的工具外框不同,分數全為 Z.ai 自報、沒有獨立評測。與過去洞見合看:GLM-5.3 自報找漏洞的分數與閉源旗艦幾乎同分,寫利用程式仍落後一段。這是一個模型的自報分數,說明不了整類開放權重模型。 怎麼查的 →
產品動態
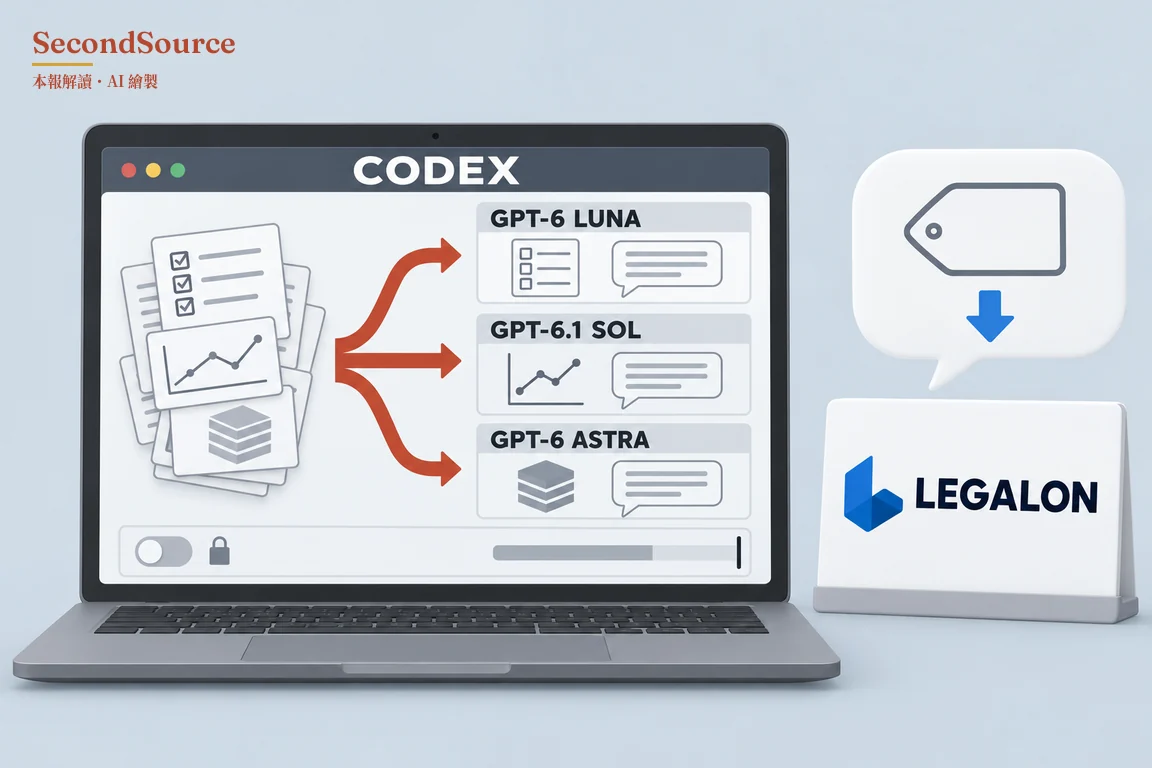
1. [商業](案例頁未標日期;本報 10 月 15 日讀到)OpenAI 客戶案例:法務軟體公司 LegalOn 把程式代理人 Codex 的任務分派給三檔 GPT-6 模型,再加上模式限制與預算上限,估算每日成本比先前低約 65%。 三檔是 GPT-6 Luna、GPT-6.1 Sol、GPT-6 Astra。模式限制是預設限制快速模式,比較基準是先前不限量用 GPT-5.5 Fast。原句:「Together, model selection, feature restrictions, and budgets tailored to each business reduced estimated daily costs by approximately 65%.」(OpenAI,案例頁)分層是最輕的 Luna 做需求明確的實作與子代理,Sol 做設計與分析,最強的 Astra 做架構。65% 是三項措施合計,不是單靠換模型;是客戶自報的估算數字、由供應商刊出,量測期間沒寫。案例頁標題寫的是減半,內文數字是約 65%。任務分檔是三項省錢措施之一,三項各省多少案例頁沒有拆,所以看不出分檔占了多少。 怎麼查的 →
過去洞見
1. [回顧](深度報告 2026 年 9 月 6 日)「這道資安閘還撐多久」沒有一個答案,答案取決於要防的是誰。 這道資安閘指 OpenAI 只把最強的資安能力開給審核過的防守方;閘能撐多久,要看閘外的開放權重模型多快追上。9 月 3 日 OpenAI 拿 10 億美元抵用額度補貼自來水廠、電網、地方政府、社區銀行,設定六個月用完。把這筆補貼跟「開放權重只落後幾個月」並讀成「閘還剩六個月」很誘人,但補貼期限和「開放權重只落後幾個月」這兩個讀數沒有共同單位,而且都出自 OpenAI 同一家、同一個申請入口。本報 9 月 6 日的深度報告認為站得住的是英美政府 7 月 23 日聯合評估的兩個讀數:對防護紮實的目標,當時最新的開放權重旗艦41 次嘗試裡拿到程式執行控制權 0 次,前沿模型 41 次裡 20 次;但同一份評估寫,這款開放權重旗艦已能自主攻擊防護薄弱的小型企業系統(深度報告,2026-09-06)。補貼點名的自來水廠、電網、地方政府、社區銀行,有一部分可能就是防護薄弱的系統,這是本報的讀法;評估測的是小型企業系統,沒有直接測這些組織。所以「閘還剩多久」要按對手的防護強度分開回答:對防護紮實的目標,7 月的評估顯示還守得住;對防護薄弱的小型企業系統,評估顯示 7 月 23 日已經守不住。與模型觀點第 3 則合看:GLM-5.3 模型卡自報找漏洞已與閉源旗艦接近、寫利用程式仍落後,是同一份清單上又一個待核的讀數。模型卡的自報分數與英美政府的評估不是同一把尺。 怎麼查的 →
快訊
1. 還沒查證:[今日](貼文 10 月 14 日)匿名半導體供應鏈評論帳號 zephyr_z9 稱,SK Hynix 的 HBM4 後段封裝問題卡了一年多,過去讓 SK Hynix 領先的 MR-MUF 注膠法成了問題來源,並預測 Samsung 明年 HBM 市占第一;無廠方披露,被引的 ZDNet 3 月報導未經查閱(zephyr_z9,2026-10-14)。
2. 還沒查證:[今日](貼文 10 月 14 日)創投人 Chamath Palihapitiya 轉引爆料帳號 unusual_whales:Anthropic 的上市前永續合約在交易平台 Liquid 跌破 2 兆美元、一個月跌逾 10%;Liquid 報價頁未經查閱,這種永續合約是對未上市股權的衍生品報價,不等於 Anthropic 實際融資的估值(Chamath Palihapitiya,2026-10-14;unusual_whales,2026-10-14)。
3. 還沒查證:[今日](貼文 10 月 14 日)科技股分析師 Beth Kindig 轉述 Citi 估計:代理人用 CPU 的市場規模從 2026 年 116 億美元升到 2030 年 1,574 億美元、占總 CPU 市場過半;Citi 報告原文未經查閱,口徑未明(Beth Kindig,2026-10-14)。
4. 還沒查證:[今日](貼文 10 月 14 日)獨立評測者 Lech Mazur 的短篇創作榜:Muse Wonder 得 1.96 分、閉源的 Muse Spark 1.3 得 0.56,分數以榜上全部寫手模型的平均為零點;被比的不是 Spark Open,單一評測者、LLM 當評審(Lech Mazur,2026-10-14)。
5. 還沒查證:[今日](10 月 14 日)Simon Willison 寫,在 Claude iPhone app 的聊天模式下一句 prompt 讓 Opus 5.5 Max 連續跑了 3 小時 7 分鐘,做出一個找不同小遊戲;單一使用者自述、時長是介面顯示(Simon Willison,2026-10-14)。
6. 還沒查證:[今日](貼文 10 月 14 日)小鵬汽車執行長何小鵬在巴黎發表 XPENG AI ENGINEERING 開放平台,稱把整車平台、核心技術與工具鏈開放給全球夥伴,並稱明年把導航輔助駕駛 NGP 帶給歐洲駕駛;夥伴、條款、時程都是執行長自述(何小鵬,2026-10-14)。
本報不是新聞摘要:從每天的 AI 資訊流裡捕捉真正重要的洞見與值得長期追蹤的行家判斷,並交代每一條是怎麼驗證的。重點永遠是『哪條判斷變硬了、誰說得準』,不是今天發生了什麼。