AI 検索の Perplexity は、一つの API で 85 以上のモデルにつなぐ Orchestrator API を出した。自社の試験 63 問のうち、Claude Fable 5.2 が拒んだ問題を OpenAI のモデルに回すと 41 問を解いた。Fable 5.2 だけでは 38 問だった。
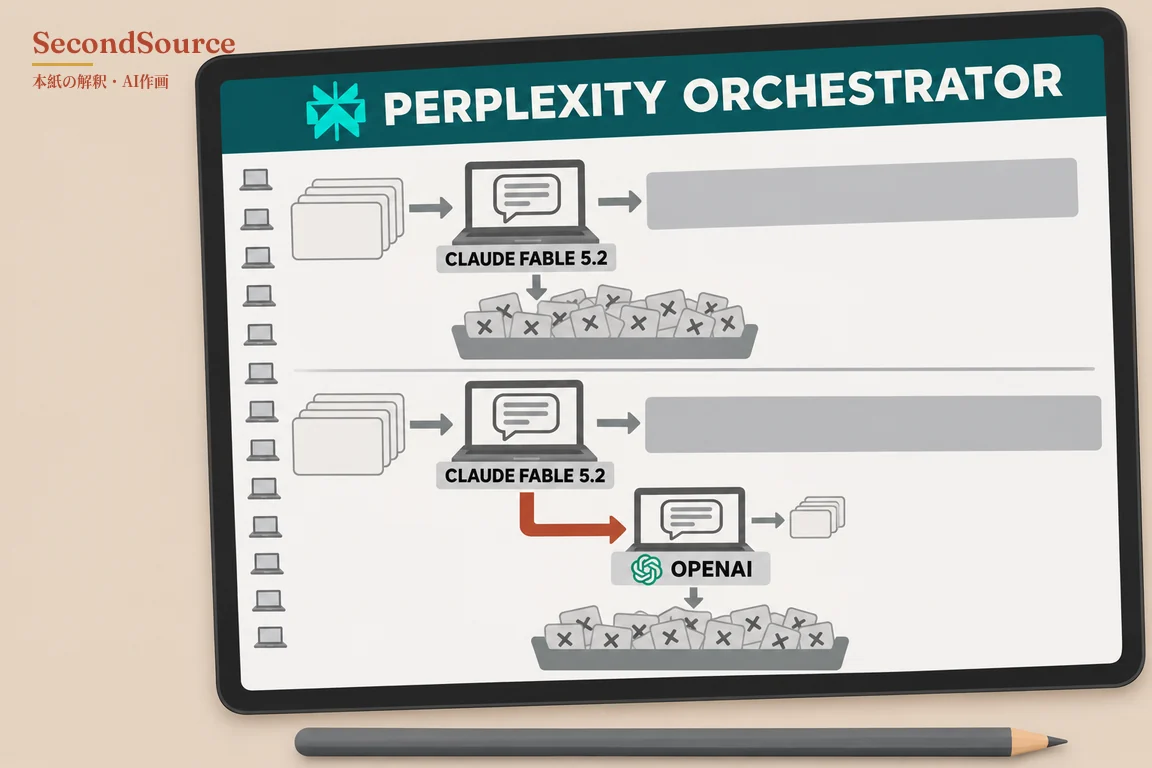
拒否を別の会社のモデルに回すと 41 問を解き、Fable 5.2 だけの 38 問を上回ったが、Perplexity が自社で一度走らせただけで、41 問と 38 問の差が偶然かは判別できない。一問あたりのコストも、Fable 5.2 だけの場合より高い。問題は Terminal-Bench 4.1 から選んだ 63 問の部分集合である。同じモデルがある提供元で失敗すると、Orchestrator は別の提供元で再試行する(Perplexity、2026-11-17)。 どう確かめたか →
出典と検証
この記事は2026年11月18日の夕刊に掲載されました(同じ号にほか 14 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「AI 検索の Perplexity は、一つの API で 85 以上のモデルにつなぐ Orchestrator API を出した。自社の試験 63 問のうち、Claude Fable 5.2 が拒んだ問題を OpenAI のモデルに回すと 41 問を解いた。Fable 5.2 だけでは 38 問だった。」https://secondsource.io/ja/product/2026-11-18-2/ (閲覧日閲覧)