Simon Willison 用開源模型在筆電上讀出權重在玩哪款遊戲,四題對三題
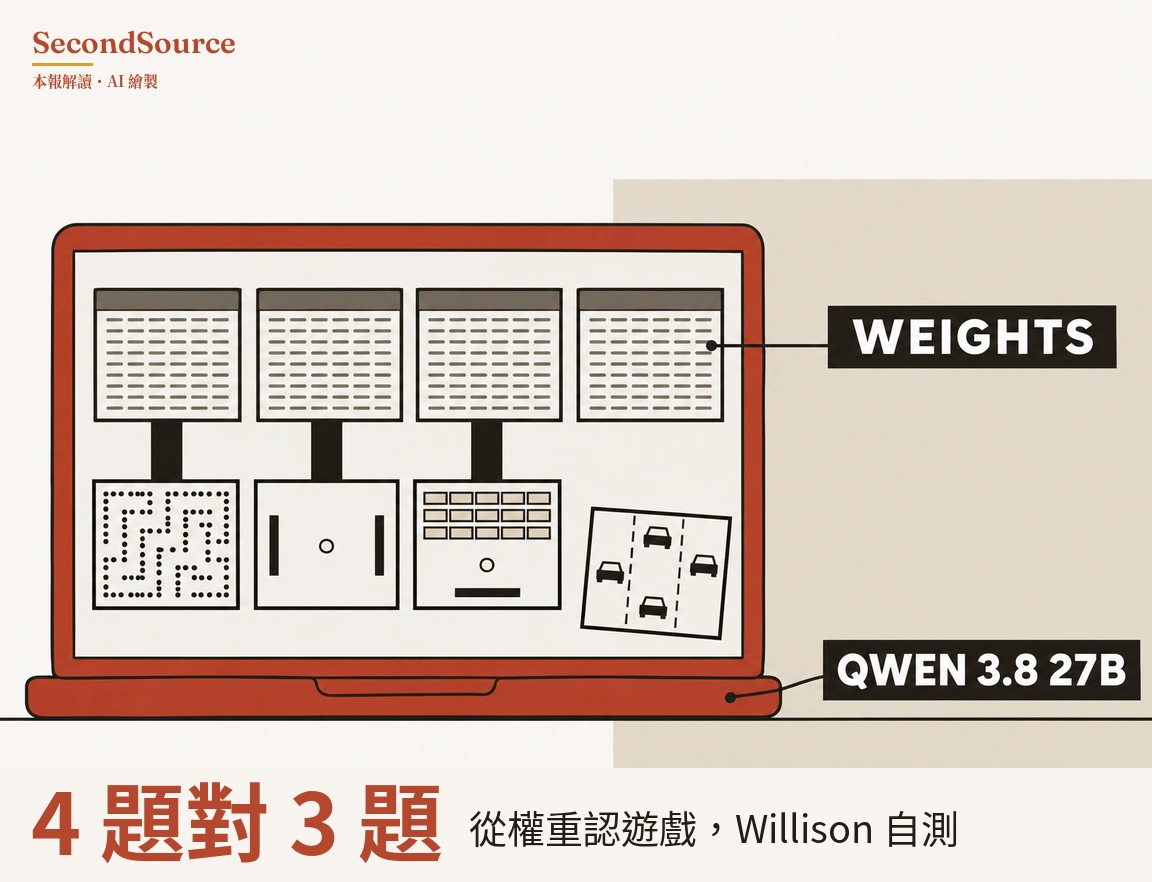
軟體工程師 Simon Willison 11 月 3 日在筆電上重跑一篇論文的實驗,論文說前沿模型能讀懂、也能修改神經網路的權重。據 Simon Willison,筆電上的開源模型也認得出小網路的任務;改權重那一半沒人重現。
Simon Willison 回應的是一篇 11 月 2 日在 X 上爆紅的論文。據 Simon Willison 引用的論文摘要,Rikiya Takehi 等人的〈Sparks of Weight-Space Programming〉說,OpenAI 的 GPT-6 Astra 只看原始權重就能說出一個小網路是訓練來做什麼的,還能只改 Qwen3.5-0.8B 的 0.016% 權重,把數學評測 MATH-500 從 7.9% 拉到 48.1%,這些是作者自報的結果(論文作者原貼,2026-11-02)。
Simon Willison 只重跑了「讀」的那一半。Simon Willison 是英國軟體工程師、Django 共同創作者,長期公開可重跑的模型實測;這次用的是論文公開的四個小型遊戲策略網路。權重以浮點數貼進提示,不給任何工具,問模型在玩哪款遊戲。筆電上跑的是約 17 GB 的開源模型 Qwen 3.8 27B,答對 Pac-Man、Pong、Breakout,答錯 Freeway,一題花 46 分鐘到 1 小時 5 分。同一題 Breakout,月之暗面的 Kimi K3.1 Pro 經雲端服務 OpenRouter 跑,不到 10 分鐘答對,硬體不同,耗時不能和筆電直接比(Simon Willison,2026-11-03)。
Simon Willison 的結論是兩件事要分開看。讀權重認任務成立,但「一個有經驗的人拿紙筆也做得到」;用工具改另一個模型的權重,Simon Willison 沒測,也還沒有人重現。spaCy 作者 Matthew Honnibal 說論文把兩件事混在一起會誤導人,工程師 Sean Goedecke 指改權重的步驟和人類研究員平常做的一樣,兩人的話都經 Simon Willison 轉述。
還不能當真: 一個人、四道題各跑一次、一款開源模型 怎麼查的 →
接下來看有沒有獨立團隊用論文公開的程式碼重跑改權重那一半,以及有沒有人證明開源模型讀不出更大、更一般的網路。
出處與查證
這則刊在2026年11月4日的晨報,同一期還有 10 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈Simon Willison 用開源模型在筆電上讀出權重在玩哪款遊戲,四題對三題〉,https://secondsource.io/news/2026-11-04-4/,取用日期取用。