NVIDIA 推出新的集合通訊函式 Reshard。強化學習每輪訓練後要把新權重搬到推論 GPU,這一步叫 refit;在 NVIDIA 的強化學習訓練框架 NeMo RL 上,refit 時間降到原來的 1/2.7 到 1/5.7,數字是 NVIDIA 自測。
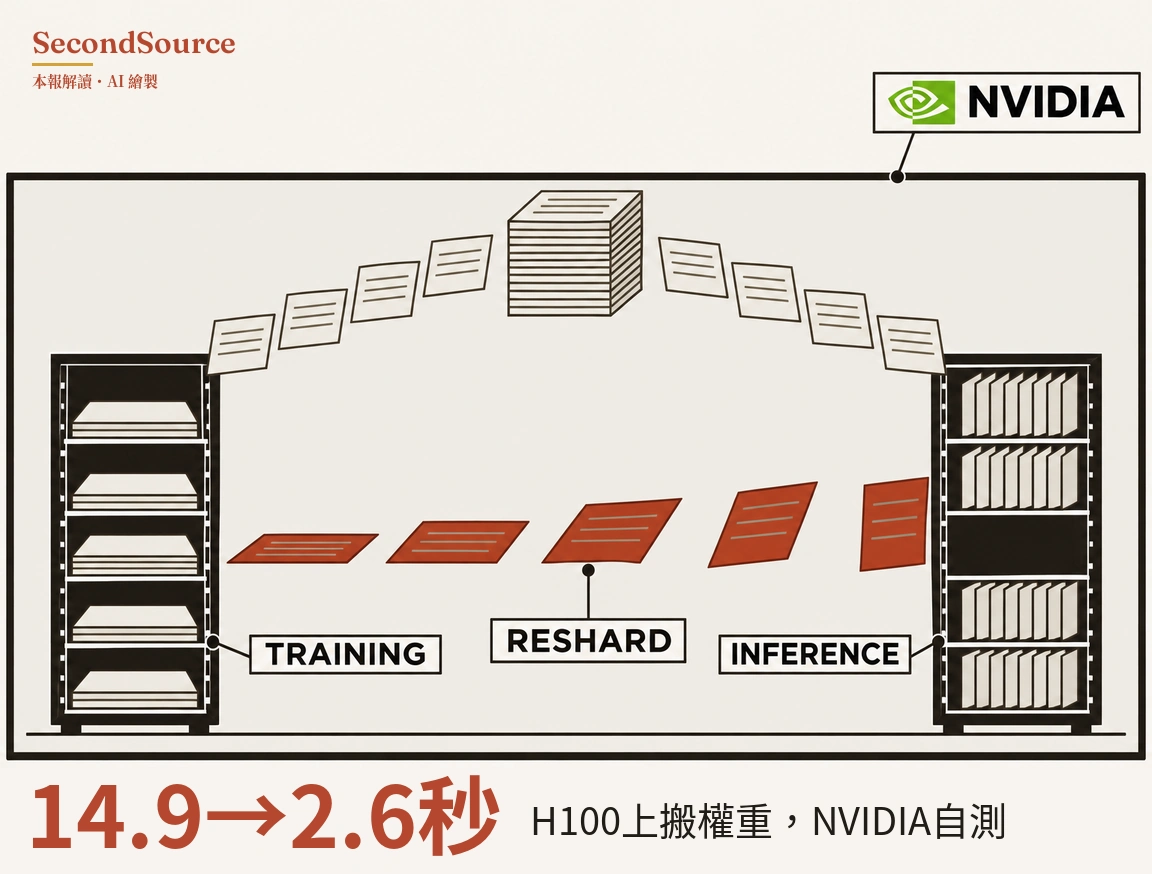
兆參數模型的強化學習,卡在訓練與推論 GPU 之間搬權重;NVIDIA 給了降法,比較對象只有自家舊做法。訓練 GPU 每隔幾步要把新權重搬到切法不同的推論 GPU,NVIDIA 寫這一步對最大的開放權重模型每次約 10 TB 通訊量。Reshard 直接把張量從訓練佈局搬到推論佈局,不先聚合整份參數再廣播。NVIDIA 自測:DGX H100 上 6,710 億參數的 DeepSeek V3,refit 從 14.9 秒降到 2.6 秒;GB200 上同一模型從 6.1 秒降到 2.3 秒,兩組硬體不同,不能把兩個倍數當同一效果。Reshard 的第一個實作放在 NVIDIA 的 nccl-extensions 開源倉庫,標為實驗性;NeMo RL 目前只有部分權重走這條新路。整輪強化學習省多少時間,文章沒給(NVIDIA 技術部落格,2026-11-06)。 怎麼查的 →
出處與查證
這則刊在2026年11月7日的晨報,同一期還有 13 則。查證經過、引句核對與當天缺的資料,記在那一期的本日驗證。
引用這則
SecondSource(2026),〈NVIDIA 推出新的集合通訊函式 Reshard。強化學習每輪訓練後要把新權重搬到推論 GPU,這一步叫 refit;在 NVIDIA 的強化學習訓練框架 NeMo RL 上,refit 時間降到原來的 1/2.7 到 1/5.7,數字是 NVIDIA 自測。〉,https://secondsource.io/news/2026-11-07-4/,取用日期取用。