NVIDIA は新しい集団通信関数 Reshard を出した。強化学習では訓練の各ラウンドのあとに新しい重みを推論用 GPU へ移す必要があり、この工程を refit と呼ぶ。NVIDIA の NeMo RL は強化学習でモデルを訓練するためのフレームワークで、その中で refit の時間は、GB200 では元の約 2.7 分の 1、DGX H100 では約 5.7 分の 1 に縮んだ。数字は NVIDIA の自社テストである。
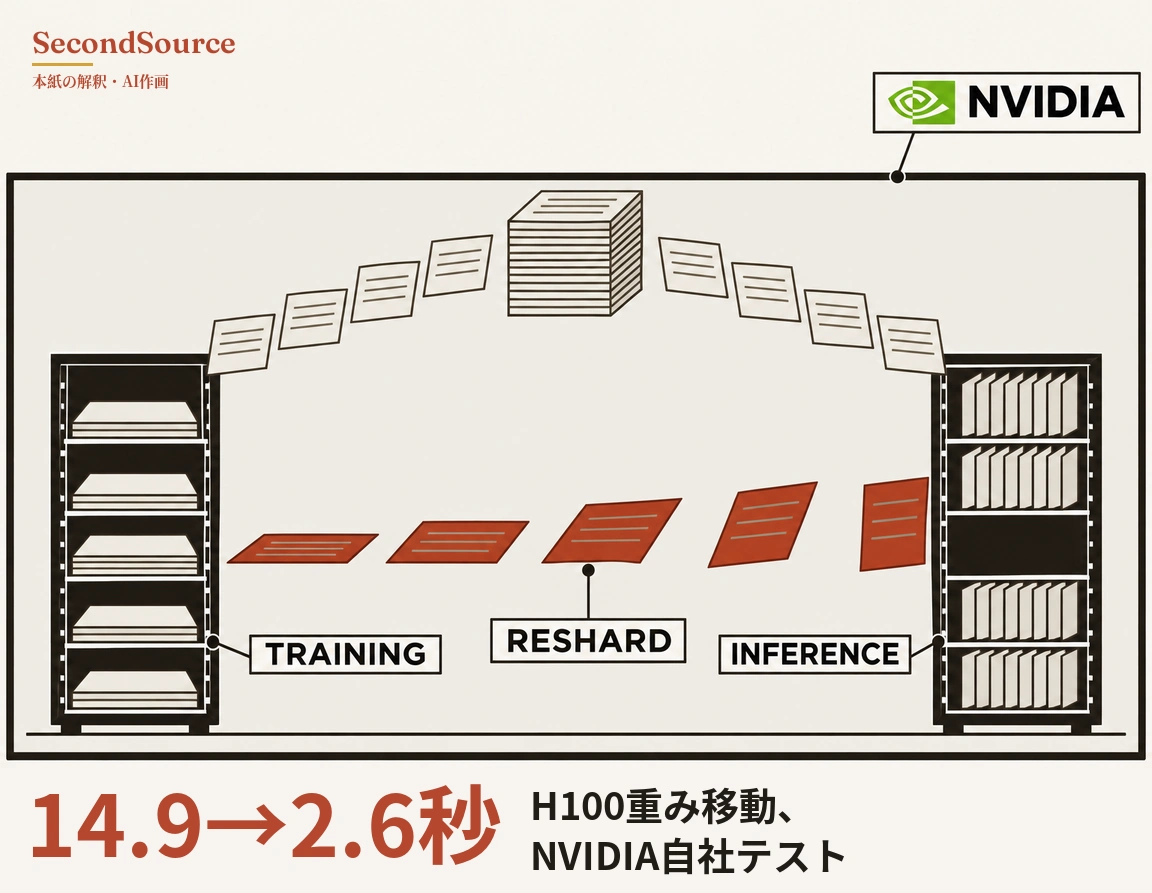
最大級のオープンウェイトモデルの強化学習は訓練用と推論用の GPU の間で重みを移す工程で詰まっており、NVIDIA は短縮の方法を示したが、比較の相手は自社の旧方式だけである。訓練用 GPU は数ステップごとに、分割の仕方が違う推論用 GPU へ新しい重みを移す。NVIDIA によれば、この工程は最大級のオープンウェイトモデルで一回あたり約 10 TB の通信量になる。Reshard は、パラメータ全体をいったん集めてから配る代わりに、テンソルを訓練用の配置から推論用の配置へ直接移す。NVIDIA の自社テストでは、DGX H100 上の 6,710 億パラメータの DeepSeek V3 で refit は 14.9 秒から 2.6 秒に、GB200 上の同じモデルでは 6.1 秒から 2.3 秒になった。二組はハードウェアが違うので、二つの倍率を同じ効果とはみなせない。Reshard の最初の実装は NVIDIA のオープンソースのリポジトリ nccl-extensions にあり、実験的と表示されている。NeMo RL では現在、重みの一部だけがこの新しい経路を通る。強化学習の一ラウンド全体でどれだけ時間が減るかは、記事に書かれていない(NVIDIA 技術ブログ、2026-11-06)。 どう確かめたか →
出典と検証
この記事は2026年11月7日の夕刊に掲載されました(同じ号にほか 13 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「NVIDIA は新しい集団通信関数 Reshard を出した。強化学習では訓練の各ラウンドのあとに新しい重みを推論用 GPU へ移す必要があり、この工程を refit と呼ぶ。NVIDIA の NeMo RL は強化学習でモデルを訓練するためのフレームワークで、その中で refit の時間は、GB200 では元の約 2.7 分の 1、DGX H100 では約 5.7 分の 1 に縮んだ。数字は NVIDIA の自社テストである。」https://secondsource.io/ja/news/2026-11-07-4/ (閲覧日閲覧)