振り返り · 本紙 10 月 8 日の深掘りレポート。Harvey と Baseten の 9 月 8 日の実験
Harvey ら、読んだ量ほど点数が上がる——数字は自己申告
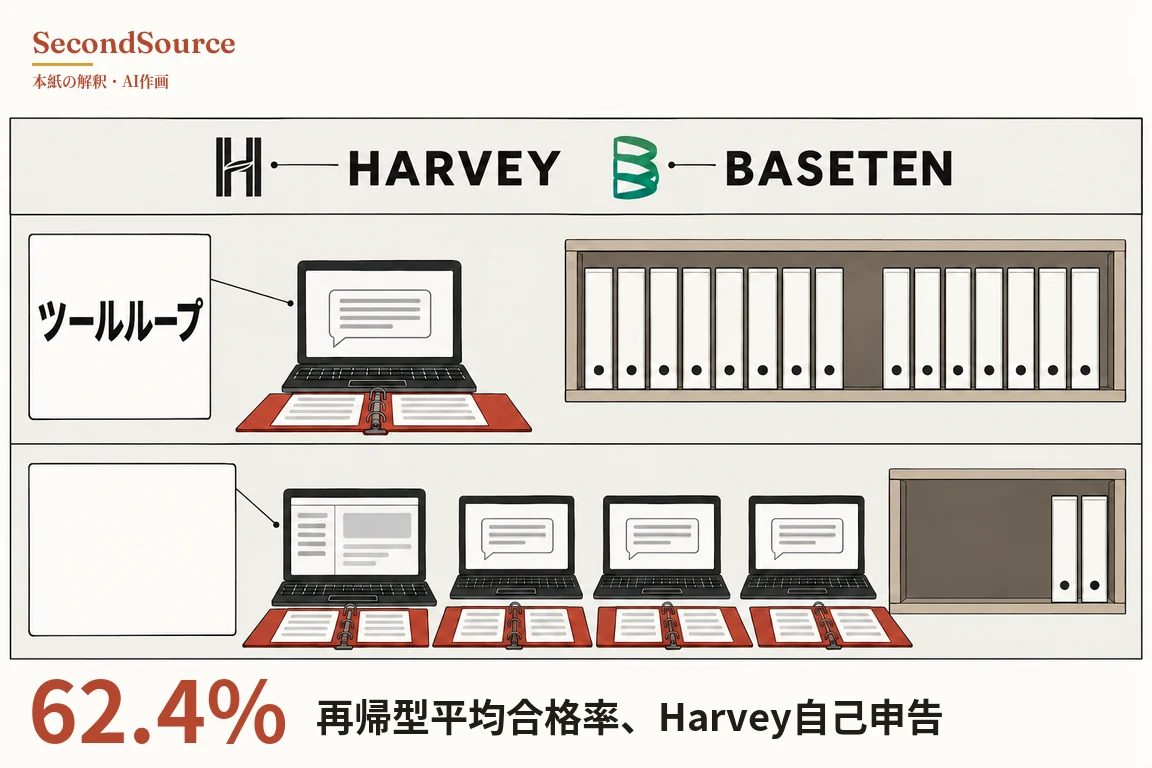
長文書を扱う AI の点数は、データルームを読み込んだ割合とともに上がる。同じ七つのモデルで、再帰型のハーネスを使うと模擬の M&A デューデリジェンスの平均合格率は 62.4%、単純なツールループでは 23.3% だった。 データルームは、M&A のデューデリジェンスで使う大量の文書である。再帰型のハーネスでは、統括役の AI がプログラムを書いてデータルームを分割し、サブエージェントに一つずつ読ませる。法律 AI 企業 Harvey と、AI モデルを動かす推論基盤を提供する Baseten の実測では、単純なツールループは一度もデータルームの 1% を超えて読まず、再帰型のハーネスは多くがほぼ全部を読んだ。読んだ量が多いほど点数は高かった。深掘りレポートは一文ずつ検証し直し、二か所で主張を狭めた。一つ目に、「汎用のエージェントは誤った既定値だ」が成り立つのは、Harvey が与えた最小限の指示の下だけである。Claude Code と Codex はサブエージェントを使えるのに、どちらも使わなかった。独立した学術論文一本は、逆の方向の結果を測っている。二つ目に、Harvey 自身のモデル別の図では、事後学習を施したオープンソースの統括役の AI は 63.0% で、事後学習なしの Opus 5 の 77.6% を下回った。ハーネスのほかに、モデル自体も点数を左右する。採点を担ったのはモデルで、数字は Harvey 単独の自己申告にとどまる。研究上の値であって、実運用の値ではない(本紙の深掘りレポート、2026-10-08)。本紙の読みでは、長文書を扱う AI の点数は、一回ごとにデータルームのどれだけを読み込んだかと合わせて読む必要がある。Claude Code か Codex でサブエージェントを有効にし、同種のデータルームで走らせ直す。それでも専用のハーネスに 20 ポイント以上遅れるなら、「差の主因は読み切っていないこと」という読みは成り立たない。この閾値は本紙が置いたものだ。 どう確かめたか →
出典と検証
この記事は2026年10月20日の夕刊に掲載されました(同じ号にほか 11 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「Harvey ら、読んだ量ほど点数が上がる——数字は自己申告」https://secondsource.io/ja/news/2026-10-20-4/ (閲覧日閲覧)