Anthropic は、エージェントの記憶を作業の合間にまとめ直す dreaming を、Managed Agents の研究プレビュー API にした。同じ研究の自社テストでは、Opus 5 に記憶を付けると CL-Bench のデータベース課題の平均スコアが 0.564 から 0.828 に上がったが、この数字が比べているのは記憶の有無で、dreaming そのものではない。
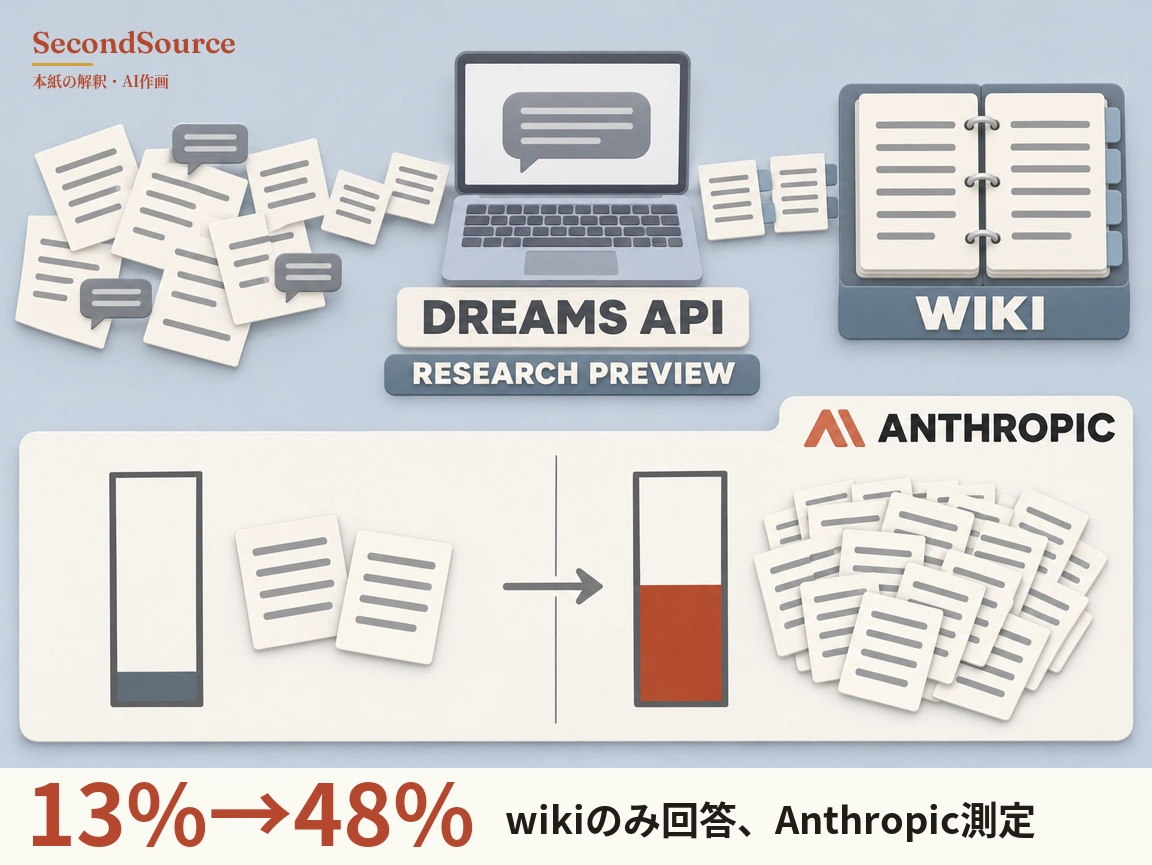
記憶を作業の合間にまとめ直すと推論コストがどれだけ増えるかを Anthropic は示しておらず、Dreams API は選んだモデルのトークン単価で課金される。Anthropic の 11 月 6 日の研究記事は、エージェントの記憶を二つに分ける。作業中にその場でメモを書くことと、作業の合間に元の対話記録を使ってメモを確かめ、まとめ、直し、wiki を作ることで、後者を Anthropic は dreaming と呼ぶ(Anthropic、2026-11-06)。CL-Bench 1.0 はエージェントが記憶を使って長い課題をこなす力を測るベンチマークで、Opus 5 は記憶なしで 0.564、記憶ありで 0.828 だった。Opus 5 に「失敗だけを記録する」という規則を一つ加えると、スコアは逆に 0.234 下がり、記憶による上積みの大半が消えた。dreaming そのもののテストは別の実験である。Anthropic は買収したソフトウェア企業 Stainless の約 35 万件の文書から 25 問を作った。wiki だけで答えたスコアは、dreaming を 2 回のセッションから 128 回に広げるにつれ、13% から 48% に上がった。Dreams API は研究プレビューとして公開され、ゼロデータ保持には対応していない(Dreams のドキュメント)。ベンチマークごとに測るものが違うので、並べて比べることはできない。 どう確かめたか →
出典と検証
この記事は2026年11月7日の夕刊に掲載されました(同じ号にほか 13 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「Anthropic は、エージェントの記憶を作業の合間にまとめ直す dreaming を、Managed Agents の研究プレビュー API にした。同じ研究の自社テストでは、Opus 5 に記憶を付けると CL-Bench のデータベース課題の平均スコアが 0.564 から 0.828 に上がったが、この数字が比べているのは記憶の有無で、dreaming そのものではない。」https://secondsource.io/ja/product/2026-11-07-1/ (閲覧日閲覧)