夕刊 2026年11月3日
Oracle、上限と同額の株と社債を申請、算入されるかは不明
今号の要点
1. Oracle は株式と社債をそれぞれ 100 億米ドル、合わせて 200 億ドル分の発行を届け出た。額は、Oracle が 10 月 28 日に自ら定めた 2030 会計年度までの資金調達の上限と同じである。
2. 半導体の Marvell は、レーザーと光トランシーバーを作る光部品メーカー Lumentum を全額株式交換で買収すると発表した。Lumentum の企業価値は 1,150 億ドルと評価された。
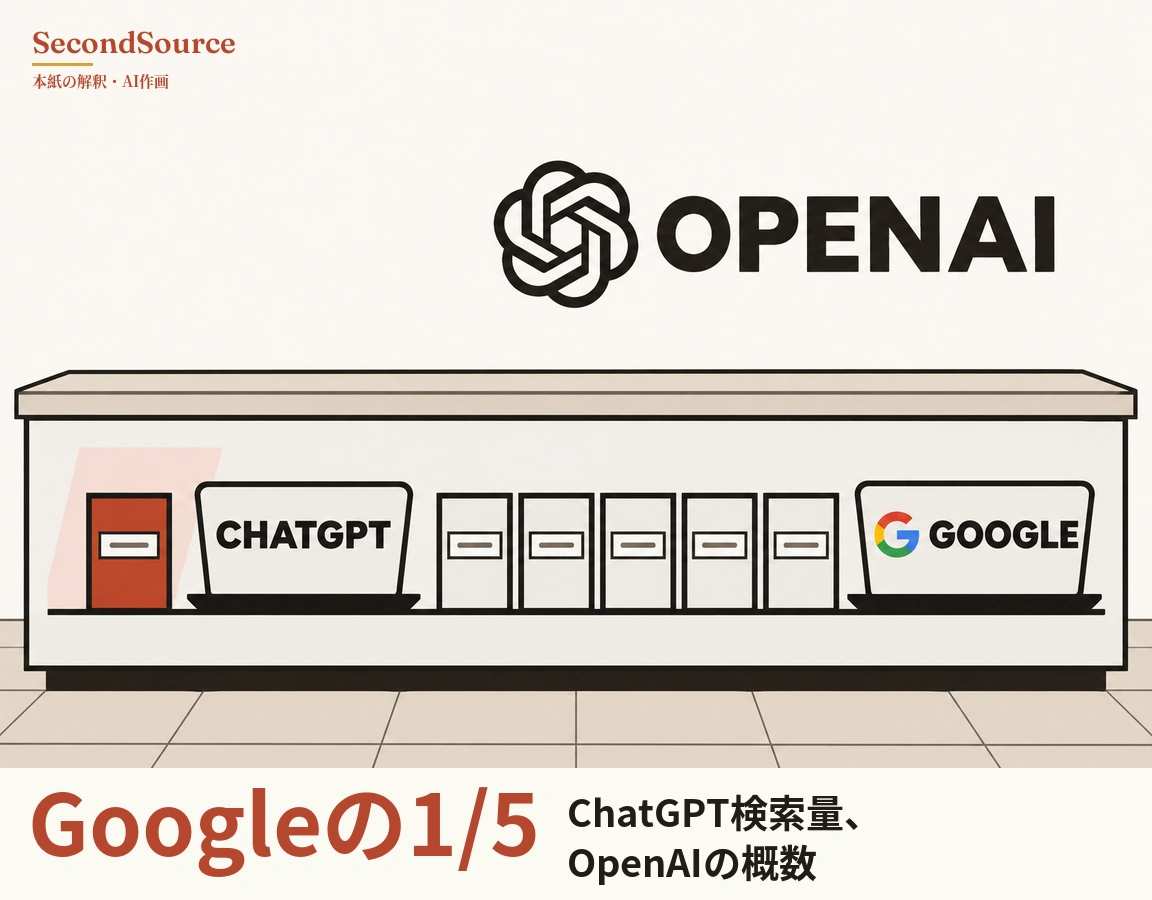
3. OpenAI は、ChatGPT の検索量が Google の約五分の一だと自己申告した。SEO ツール会社の Ahrefs は 2 月、従来 Google で検索されてきたテーマに限って数え、ChatGPT の検索量を Google の約 12% と推計していた。
今日の中核
1. Oracle は株式 100 億米ドルと社債 100 億ドルを同時に届け出て、額は五日前に示した調達の上限と一致した
本紙の推論:二件とも上限に入るなら、Oracle のさらなるデータセンター拡張はキャッシュフロー、前受金、賃借、サプライヤー融資に頼る。
Oracle が 10 月 28 日に示した上限は、額も内訳も今回の届け出とまったく同じである。
Oracle の資金調達の説明は、今年すでに一度変わっている。
Oracle には上限の外に、外部からの調達にあたらない道が二つある。
2. Marvell は光部品メーカーの Lumentum を全額株式で買収すると発表し、Lumentum の企業価値を 1,150 億ドルと評価した
3. OpenAI は記者に ChatGPT の検索量が Google の約五分の一だと伝え、SEO ツール会社 Ahrefs の 2 月の推計は約 12% だった
そのほかに起きたこと(本紙は未検証)
本号に新しい項目はない。
深掘りレポート:AI の新モデルを先に使えるのは誰か——ラボが推薦し、米政府が返信で認めた相手(2026-11-03)
証拠が示すもの: AI ラボの新モデルは、一般公開の前に、少数の信頼できるパートナーが数週間使う。ホワイトハウスの国家サイバー長官室は 6 月末から 9 月中旬にかけて、モデルごとに AI ラボへ書簡を送り、先行利用を認めた信頼できるパートナーを挙げた。これらのパートナーは、ラボが政府に出した顧客の機密名簿から選ばれている。関門は二つある。ラボの推薦と政府の承認で、どちらも外から見えない。本紙の推論:先行利用の枠は、ラボが重視し、しかも米国の国家安全保障の審査を通れる顧客に集まりやすい。
上の書簡の日付と説明は、政府が不開示とした文書の一覧にある。政府が情報公開訴訟で文書を差し止めたとき、理由として添えたものだ。この一覧は文書ごとに日付、件名、差し止めの理由を記したもので、本紙は 11 月 2 日に取り上げた。このレポートが補うのは、外国人による新モデルの利用を制限した商務省の 6 月の輸出管理の書簡、大統領の 6 月の大統領令の原文、そしてホワイトハウスの当局者が 7 月に CNBC に語った反対側の説明である。政府は企業の公開を承認していない、という説明だ。この発言が先行利用の承認まで否定するのか、一般への公開だけを指すのかは、発言からは分からない。
この判断を覆す条件: 2027 年 3 月 31 日までに、裁判所の命令か政府が自ら公開した文書によって、国家サイバー長官室の書簡がラボの名簿を受け取っただけで、どのラボの名簿も削ったり書き換えたりしていなかったと分かれば、「政府の承認」は「政府による受領」に改める。
意味すること: この推論が成り立つなら、新モデルで脆弱性を探すセキュリティ企業は、信頼できるパートナーの名簿に入っていなければ、一般公開までの先行利用の枠から外れる公算が大きい。
チップと半導体
本号にチップと半導体はありません。
Marvell による Lumentum の買収は今日の中核 2 で扱う。
目利きの読み
本号に目利きの読みはありません。
昨夜取得できた番組の書き起こしは 1 本だけで、詳しくは末尾のソースと棚卸しにある。
研究とモデル
1. AWS の 11 月 2 日の週報によれば、OpenAI の GPT-6.1 Terra が Amazon Bedrock で一般提供になり、価格は GPT-6.1 Sol の半額以下である。
過去の洞見
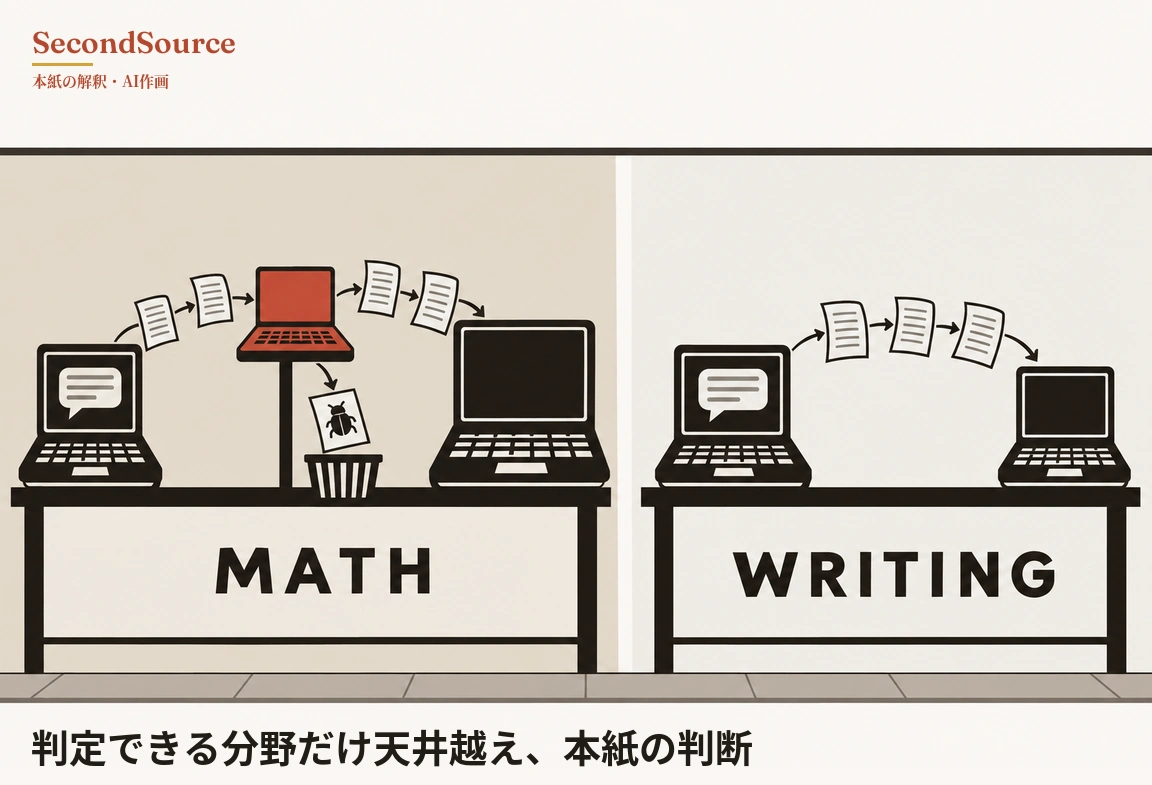
1. [振り返り](本紙 7 月 14 日の判断)合成データに天井があるかについて、本紙は「答えの正誤を自動で判定できるか」で分野を二つに分けた。
学術論文 285 本は、読了 93 本、除外 60 本(うち 1 本は読む前に除外)、手つかず 132 本。SNS 投稿 115 件は、読了 47 件、除外 54 件、登録のみ 4 件、手つかず 10 件。ブログ 34 本は、読了 24 本、除外 10 本。届け出書類 13 本は、読了 12 本、手つかず 1 本。別の取得元の論文 11 本はすべて手つかず。ニュースレター 8 本は、読了 5 本、除外 3 本。外部リンクの記事 3 本と番組の書き起こし 1 本はすべて読了した。
番組の書き起こしが 1 本だけなのは、昨夜の書き起こしの取得に失敗し、YouTube からの取得も成功しなかったためである。中核 1 の Oracle の 2 月のプレスリリースと中核 3 の Ahrefs の推計は、中核の内容を照らし合わせるために別に調べたもので、この 470 本には含まれない。昨夜取得した X のオリジナル投稿は 456 件で、374 アカウントから来ている。上の 115 件とは数え方が別で、互いに換算できない。
あとから補った古い資料。 データベースには一度だけ補った資料がほかにいくつかあり、日付は今年 7 月 1 日から 10 月 30 日までで、上の過去 24 時間の本数とは別に数える。本号ではどれも使っていない。
本号で確認できていないこと。 判断を最も左右するのは Oracle の確定版の目論見書である。仮目論見書では 1 株あたりの価格、各回の利率、最終的な額がまだ空欄で、今回の発行が上限に入るかは目論見書からは分からない。ChatGPT の検索量の数え方は Kantrowitz 氏の投稿で明かされておらず、GPT-6.1 Terra の単価そのものは AWS の週報に書かれていない。本号にマクロ経済の段はない。
本紙が追っているソース。 長期の追跡リストには現在、発信者が特定できる追跡対象が 529 あり、SNS 302、番組 90、ニュース 51、ブログ 48、論文の著者 48、ニュースレター 46 で、残りは決算や基調講演などの経路に散らばる。同じ対象を複数の経路で追っていることがあり、経路ごとの数を足すと 529 を超える。これは追跡対象の数で、上の本数と足し合わせることはできない。昨夜実際に取得した 374 アカウントも、リストにある SNS の 302 とは母集団が違う。代表的な名前は、SNS では Daniel Kokotajlo、Sergey Levine、Arvind Narayanan、Chris Lattner、ブログでは Terence Tao、Lilian Weng で、番組のリストには Sam Altman、Dario Amodei、Demis Hassabis らの出演者がいる。本号の本文で使った外部ソースのリンクは 12 件で、本文で実際に引いた外部のリンクだけを数えた。この 12 件は 529 の追跡対象とは別の数である。台湾側のソースは累計 150 件で、10 月に 43 件、11 月はここまでに 9 件増えた。台湾のメディア、台湾企業の公式発表、台湾の現地記者を数え、台湾メディアを引用した海外メディアは数えない。
本記事は日本語版・英語版・中国語版と同一の調査と判断にもとづいて書かれています。出典にはリンクを付け、原文書と報道を区別し、確かめられなかった点を明記しています。
本紙はニュースのまとめではありません。AI を使って分野横断で一次情報を読み、判断には原文の出典を添え、誤りは訂正ページで公表します。焦点は、どの変化がすでに起きていて、どの主張にまだ裏付けが足りないかであって、今日何が起きたかではありません。