Google Cloud は、Kubernetes が処理を割り当てるときに TPU のクラスターをつなげて大きくしたり分けて小さくしたりできるようにし、起動時間は最大で元の約 1/5 になると自ら説明した。
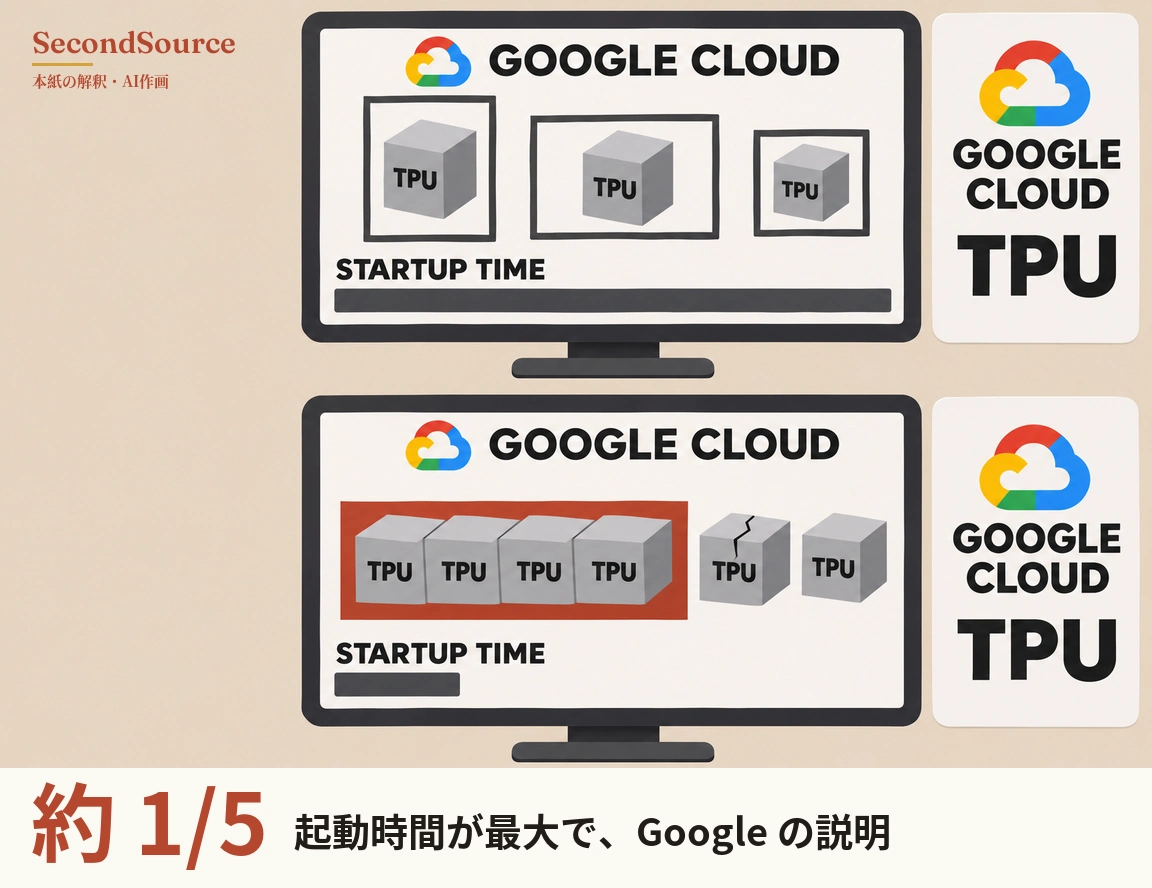
予約した TPU を使うプラットフォームのチームは、トポロジーごとに node pool(決まった仕様のマシンの組)を作らなくてよくなる。ただし起動と復旧の時間の倍率には試験の設定が添えられておらず、使えるのは予約の容量だけである。比較の相手は、TPU の区画ごとに決まった node pool を一つずつ作るやり方である。新機能はすべての TPU の容量を 16 台の仮想マシンからなる立方体に分け、処理を割り当てるときに光信号で接続を切り替える光回路スイッチ(OCS)を使って、立方体をつないで大きな区画にしたり、分けて小さな区画にしたりする。このため、形ごとにマシンの組を前もって用意しなくてよい。Google によると、作業の復旧時間は約 1/4.5 になり、故障したときは壊れた部分だけを交換し、約 1 分から 2 分で済む(Google Cloud、2026-11-09)。オンデマンドの利用や割引価格の Spot の容量では、この機能は使えない。 どう確かめたか →
出典と検証
この記事は2026年11月10日の夕刊に掲載されました(同じ号にほか 12 本)。確認の経緯、引用の照合、その日に確認できなかった資料は、その号の本日の検証にあります。
この記事を引用
SecondSource(2026)「Google Cloud は、Kubernetes が処理を割り当てるときに TPU のクラスターをつなげて大きくしたり分けて小さくしたりできるようにし、起動時間は最大で元の約 1/5 になると自ら説明した。」https://secondsource.io/ja/product/2026-11-10-1/ (閲覧日閲覧)